NCE loss
假设以下语言模型,该模型基于给定的上下文 c 预测词汇表 V 中的单词 w出现在上下文中的概率:
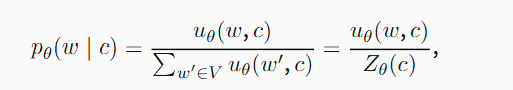
其中评分函数uθ(w, c) = exp sθ(w, c),分母配分函数对词汇表中所有词的非归一化分数进行求和。但是由于V非常大,所以计算此概率的成本很高。
经验分布:p ̃(w | c) 和 p ̃(c)
噪声分布:q(w)。q 一般是均匀分布、经验一元语法分布或"扁平化"的经验一元语法分布
简化方法:NCE
NCE 将语言模型估计问题简化为估计概率二元分类器参数的问题,该分类器使用相同的参数来区分来自经验分布的样本和由噪声分布生成的样本(Gutmann 和 Hyva ̈rinen,2010)。双类训练数据生成如下:从 p ̃(c) 中抽取一个 c,然后从 p ̃(w | c) 中抽取一个"真"样本,辅助标签 D = 1 表示数据点来自真实分布,并从 q 中抽取 k 个"噪声"样本,辅助标签 D = 0 表示这些数据点是噪声。因此,给定 c,(d, w) 在双类数据中的联合概率具有以下两种分布的混合形式:

使用条件概率的定义,这可以转化为在观察到w和c的情况下,d的条件概率:
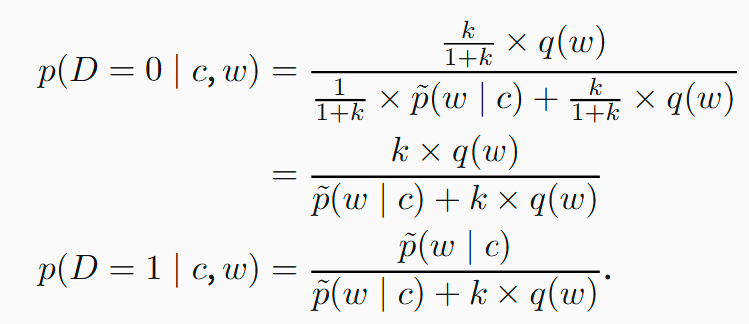
NCE 使用模型分布 pθ(w | c) 替换经验分布 p ̃(w | c),并且选择 θ 以最大化如上所述创建的"代理语料库"的条件似然。但是,到目前为止,我们还没有解决任何计算问题:pθ(w | c) 仍然需要评估配分函数------我们所做的只是通过添加一些噪声来转换目标。为了避免评估配分函数的开销,NCE 提出了两个进一步的假设。
首先,它建议将配分函数值 Z(c) 估计为参数 zc(因此,对于每个 c,经典的 NCE 引入一个参数)。
其次,对于具有大量参数的神经网络,事实证明,对所有 c 固定 zc = 1 是有效的(Mnih 和 Teh,2012)。后一个假设既减少了参数的数量,又鼓励模型具有"自归一化"的输出(即,Z(c) ≈ 1)。在做出这些假设后,我们现在可以用 θ 来表示作为噪声样本或真实分布样本的条件似然,如下所示
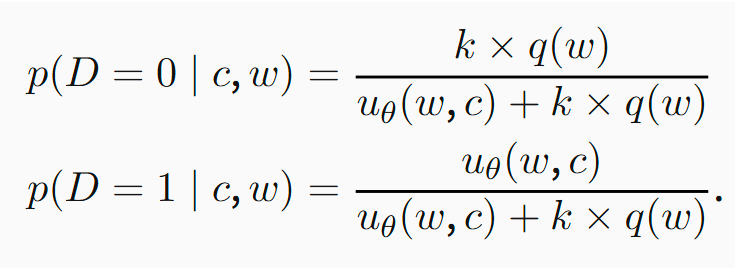
换句话说:
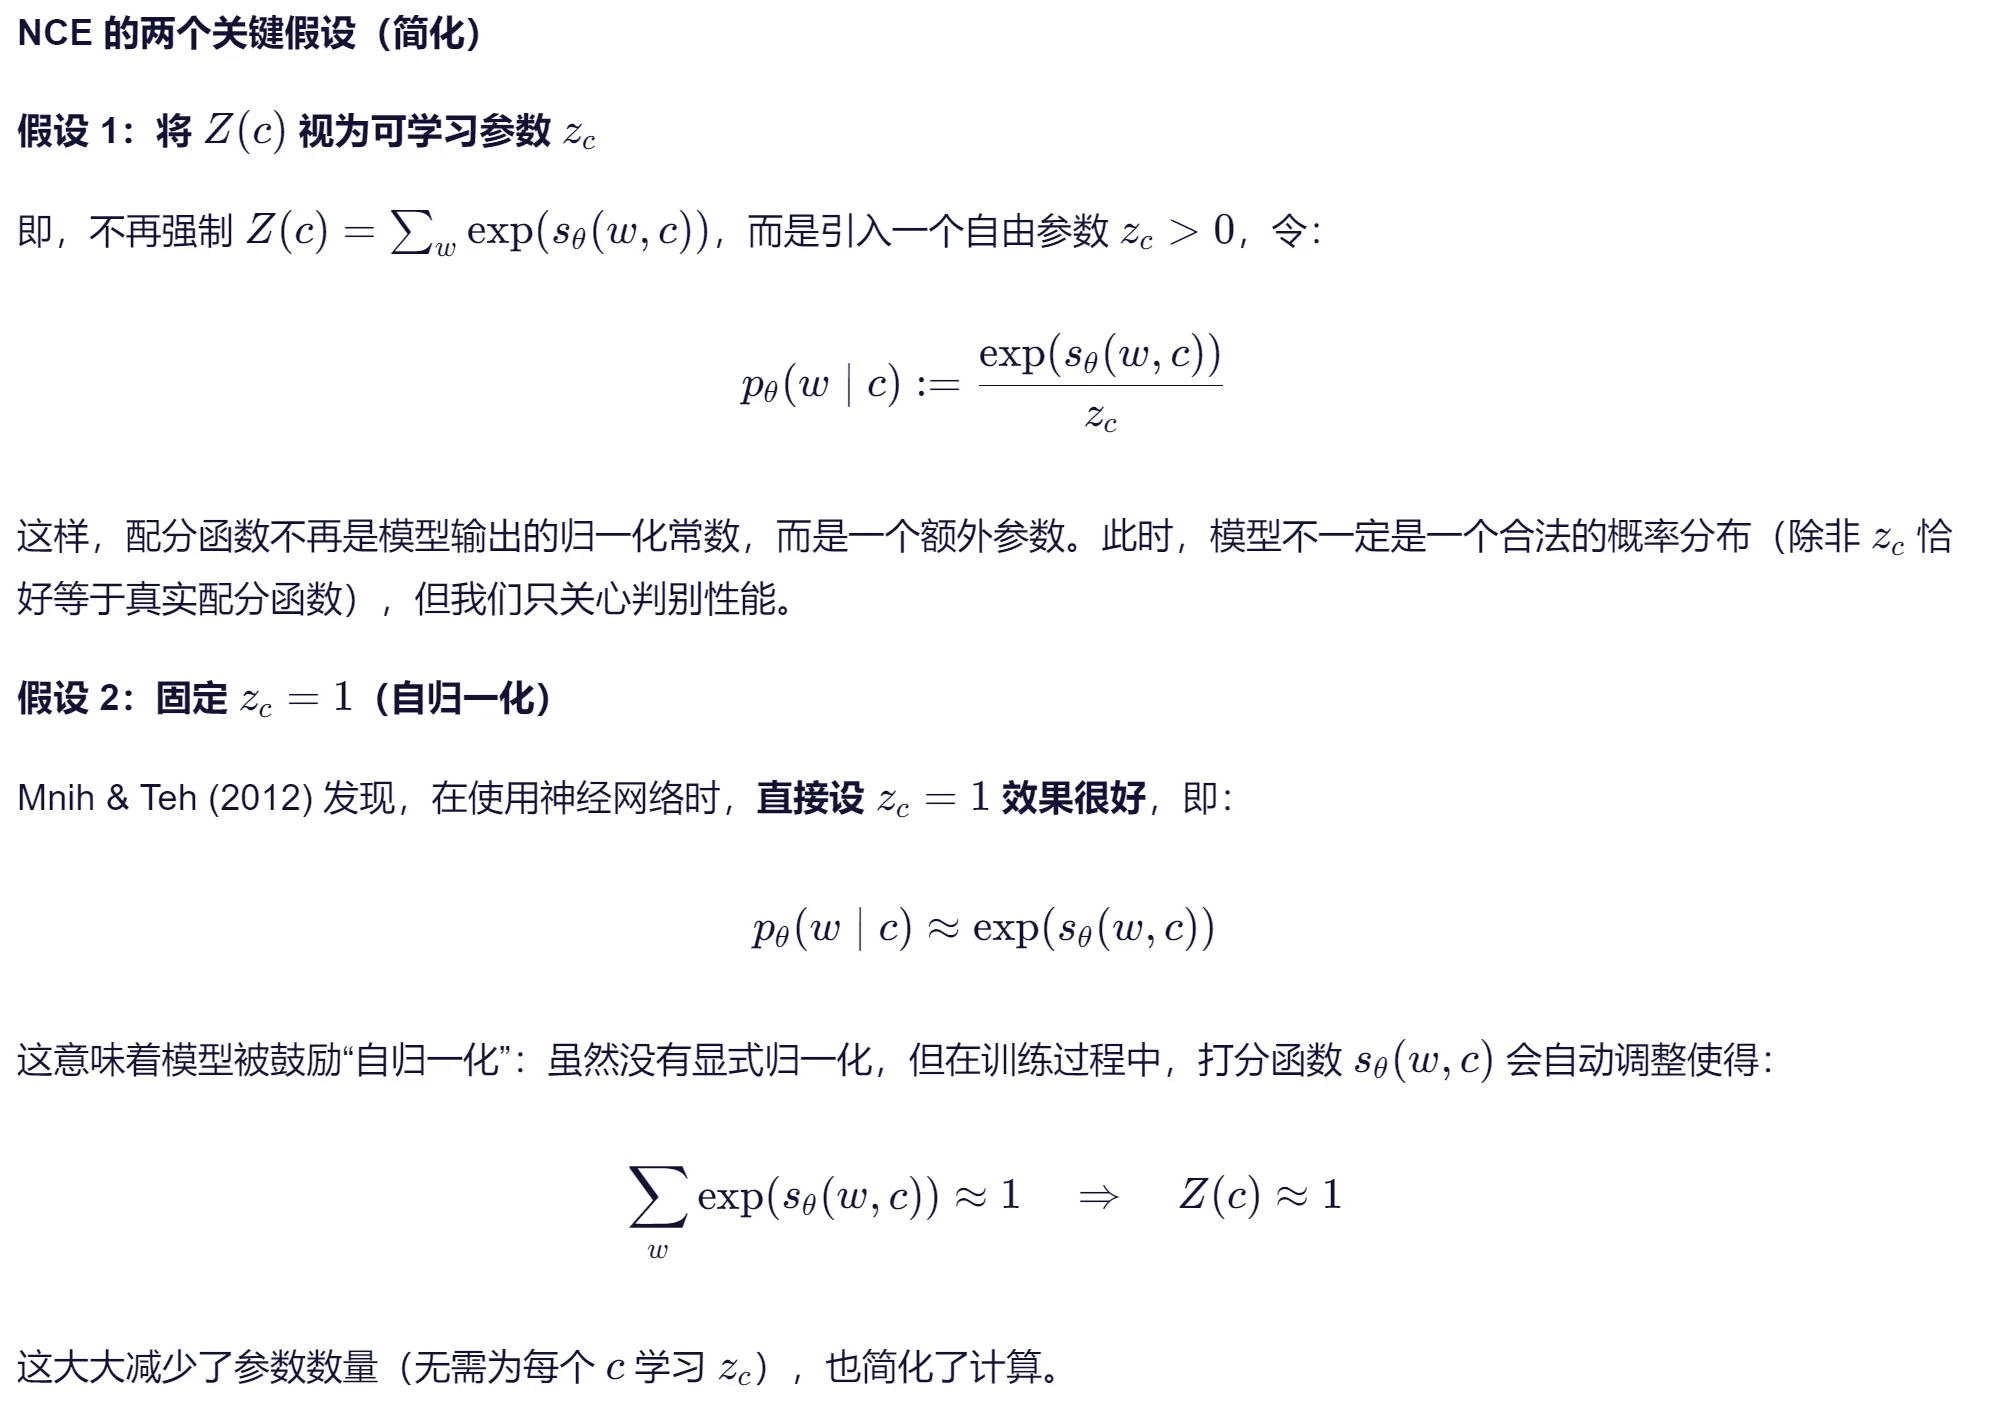
我们现在有一个二元分类问题,其参数为 θ,可以通过训练来最大化 D 的条件对数似然,其中选择了 k 个负样本:
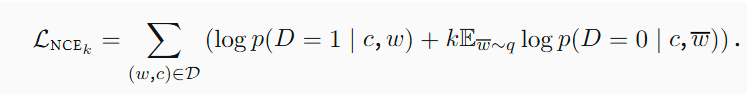
NCE损失鼓励模型为匹配的 (ω,c,D) 分配高概率。
此求和式中第二项的期望仍然是一个困难的求和式------它是k乘以在上下文c中,根据当前模型,在V中所有单词的噪声分布下产生负标签的期望对数概率。我们仍然需要遍历整个词汇表。因此,最后一步是用其蒙特卡罗近似来代替此期望:
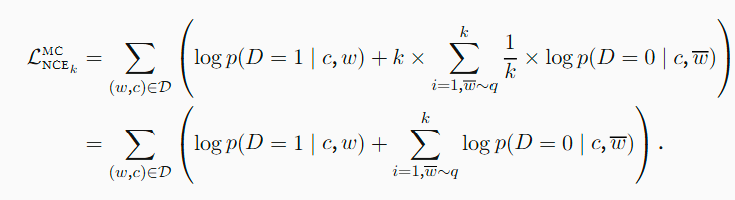
可以证明,当模型分布与经验分布匹配时,梯度为0,因此NCE是渐近无偏的。
渐近无偏: 在许多实际情况中,估计量可能不是严格无偏的,但当样本量趋于无穷大时,它会变得无偏 。这样的估计量就被称为渐近无偏的(Asymptotically Unbiased)。
InfoNCE loss
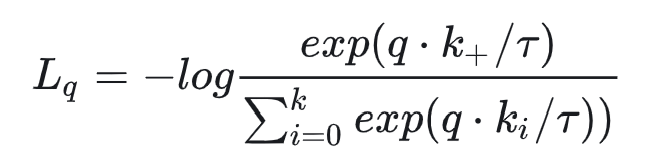
info NCE loss是NCE的一个简单变体,它认为很多噪声样本不是一个类别,因此不是二分类问题而是多分类问题。其中k是数据集中类别的数量,对比NCE loss里面k是负样本的数量。除去温度系数超参数,info NCE就是一个交叉熵损失,本质上就是做一个k+1的分类任务。
Notes on Noise Contrastive Estimation and Negative Sampling
(99+ 封私信 / 80 条消息) 对比学习损失(InfoNCE loss)与交叉熵损失的联系,以及温度系数的作用 - 知乎