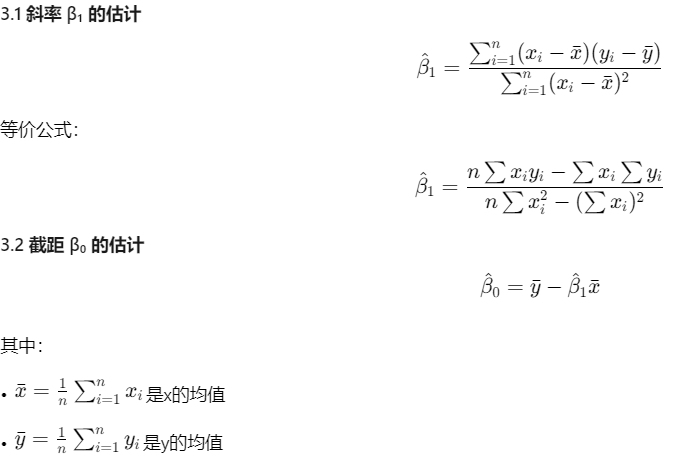
import os
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import stats
from pathlib import Path
import matplotlib

def set_chinese_font():
    """
    设置中文字体,解决中文字符显示问题
    """
    # 获取系统中文字体
    system_fonts = matplotlib.font_manager.findSystemFonts(fontpaths=None, fontext='ttf')
    chinese_fonts = []

    # 常见中文字体名称
    chinese_font_names = ['SimHei', 'Microsoft YaHei', 'SimSun', 'NSimSun', 'FangSong',
                          'KaiTi', 'STSong', 'STKaiti', 'STXihei', 'STZhongsong']

    # 在系统字体中查找中文字体
    for font in system_fonts:
        try:
            font_name = matplotlib.font_manager.FontProperties(fname=font).get_name()
            for chinese_font_name in chinese_font_names:
                if chinese_font_name.lower() in font_name.lower():
                    chinese_fonts.append(font)
        except:
            continue

    # 如果找到中文字体,则使用第一个
    if chinese_fonts:
        try:
            font_path = chinese_fonts[0]
            font_prop = matplotlib.font_manager.FontProperties(fname=font_path)
            font_name = font_prop.get_name()
            matplotlib.rcParams['font.sans-serif'] = [font_name]
            print(f"已设置中文字体: {font_name}")
        except Exception as e:
            print(f"设置中文字体时出错: {e}")
    else:
        # 如果没有找到中文字体,尝试使用默认设置
        print("未找到中文字体,尝试使用默认字体")
        matplotlib.rcParams['font.sans-serif'] = ['SimHei', 'Arial Unicode MS', 'DejaVu Sans']

    # 解决负号显示问题
    matplotlib.rcParams['axes.unicode_minus'] = False

def read_data_from_directory(directory_path):
    """
    读取目录下的所有txt和csv文件
    """
    data_files = []

    # 支持的扩展名
    extensions = ['.txt', '.csv']

    # 遍历目录下的所有文件
    for file_path in Path(directory_path).iterdir():
        if file_path.is_file() and file_path.suffix.lower() in extensions:
            data_files.append(file_path)

    return data_files

def process_file(file_path):
    """
    处理单个文件,读取数据并进行线性拟合
    """
    try:
        # 根据文件扩展名选择读取方式
        if file_path.suffix.lower() == '.csv':
            df = pd.read_csv(file_path)
        else:  # .txt
            # 尝试不同的分隔符
            try:
                df = pd.read_csv(file_path, sep='\t')
            except:
                try:
                    df = pd.read_csv(file_path, sep=',')
                except:
                    df = pd.read_csv(file_path, sep='\s+')  # 空格分隔

        # 检查是否有足够的列
        if len(df.columns) >= 2:
            x = df.iloc[:, 0].values
            y = df.iloc[:, 1].values

            return x, y, file_path.name
        else:
            print(f"文件 {file_path.name} 列数不足,需要至少2列")
            return None, None, None

    except Exception as e:
        print(f"处理文件 {file_path.name} 时出错: {e}")
        return None, None, None

def linear_regression(x, y):
    """
    执行线性回归
    """
    # 使用scipy的stats.linregress进行线性回归
    slope, intercept, r_value, p_value, std_err = stats.linregress(x, y)

    # 计算拟合的y值
    y_fit = slope * x + intercept

    return {
        'slope': slope,
        'intercept': intercept,
        'r_squared': r_value**2,
        'r_value': r_value,
        'p_value': p_value,
        'std_err': std_err,
        'y_fit': y_fit
    }

def plot_results(x, y, regression_results, filename):
    """
    绘制原始数据点和拟合直线
    """
    fig, ax = plt.subplots(figsize=(10, 6))

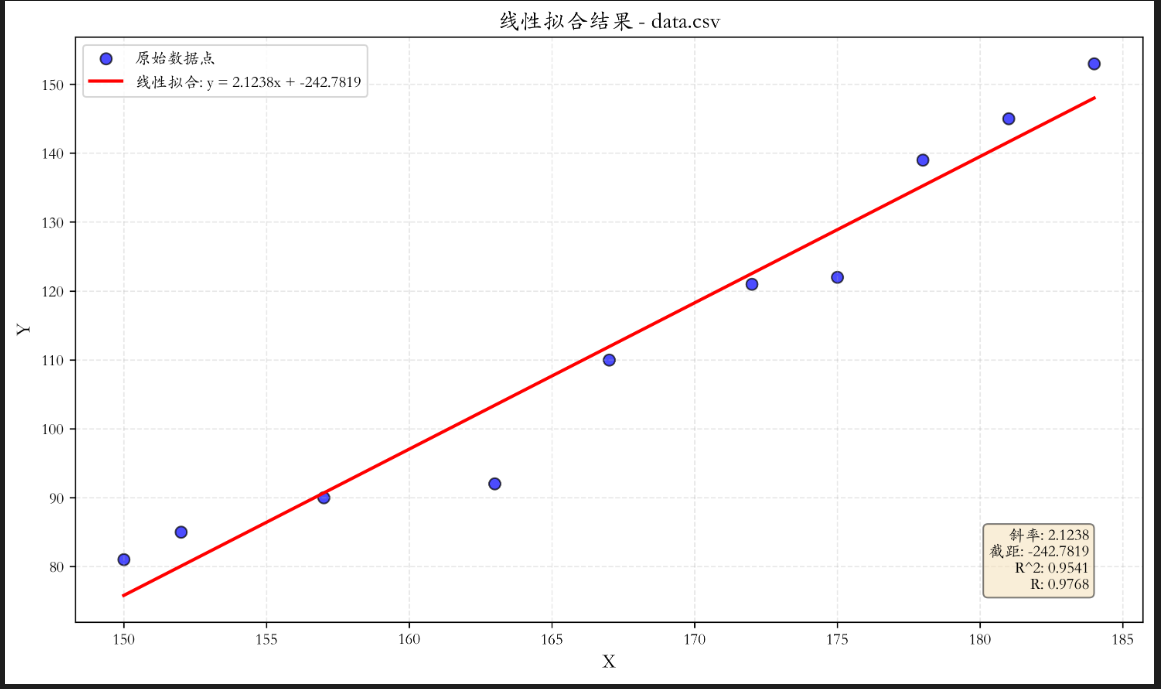
    # 1. 用点描出原始坐标点
    ax.scatter(x, y, color='blue', alpha=0.7, s=50, label='原始数据点', edgecolors='black')

    # 2. 求出线性拟合的直线并绘制出来
    x_line = np.array([min(x), max(x)])
    y_line = regression_results['slope'] * x_line + regression_results['intercept']

    ax.plot(x_line, y_line, color='red', linewidth=2,
            label=f'线性拟合: y = {regression_results["slope"]:.4f}x + {regression_results["intercept"]:.4f}')

    # 添加拟合信息文本 - 放在右上角
    text_str = (f'斜率: {regression_results["slope"]:.4f}\n'
                f'截距: {regression_results["intercept"]:.4f}\n'
                f'R^2: {regression_results["r_squared"]:.4f}\n'
                f'R: {regression_results["r_value"]:.4f}')

    # 添加文本框 - 右上角
    props = dict(boxstyle='round', facecolor='wheat', alpha=0.5)
    ax.text(0.95, 0.05, text_str, transform=ax.transAxes, fontsize=10,
            verticalalignment='bottom', horizontalalignment='right', bbox=props)

    # 设置图表属性
    ax.set_xlabel('X', fontsize=12)
    ax.set_ylabel('Y', fontsize=12)
    ax.set_title(f'线性拟合结果 - {filename}', fontsize=14, fontweight='bold')
    ax.grid(True, alpha=0.3, linestyle='--')
    ax.legend(loc='best')

    plt.tight_layout()
    return fig

def process_all_files(directory_path='.'):
    """
    处理目录下的所有文件
    """
    # 读取目录下的所有数据文件
    data_files = read_data_from_directory(directory_path)

    if not data_files:
        print(f"在目录 '{directory_path}' 中没有找到txt或csv文件")
        return

    print(f"找到 {len(data_files)} 个数据文件:")
    for file in data_files:
        print(f"  - {file.name}")

    # 处理每个文件
    for file_path in data_files:
        print(f"\n处理文件: {file_path.name}")

        # 读取数据
        x, y, filename = process_file(file_path)

        if x is None or y is None:
            continue

        # 检查数据有效性
        if len(x) != len(y):
            print(f"  错误: x和y数据长度不一致 (x: {len(x)}, y: {len(y)})")
            continue

        if len(x) < 2:
            print(f"  错误: 数据点不足,至少需要2个点 (当前: {len(x)})")
            continue

        # 执行线性回归
        print(f"  数据点数: {len(x)}")
        regression_results = linear_regression(x, y)

        # 打印回归结果
        print("  线性回归结果:")
        print(f"    斜率: {regression_results['slope']:.6f}")
        print(f"    截距: {regression_results['intercept']:.6f}")
        print(f"    R²值: {regression_results['r_squared']:.6f}")
        print(f"    R值: {regression_results['r_value']:.6f}")
        print(f"    P值: {regression_results['p_value']:.6f}")
        print(f"    标准误差: {regression_results['std_err']:.6f}")

        # 绘制图形
        fig = plot_results(x, y, regression_results, filename)

        # 保存图形
        output_filename = f"{file_path.stem}_linear_fit.png"
        output_path = Path(directory_path) / output_filename

        try:
            fig.savefig(output_path, dpi=300, bbox_inches='tight')
            print(f"  图形已保存为: {output_path}")
        except Exception as e:
            print(f"  保存图形时出错: {e}")
            # 尝试使用不同的文件名(去除可能的非法字符)
            safe_filename = "".join(c for c in output_filename if c.isalnum() or c in '._- ')
            output_path = Path(directory_path) / safe_filename
            fig.savefig(output_path, dpi=300, bbox_inches='tight')
            print(f"  图形已保存为: {output_path}")

        plt.close(fig)

    print("\n所有文件处理完成!")

def create_sample_data(directory_path='.'):
    """
    创建示例数据文件(仅用于测试)
    """
    # 创建示例txt文件
    np.random.seed(42)
    x = np.linspace(0, 10, 50)
    y = 2.5 * x + 3.0 + np.random.normal(0, 2, 50)

    # 保存为txt文件
    txt_path = Path(directory_path) / "sample_data.txt"
    txt_data = np.column_stack((x, y))
    np.savetxt(txt_path, txt_data, delimiter='\t', header='x\ty', comments='')
    print(f"已创建示例文件: {txt_path}")

    # 创建示例csv文件
    csv_path = Path(directory_path) / "sample_data.csv"
    df = pd.DataFrame({'x': x, 'y': y})
    df.to_csv(csv_path, index=False)
    print(f"已创建示例文件: {csv_path}")

if __name__ == "__main__":
    import argparse

    # 设置中文字体,解决中文显示问题
    set_chinese_font()

    parser = argparse.ArgumentParser(description='对目录下的txt和csv文件进行线性拟合并绘图')
    parser.add_argument('--directory', '-d', default='.',
                       help='要处理的目录路径(默认为当前目录)')
    parser.add_argument('--create-samples', action='store_true',
                       help='创建示例数据文件')

    args = parser.parse_args()

    # 如果需要创建示例文件
    if args.create_samples:
        create_sample_data(args.directory)
        print("\n示例文件创建完成,现在可以运行线性拟合程序。")

    # 处理所有文件
    process_all_files(args.directory)