1、Temperature(温度)
原理:模型计算出下一个token所有可能概率分布后,Temperature会调整这个分布的平滑度。
示例:
llm每次要写一个字时,它会有一张候选词清单,每个词后面都标着模型计算的概率
比如:
"我今天想去------",
清单可能是:
公园(80%)、超市(15%)、月球(5%)
高Temperature(如1.0+):会让低概率的Token更容易被选中,使生成结果更有创造性,可能出现不连贯的词语。
低Temperature(如0.2):会让高概率的token权重更大,使生成结果更稳定、更保守。比如上述,模型几乎只会选择"公园",选"超市"的概率极低,"火星"完全没有机会。
总结:
温度越高:越活跃,llm生成文本多样性高
温度越低:越稳定保守,llm生成文本多样性低
2、Top P(核采样)
原理:设定一个概率阈值(p),然后从高到低累加所有Token的概率,直到总和超过p为止,模型只会在这个累加出来的"核心"词汇表中选择下一个token。
高Top p(如:0.9):候选词汇表大,生成结果多样性
低Top p(如:0.2):候选词汇表小,生成结果稳定,保守
示例:
假设模型要完成句子:"今天天气真..."
模型预测的下一个词可能是:好(60%)、不错(30%)、糟(9%)、可乐(0.01%)。
高Temperature:会提升所有词的概率,使得"可乐"这个不相关的词也有机会被选中。
Top P (设为0.9):会选择概率总和达到90%的词。这里 好(60%) + 不错(30%) = 90%,所以模型只会从"好"和"不错"中
选择,直接排除了"可乐"这种离谱的选项。
如果top p设置0.2:
1、将词汇表里的词,按概率从高到低排序
2、从概率最高的开始累加概率
3、一旦累积概率超过设定的p值(0.2),就停止,并只从这些被选中的词中抽样
按这个步骤计算,候选词里面之后"好"这一个词
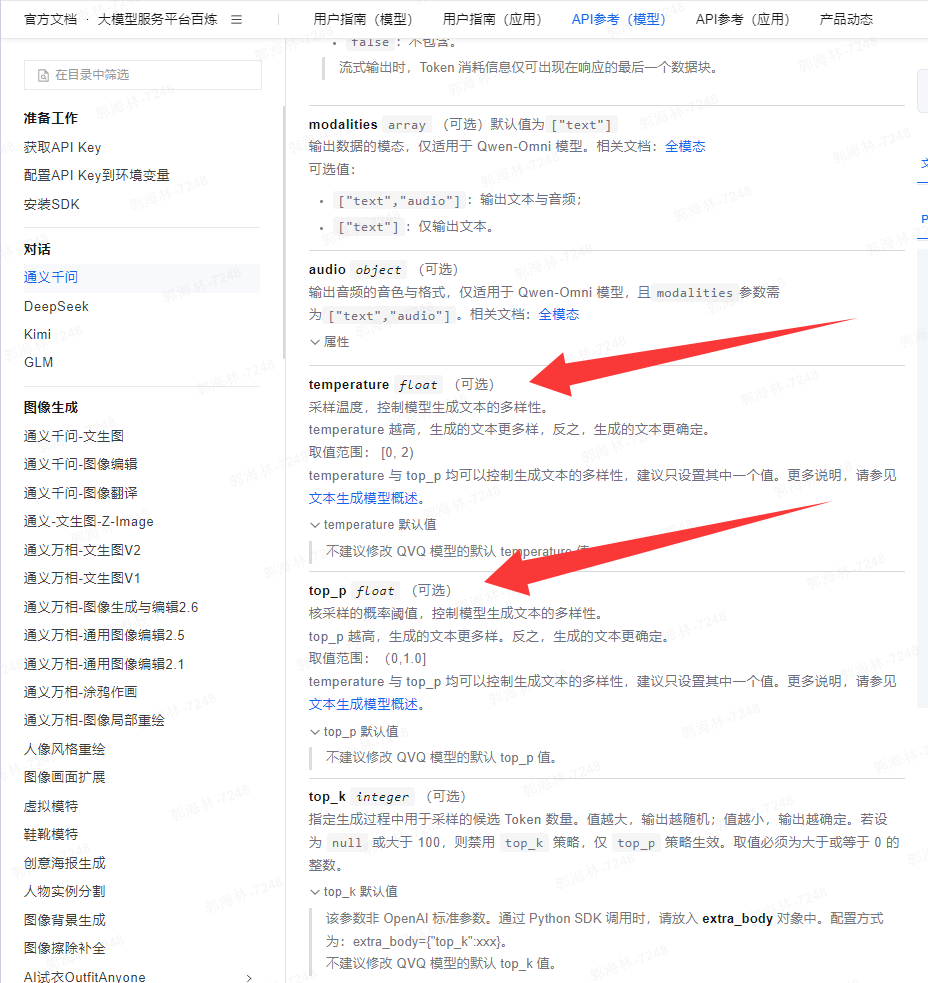
【模型参数官网】
比如通义千问: