参考链接
https://blog.csdn.net/zhou4411781/article/details/119133431
配置
src/main/java/org/apache/hadoop/mapreduce/lib/input/FileInputFormat.java
cpp
  public static final String SPLIT_MAXSIZE =
    "mapreduce.input.fileinputformat.split.maxsize";
  public static final String SPLIT_MINSIZE =
    "mapreduce.input.fileinputformat.split.minsize";
cpp
<property>
  <name>mapreduce.input.fileinputformat.split.minsize</name>
  <value>0</value>
  <description>The minimum size chunk that map input should be split
  into.  Note that some file formats may have minimum split sizes that
  take priority over this setting.</description>
</property>
src/main/java/org/apache/hadoop/mapred/FileInputFormat.java
cpp
      if (length != 0) {
        FileSystem fs = path.getFileSystem(job);
        BlockLocation[] blkLocations;
        if (file instanceof LocatedFileStatus) {
          blkLocations = ((LocatedFileStatus) file).getBlockLocations();
        } else {
          blkLocations = fs.getFileBlockLocations(file, 0, length);
        }
        if (isSplitable(fs, path)) {
          long blockSize = file.getBlockSize();
          long splitSize = computeSplitSize(goalSize, minSize, blockSize);

          long bytesRemaining = length;
          while (((double) bytesRemaining)/splitSize > SPLIT_SLOP) {
            String[][] splitHosts = getSplitHostsAndCachedHosts(blkLocations,
                length-bytesRemaining, splitSize, clusterMap);
            splits.add(makeSplit(path, length-bytesRemaining, splitSize,
                splitHosts[0], splitHosts[1]));
            bytesRemaining -= splitSize;
          }
示例
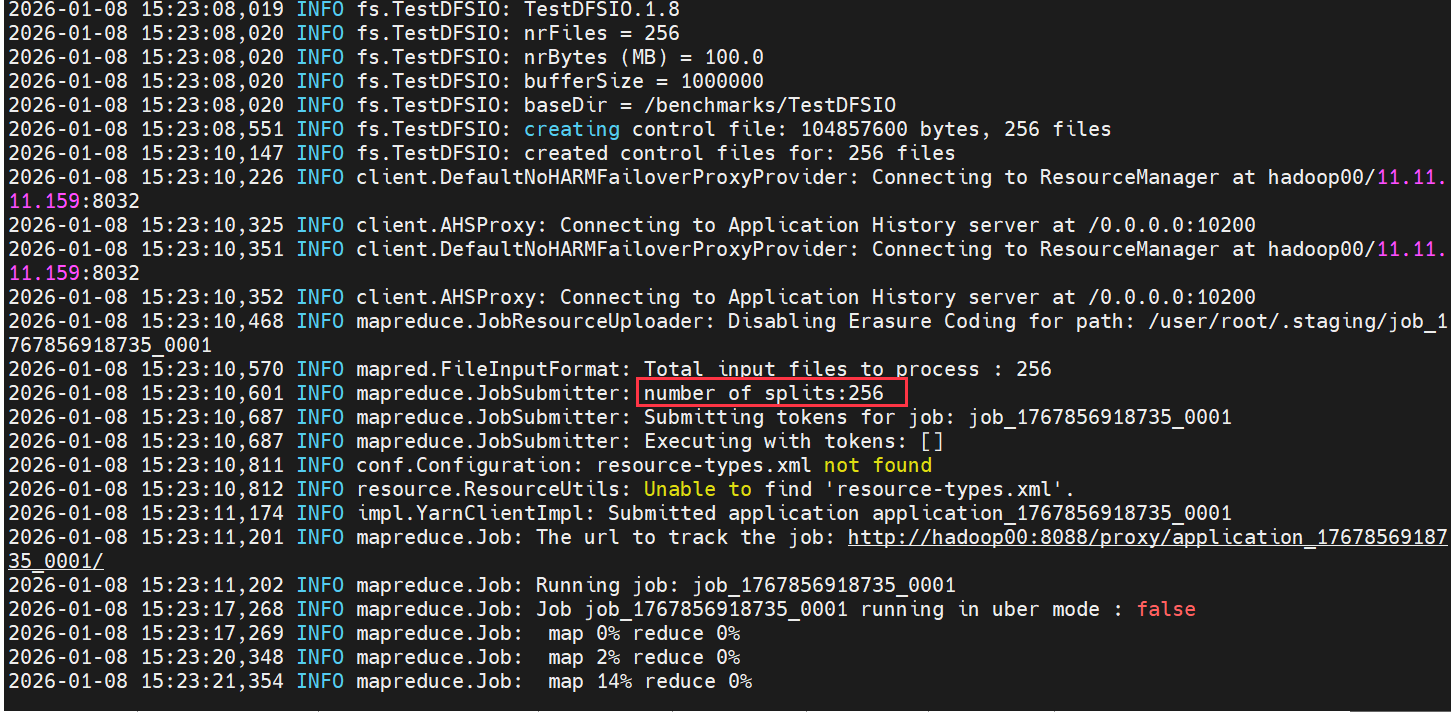
cpp
2026-01-08 15:26:46,125 INFO mapred.FileInputFormat: Total input files to process : 256
2026-01-08 15:26:46,157 INFO mapreduce.JobSubmitter: number of splits:256
cpp
  private void runIOTest(
          Class<? extends Mapper<Text, LongWritable, Text, Text>> mapperClass,
          Path outputDir) throws IOException {
    JobConf job = new JobConf(config, TestDFSIO.class);

    FileInputFormat.setInputPaths(job, getControlDir(config));
    job.setInputFormat(SequenceFileInputFormat.class);