一、背景
随着得物App各业务功能的丰富和升级,得物App内可供用户体验的内容和活动逐步增多,在用户App内体验时长不断增长的大背景下,App使用过程中的体验问题变得愈发重要。同时,在整个功能研发流程中,App端的测试时间相对有限,对于App上的各种场景的体验问题无法实现完全的覆盖,传统的UI自动化回归无法全面满足应用质量保障的需求。特别是在涉及页面交互和用户体验等较为主观的问题时,往往只能依赖于测试人员手动体验相关场景来进行质量保障,整体测试效率较低。
前段时间,我们结合内部的前端页面巡检平台,实现了对App上核心场景和玩法的日常巡检执行能力,对于基础的页面展示问题检查、交互事件检测和图片相似检测等问题已经初步具备有效的检测能力。针对应用体验类问题在传统自动化方式下的检测难题,我们结合AI模型在内部场景应用的经验,开始尝试在App上利用大型模型的分析能力进行巡检,并最终实现得物App智能巡检的应用落地。相较于传统的App质量保障方式,App智能巡检在帮助业务排查应用体验类问题有着极大的优势。
二、架构总览
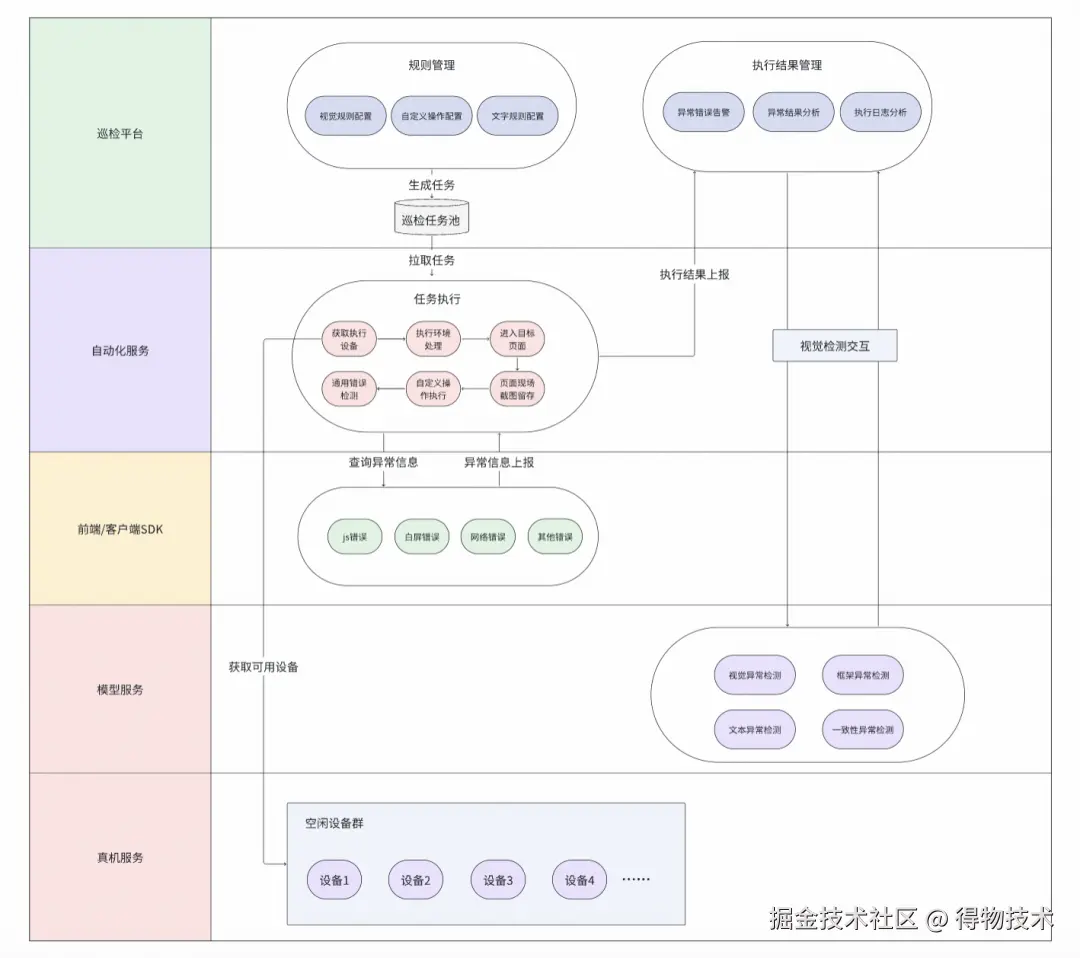
App智能巡检系统架构
在App智能巡检的整个架构流程中,涉及了对于内部多个平台和服务的交互,这些平台和服务在整个流程中的定位不同,各自发挥着不同的作用:
- 巡检平台
巡检平台作为整个智能巡检流程的管理中心,是用户直接能够进行交互的平台,所有用户需要检测的问题、检测的个性化规则、检测的目标场景等都可以在平台上完成。任务执行结束后,平台会对各个服务的执行结果进行汇总,并将结果和异常进行分析过滤,最终对于确定的异常问题会自动告警并通知给用户。
- 自动化服务
自动化服务主要提供了App各端自动化任务执行的基本能力,是工作具体的承担者。在整个任务执行过程中,根据任务的配置信息,自动化服务会依次进行可用真机设备调度、执行环境初始化、进入目标页面、现场AI送检、自定义操作执行、通用异常查询分析等流程,最终将执行结果上报给巡检平台侧,进行结果归档。
- 前端/客户端SDK
为了丰富巡检过程中可以活动到的异常信息和内容,我们和前端以及客户端平台进行合作,对相关检测能力进行了打通,除了执行过程本身可以检测和识别到的错误外,一些系统级别的错误,例如js错误、白屏错误、网络错误等都可以通过对应平台提供的sdk进行获取,相关的检测结果和执行步骤进行了关联绑定,方便用户快速识别异常来源。
- 模型服务
对于视觉类任务的检测主要由模型服务来完成,模型基于用户配置的AI校验规则以及基础的通用检测规则,对执行现场的实时截图进行快速识别分析,对图中可疑的UI问题、交互问题以及不符合用户目标规则的内容进行深入探索,并产出最终的检测结果给到巡检平台。
- 真机服务
真机服务用于提供云端的真机设备,在任务执行过程中,可以根据用户的执行系统、品牌、数量等需要进行空闲设备调度,以满足多设备的智能巡检需要。此外,对于巡检过程中发现的问题,用户可以远程登录对应的真机设备进行快速现场复现,研发修复相关问题后也可以通过真机设备快速验证。
三、主要功能设计
页面结构布局问题检测
在App使用过程中,最常见的UI问题包括页面的展示错位、组件重合或者排盘布局错乱等等,这类问题可以很直观地被用户感受到,直接影响到用户对于App的使用体验,此类问题我们称为页面结构布局问题类问题。
针对此类页面结构布局问题,传统的自动化手段一般缺乏一个统一的判断标准,因此无法在不同页面场景下应用,使用的维护成本也比较高。由于页面现场图片包含了大部分的有效信息,我们这里尝试将整体的页面信息提供给AI模型,让模型基于特定的规则来自动理解图片内容,并基于需要的检测规则来进行问题校验,此功能检测的基本流程如下:
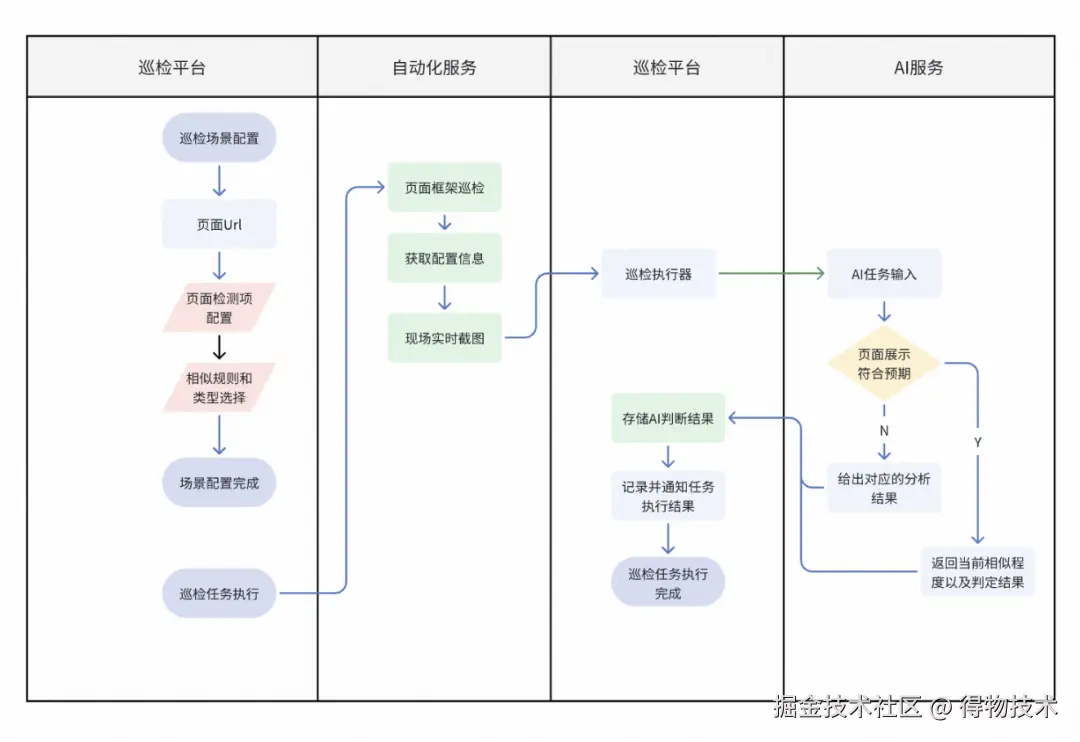
页面结构布局问题检测流程
在功能整体的操作流程中,我们将基础的任务使用场景分成了两大类,针对不同类别的场景,AI检测和理解的侧重点有所不同,最终测试结果判断的标准也会有所不同:
- 页面部分框架是否匹配
用于进行页面布局类检测,比如页面展示的内容、图片、文字、价格等和预期页面是否符合,模型通常会检测页面的元素布局以进行元素级别的匹配。
- 页面完全匹配
用于文本文案展示类页面,校验文本与预期的是否完全保持一致,校验范围包含所有的图片、文字的,一般除了元素级别的匹配,还对整体页面进行了分析对比。
通用视觉体验问题检测
除了前面提到的页面布局问题,App体验和视觉类问题的表现形式实际还有非常多,为了能够覆盖这些不同的场景内容,我们额外设计了一个通用的视觉检测功能,用于更一般性场景的视觉问题分析,具体的校验规则可以由用户自由指定,当然平台也会提供一些默认的通用的规则,用户可以根据实际场景自由组合检测的目标和方式,该检测功能的基本流程如下:
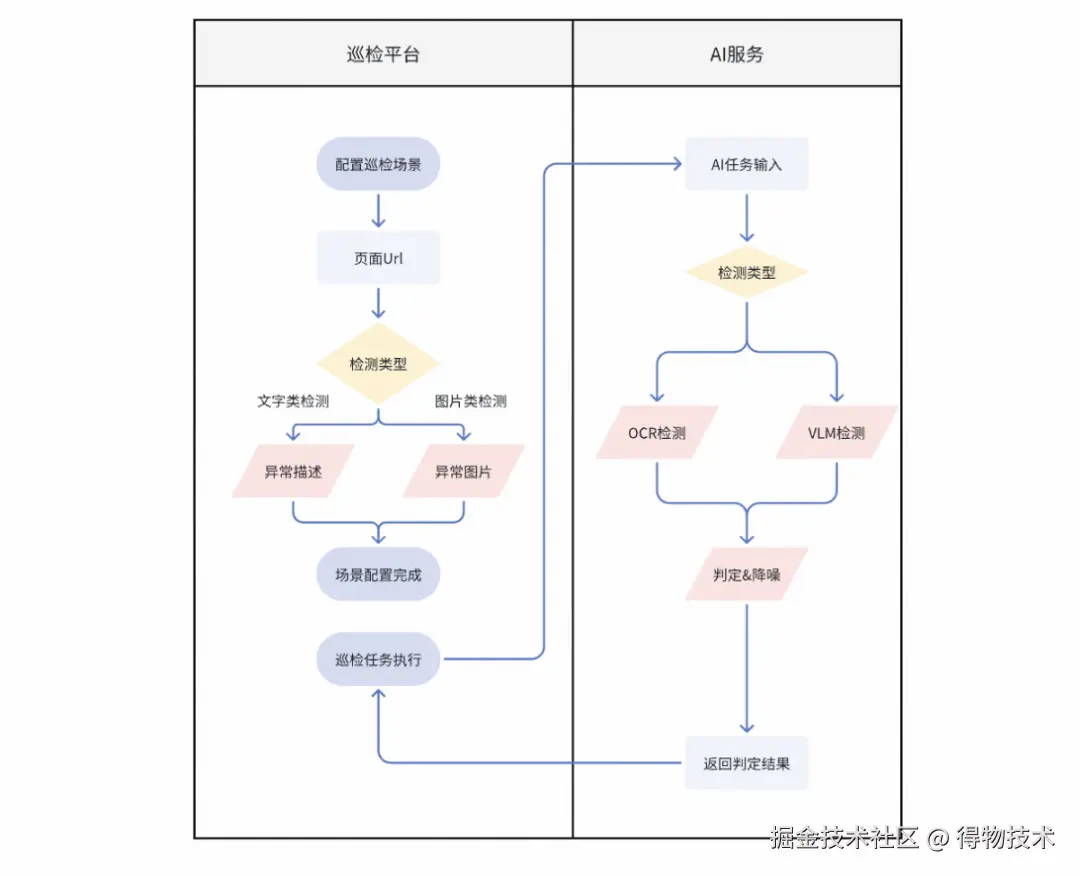
通用视觉体验问题检测流程
在该功能的检测流程中,我们将整体的检验侧重点区分为针对文字和针对图片两类的检测两类,并基于各自的类型进行模型能力的调整:
- 文字类校验
侧重于对页面中文案展示、文字排列、文字顺序等内容的校验,一般会先结合AI理解和ocr技术一起进行结果判断,通常用于文本展示较多的页面。
- 图片类校验
侧重于对页面中展示元素的校验,一般包括所有页面元素的检验,文字相关校验的校验同样包括在内,但侧重点权重有所不同,结果会基于AI理解页面后产生,通常用于元素、图标、页面交互等丰富的页面场景。
页面展示一致性检测
前面两个检测能力都是针对单页面的异常问题检测,目前,得物App上的不同业务页面比较复杂,通用用户需要在多个不同页面中跳转,在这种情况下,会出现不同页面中的UI信息展示的是否符合预期标准的问题。此类UI问题由于设计多个页面,不同的页面可能由不同的业务团队和测试团队负责,其本身也没有固定的出现规律,一般只有依赖测试人员手工进行测试执行时随机发现,而且无法保障相关场景功能的覆盖面。
针对上述这种设计多页面的UI问题,我们经过分析后发现,在利用AI模型的基础上,解决该问题的关键是要理解目标商品或者展示之间的对应关系,同时在后续测试流程中保留这个关联信息,最终结合不同页面的现场信息和关联关系进行问题分析。我们基于此设计了一套页面展示一致性检测功能,该功能的整体流程如下:

页面展示一致性检测流程
相较于单页面的视觉体验问题检测,这类涉及多页面的UI问题检测有几个关键的差异点:
- 检验层级和目标发现
由于整个检测流程涉及多级页面,在检测过程中需要判断检测的最终层级,防止对比页面不完全的问题,同时针对需要对比的商品内容,需要实时维护多级页面的对应展示关系,避免对比的对象出现差异。
- 多级操作定位
在自动化执行过程中,由于后面层级的页面没有可靠的定位对比信息,我们采用了模型来识图定位,即用上级页面的目标图片来定位当前页面是否存在相同的目标,这个过程中要对相似的目标图片进行过滤和识别。
- 多级页面对比分析
最终的分析结果依赖多级页面的现场截图信息和规则进行校验和对比,最终得到整个多级页面场景下的一致性分析结果。
AI操作与异常(无响应)检测
前置操作
除了直接对目标页面进行检测的场景,还有些目标入口可能无法直接到达,比如展示位置在目标页面某个板块,这个板块需要下滑动多屏距离才会展示。针对这种场景,我们引入了AI自动化操作能力,用户可以利用简短的语言描述对应的前置操作步骤,在实际任务执行时,AI会识别这些描述来完成相应的操作指令,在所有操作执行完成后,才进行其他视觉体验功能的智能巡检。该功能的执行流程如下:
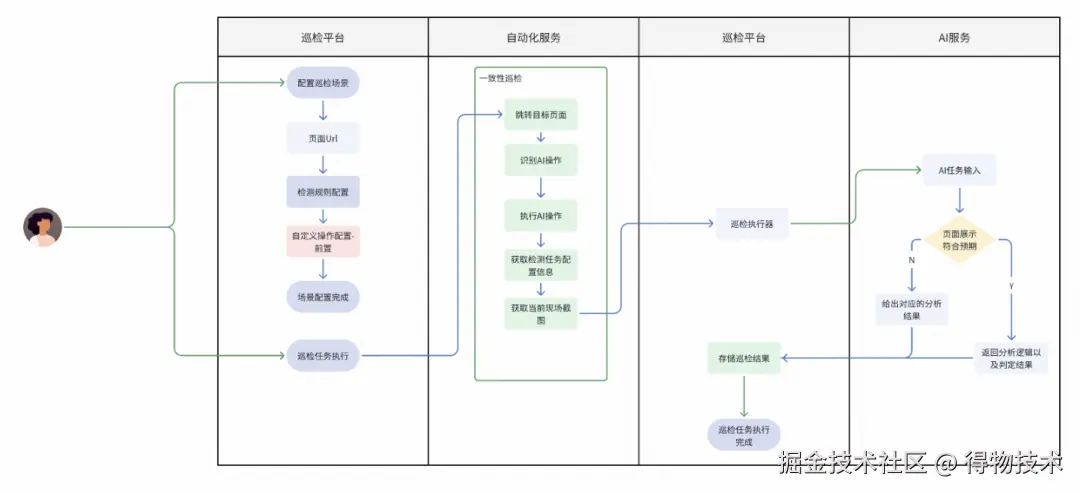
前置AI操作任务流程
基于AI实现自然语言描述到实际操作的方式,我们参考业界一些实践的例子和开源的方案,最终采用AI模型完成操作分析和UI自动化框架完成操作执行的方式,在接入大模型的方式下(而且是开源免费的大模型,如果自建服务,token的耗费成本基本可以忽略),由于大模型本身有多模态能力,具备NLP、图像识别、目标定位、分类、检测,通过持续的对Prompt进行优化,就可以实现智能的UI自动化执行,实现大致的架构如下:
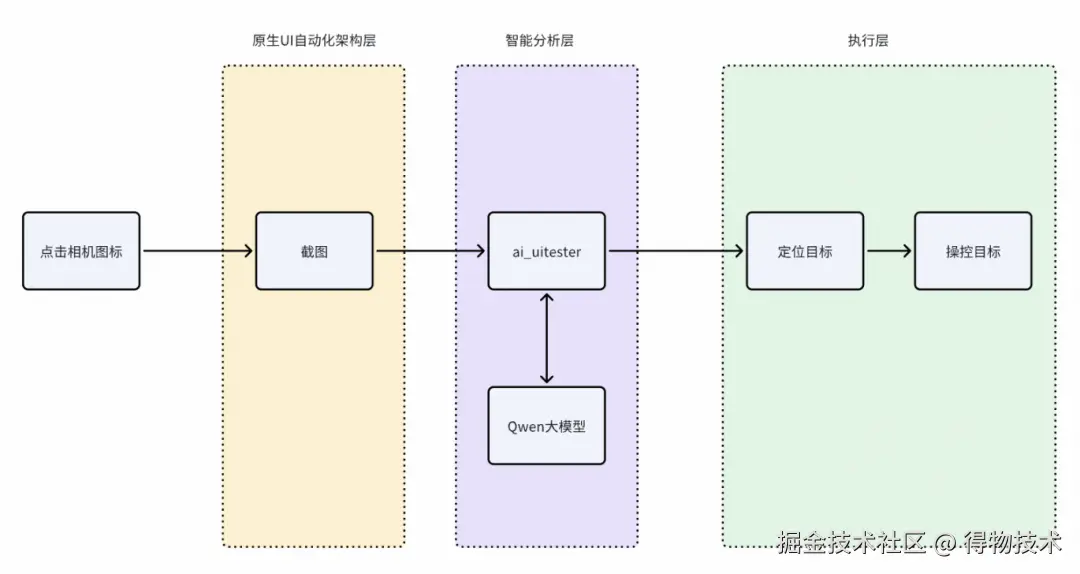
智能UI自动化架构图
具体的实现原理这里不进行详细的介绍,我们通过一个核心的能力实现简单分析下实现流程:
1.模型相关实现
python
import json
from openai import OpenAI
from ..config.llm_config import LLMConfig
from ..utils import get_logger
class ChatClient:
    #模型初始化
    def __init__(self, config_path=None, model_log_path=None):
        self.logger = get_logger(log_file=model_log_path)
        self.config = LLMConfig(config_path)
        self.openai = OpenAI(
            api_key=self.config.openai_api_key,
            base_url=self.config.openai_api_base,
        )
    def chat(self, prompt_data):
        #模型交互,提交截图和任务描述
        chat_response = self.openai.chat.completions.create(
            model=self.config.model,
            messages=prompt_data,
            max_tokens=self.config.max_tokens,
            temperature=self.config.temperature,
            extra_body={
                "vl_high_resolution_images": True,
            }
        )
        result = chat_response.choices[0].message.content
        json_str_result = result.replace("```json", "").replace("```", "")
        try:
            res_obj = json.loads(json_str_result)
            return res_obj
        except Exception as err:
            self.logger.info(f"LLM response err: {err}")


        #异常数据修复
        try:
            import json_repair
            res_obj = json_repair.repair_json(json_str_result, return_objects=True)
            return res_obj
        except Exception as err:
            self.logger.info(f"LLM response json_repair err: {err}")
        try:
            import re
            #返回的bbox处理
            if "bbox" in json_str_result:
                while re.search(r"\d+\s+\d+", json_str_result):
                    json_str_result = re.sub(r"(\d+)\s+(\d+)", r"\1,\2", json_str_result)
            res_obj = json.loads(json_str_result)
            return res_obj
        except Exception as err:
            self.logger.info(f"LLM response re.search err: {err}")
2.点击操作实现
python
def ai_tap(self, description):
    screenshot_base64 = self.get_resized_screenshot_as_base64()
    ret = {
        "screenshot": screenshot_base64,
    }
    prompt = Tap(description).get_prompt(screenshot_base64)
    res_obj = self.chat_client.chat(prompt)
    if "errors" in res_obj and res_obj["errors"]:
        ret["result"] = False
        ret["message"] = res_obj["errors"]
    else:
        #返回的bbox处理为实际坐标
        x, y = self.get_center_point(res_obj["bbox"])
        #进行具体的自动化操作
        self._click(x, y)
        ret["location"] = {"x": x, "y": y}
        ret["result"] =  True
        ret["message"] = ""
    return ret
独立路径校验操作
当然,AI操作配置也可以作为单独的功能校验逻辑,放在视觉任务检测后面去执行,此时操作执行的逻辑与其他任务相对独立,如果操作执行过程中出现错误同样会上报。
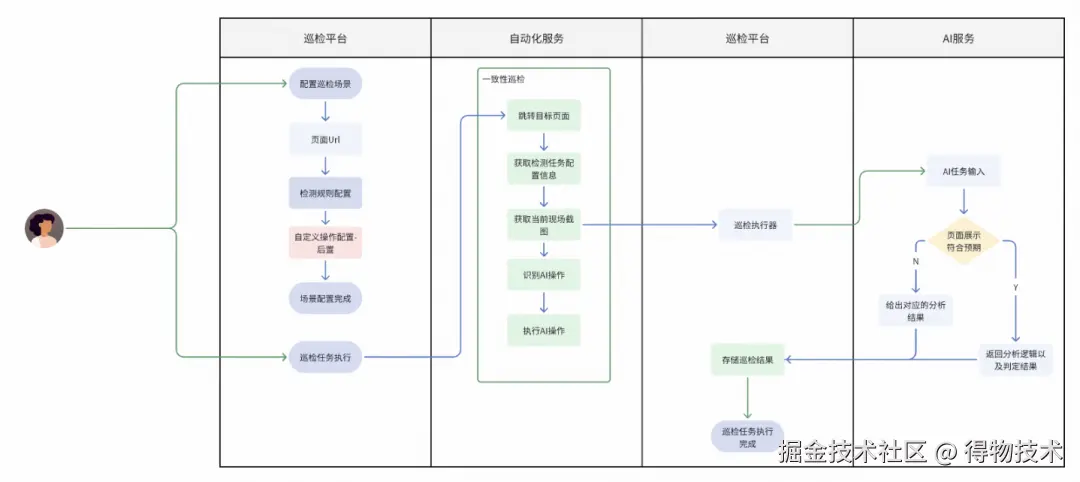
独立路径校验流程
操作无响应检测
在自动化的操作过程中,我们还需要关注操作本身是否是生效的,否则无法保证整个执行链路的完成,操作本身的有效性需要通过额外的方式来保障。在一些实际场景中,App内的一些点击操作也可能出现无响应的情况,这可能是设计问题,也可能是网络或者响应问题,总的来说,这也属于一种实际使用过程中的体验类问题。因此,在原有的执行流程中,我们引入了额外的差异分析模块,用于保证操作的有效完成。
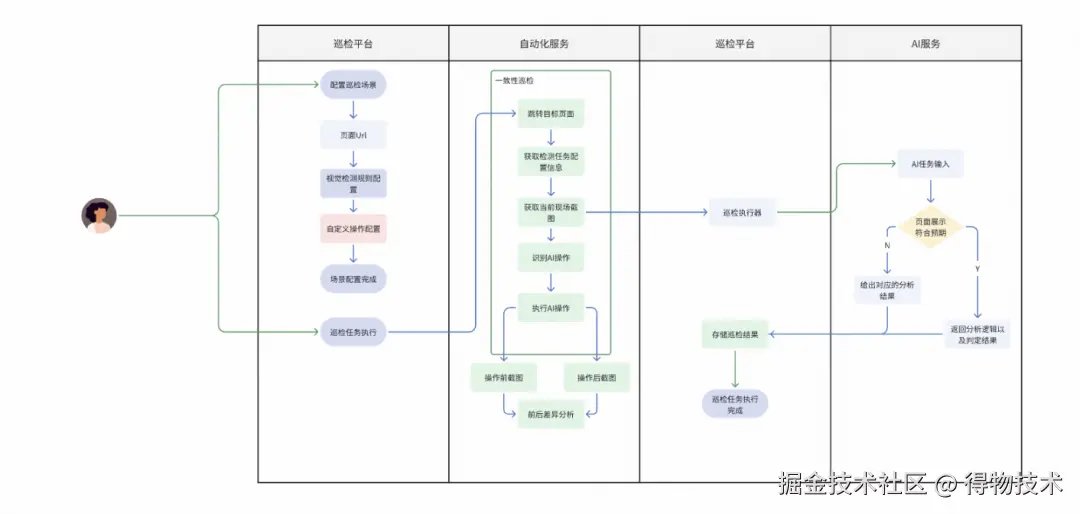
操作无响应检测流程
在操作有效性的保障方案上,我们对比了图像像素处理和模型分析对比两种方式,从分析结果来看,两者的分析结果都能满足我们实际的场景需要,考虑到成本因素,大部分场景下我们会优先采用基于图像像素对比的方式,在一些判断结果无法满足的场景中,我们再使用模型来分析:
ini
def check_operation_valid(screen_path_before, screen_path_after, cur_ops, screen_oss_path_before,
                          screen_oss_path_after):
    try:
        import cv2
        import numpy as np
        img_before = cv2.imread(screen_path_before)
        img_after = cv2.imread(screen_path_after)
        if img_before is None or img_after is None:
            raise RuntimeError(f"操作响应校验读取图片异常")
        # 确保两张图片大小相同
        if img_before.shape != img_after.shape:
            img_after = cv2.resize(img_after, (img_before.shape[1], img_before.shape[0]))
        # 转换为灰度图
        gray_before = cv2.cvtColor(img_before, cv2.COLOR_BGR2GRAY)
        gray_after = cv2.cvtColor(img_after, cv2.COLOR_BGR2GRAY)
        # 计算直方图
        hist_before = cv2.calcHist([gray_before], [0], None, [256], [0, 256])
        hist_after = cv2.calcHist([gray_after], [0], None, [256], [0, 256])
        # 归一化直方图
        hist_before = cv2.normalize(hist_before, hist_before).flatten()
        hist_after = cv2.normalize(hist_after, hist_after).flatten()
        # 计算相关系数 (范围[-1, 1],1表示完全相同)
        correlation = cv2.compareHist(hist_before, hist_after, cv2.HISTCMP_CORREL)
        # 计算卡方距离 (范围[0, ∞],0表示完全相同)
        chi_square = cv2.compareHist(hist_before, hist_after, cv2.HISTCMP_CHISQR)
        # 计算交集 (范围[0, 1],1表示完全相同)
        intersection = cv2.compareHist(hist_before, hist_after, cv2.HISTCMP_INTERSECT)
        # 设置相关系数阈值,超过此阈值视为两张图一致
        threshold = Thres
        threshold_chi_square = Thres_chi
        if correlation > threshold and chi_square < threshold_chi_square and intersection > threshold:
            raise RuntimeError(f"当前操作:{cur_ops} 疑似无效")
    except Exception as e:
        raise e
四、平台建设与使用
平台配置
基础规则配置
对于上述不同的检测类型和功能,在巡检平台上可以进行目标检测规则的创建和管理,所有的巡检场景和任务可以共同使用这些规则。
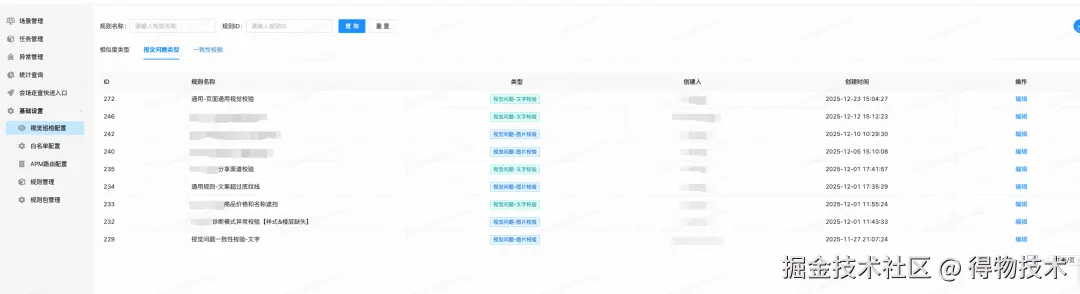
配置项
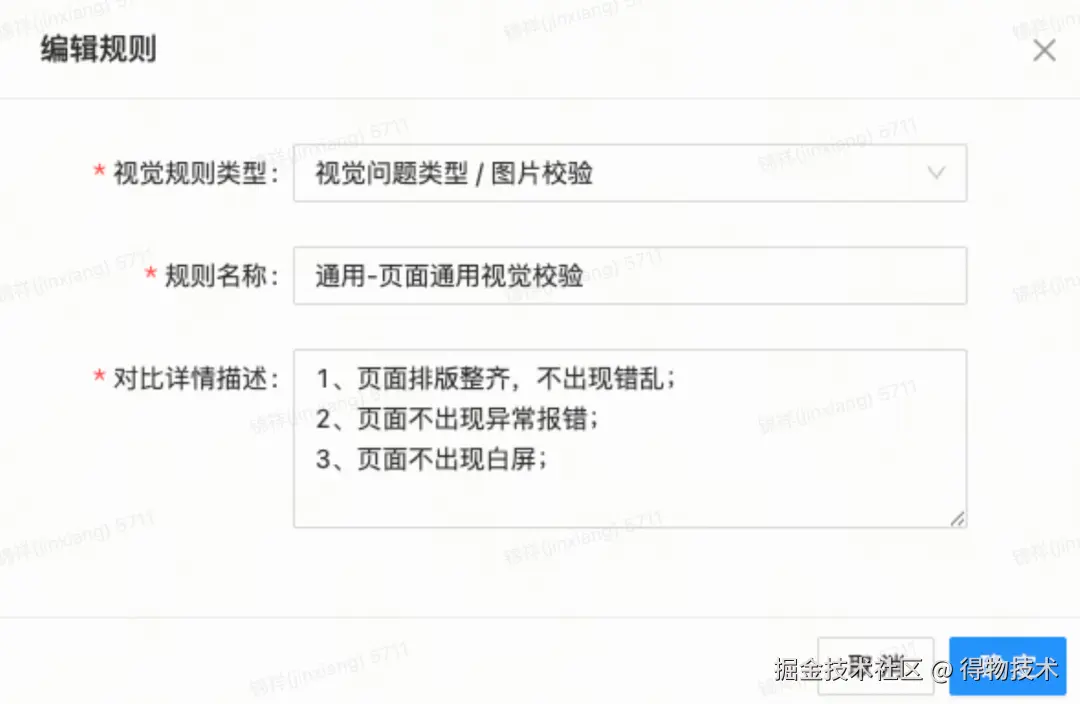
不同功能具体的检测规则不尽相同,配置内容也有所差异,但基本上只需要描述一个检测的大致范围,不需要太细化,比如下面是我们平台的通用检测规则,用于检查所有常见的排版、报错的异常问题:
巡检结果反馈
常规任务
一般来说,对于执行完成的检测任务,在对应的详情页可以查看到模型的逻辑和过程,比如下面是得物App内某ip品牌页的检测结果:
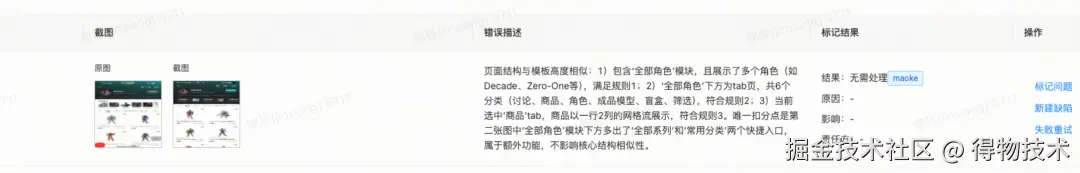
在对应测试记录的执行详情里,一般会展示以下关键的信息:
- 当前规则的对比图和现场实时截图
- 基于配置的检测规则,模型的具体分析过程和结论
通过现场的截图信息和模型分析描述,测试人员可以准确的定位和分析问题,如果当前结果是模型的误报,相关人员也可以反馈给我们,我们会根据检测结果不断优化模型的检测能力。
页面展示一致性检测
对于多级页面展示一致性的检测任务,最终返回的结果信息里,会有日志信息说明比较的过程和结果,如果有异常会额外提供不同页面的对比截图:

AI操作
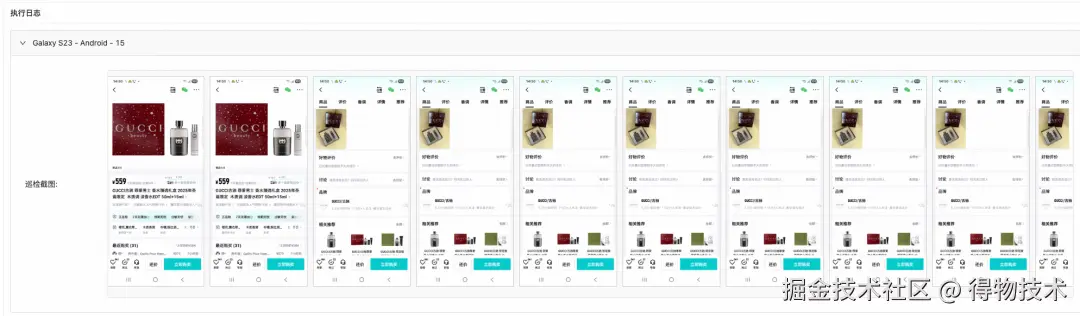
在有AI操作配置的任务中,其结果详情页面会有整个流程的执行截图,来帮助测试人员定位问题和还原现场:
五、总结
在移动应用自动化测试领域,传统的元素和图像驱动方法正在逐渐向智能化驱动转型,这一转变不仅提升了自动化的使用效率和维护便利性,也使得基于模型的图像理解能力得以发挥,从而实现深度探索应用程序的潜力。
我们通过将现有的技术平台进行整合,基于视觉语言模型(VLM),开展场景化的智能巡检探索与实践。这种方法在多种任务场景下均能有效识别应用中的问题,相较于之前的方案,智能巡检整体的问题识别准确率从50%提升到80%, 整体图片相似度匹配准确率从50%提升到80%以上,在首次会场AI走查的过程中(纯技术),共发现17个配置问题,AI问题发现率达95%。
后续我们会继续结合AI大模型能力在App的相关场景进行更多的探索和应用,帮助测试人员更高效地保障App的质量,提升得物App的用户使用体验。
往期回顾
1.深度实践:得物算法域全景可观测性从 0 到 1 的演进之路
2.前端平台大仓应用稳定性治理之路|得物技术
3.RocketMQ高性能揭秘:承载万亿级流量的架构奥秘|得物技术
4.PAG在得物社区S级活动的落地
5.Ant Design 6.0 尝鲜:上手现代化组件开发|得物技术
文 /锦祥
关注得物技术,每周更新技术干货
要是觉得文章对你有帮助的话,欢迎评论转发点赞~
未经得物技术许可严禁转载,否则依法追究法律责任。