https://academic.oup.com/bioinformatics/article/41/5/btaf269/8121151
https://github.com/picrust/picrust2/wiki
自 2.6.0 版本起,PICRUSt2-SC 数据库随 PICRUSt2 预装。
安装
bash
# 这一步比较慢,耐心等
mamba create -n picrust2 -c bioconda -c conda-forge picrust2=2.6.2
picrust2_pipeline.py -h
使用
bash
picrust2_pipeline.py -s asv.fasta -i feature-table.biom -o result_dir \
-p 180 --in_traits EC,KO,CAZY-
-s (或 --study_fasta): 你的 ASV/OTU 代表序列文件(FASTA 格式)。 -
-i (或 --input): 你的丰度表(BIOM、TSV 或 mothur 格式)。 -
-o (或 --output): 输出结果的文件夹名称。 -
-p (--processes): 多线程设置。默认是 1。 -
--in_traits: 基因家族类型。默认预测 EC 和 KO(KEGG)。如果你需要 GO 条目、PFAM 结构域或 CAZy(碳水化合物酶),需要在这里用逗号隔开加上。 -
--stratified: 分层输出。如果你想知道每一个 KO 或 Pathway 具体是由哪些 ASV(细菌)贡献的
ggpicrust2可视化
https://github.com/cafferychen777/ggpicrust2
https://doi.org/10.1093/bioinformatics/btad470
R
# install.packages("devtools")
devtools::install_github("cafferychen777/ggpicrust2")

#安装bioconductor依赖包
if (!requireNamespace("BiocManager", quietly = TRUE))
    install.packages("BiocManager")

pkgs <- c("phyloseq", "ALDEx2", "SummarizedExperiment", "Biobase", "devtools",
          "ComplexHeatmap", "BiocGenerics", "BiocManager", "metagenomeSeq",
          "Maaslin2", "edgeR", "lefser", "limma", "KEGGREST", "DESeq2")

for (pkg in pkgs) {
  if (!requireNamespace(pkg, quietly = TRUE))
    BiocManager::install(pkg)
}


if (!requireNamespace("MicrobiomeStat", quietly = TRUE)) {
  install.packages("MicrobiomeStat")
}
分析 PICRUSt2 输出的最简单方法是使用 ggpicrust2() 函数。可以使用 ggpicrust2() 函数运行主管道。ggpicrust2()整合了 ko 丰度和 kegg 通路丰度转换、通路注释、差异丰度(DA)分析,是 DA 结果可视化的一部分。当运行 ggpicrust2 时遇到问题时,可以通过运行单独的函数进行调试,这将大大加快您的分析和可视化速度。
看到 PICRUSt2 output 文件夹的 KO_metagenome_out 里面的 pred_metagenome_unstrat.tsv.gz
(这也可以用clusterProfile做可视化)
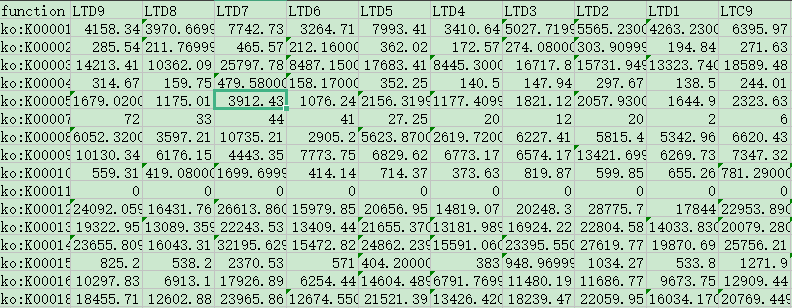
R
# 1. 环境准备
library(readr)
library(ggpicrust2)
library(tibble)
library(tidyverse)
library(ggprism)
library(patchwork)
library(MicrobiomeStat)

# 2. 读取原始数据
ko_abundance <- read_delim("pred_metagenome_unstrat.tsv", delim = "\t", col_names = TRUE, trim_ws = TRUE)
metadata <- read_delim("metadata_L8.txt", delim = "\t", escape_double = FALSE, trim_ws = TRUE)

kegg_abundance <- ko2kegg_abundance(data = ko_abundance)

# 3. 运行 ggpicrust2 分析
daa_results_df <- pathway_daa(abundance = kegg_abundance,
                      metadata = metadata,
                      group = "Group",
                      pathway = "KO",
                      daa_method = "LinDA",
                      select = NULL,
                      ko_to_kegg = TRUE,
                      p.adjust = "BH",
                      reference = "Ctrl")

# --- 5. 筛选并查看 padj < 0.05 的显著通路 ---
# 筛选出校正后显著的结果
significant_padj <- daa_results_df %>%
  filter(p_adjust < 0.05) %>%
  arrange(p_adjust) # 按显著性排序

# 在控制台打印出来
if (nrow(significant_padj) > 0) {
  print("以下是 p_adjust 显著的通路:")
  print(significant_padj[, c("feature", "group1", "group2", "p_adjust", "log2FoldChange")])
} else {
  message("没有发现 p_adjust < 0.05 的显著通路。")
}