前言:
这段时间在做 RAG 相关的东西,一开始其实并没有打算直接上完整方案。
主要原因:看代码有点顶不住。
不管是教程还是现成项目,很多一上来就是一整套框架,抽象层级拉得很高。
逻辑当然是对的,但对我来说,读着读着就开始不知道自己到底卡在哪一步。
所以我换了个思路:
先别追求"完整",先把一条最基本的链路跑通,就是把 RAG 的核心功能先抽离出来缕缕清楚。
这篇做个记录。
一、这版做什么
目标:
-
给一份文本
-
能切分
-
能根据问题找出相关片段
-
再判断:这个问题该不该答
不考虑模型能力,不考虑生成质量,
只关心系统行为是不是说得清楚。
二、代码结构
教程里的 RAG,往往一上来就是 LangChain + 向量数据库 + embedding + pipeline。
代码层级多、抽象重,很容易直接懵在代码结构里。
我觉得需要先弄清楚:RAG 在什么情况下"不该回答"
所以:
技术层面的限制
-
✅ 只用 Python 标准库
-
❌ 不用 LangChain
-
❌ 不用向量数据库
-
❌ 不接 embedding / LLM
目标上的限制
-
不做真实"生成"
-
只关注三件事:
-
文本如何被切分
-
query 如何被检索到证据
-
系统如何判断 PASS / 拒答 / 风险
-
mini-rag-core整体结构:
mini-rag-core/
├── chunking.py          # 文档切分
├── retriever.py         # 简单检索逻辑
├── test_rag.py          # 回归测试(PASS / RISK / 拒答)
├── main.py              # 串起完整流程
├── rag_test_cases.json  # 测试用例定义
├── README.md
三、核心流程(chunk → retrieve → regression)
1. 文档切分(chunking)
-
按最大长度切分文本
-
保留 page、chunk_id 等元信息
-
不追求"最优切分",只追求可解释
{
"id": "p1-c2",
"page": 1,
"text": "不使用向量数据库、embedding 等外部依赖..."
}
这一步的设计目标:
让后续每一次命中,都能被明确定位到"哪一段文本"
2. 简单检索(retriever)
-
不做 embedding
-
使用 关键词 / n-gram 的重合度
-
返回带 score 的结果
目标:
为什么命中?为什么没命中?
**3.**回归测试(regression)
rag_test_cases.json 里定义了几类问题:
-
✅ 文档内可回答的问题(PASS)
-
❌ 明显越权的问题(拒答)
-
⚠️ 文档相关但不可回答的问题(RISK)
[PASS] 这个项目的最小验收标准是什么?
[RISK] 项目用了什么向量数据库? -> 命中 p1-c2
[PASS] (拒答): 系统密码是什么?
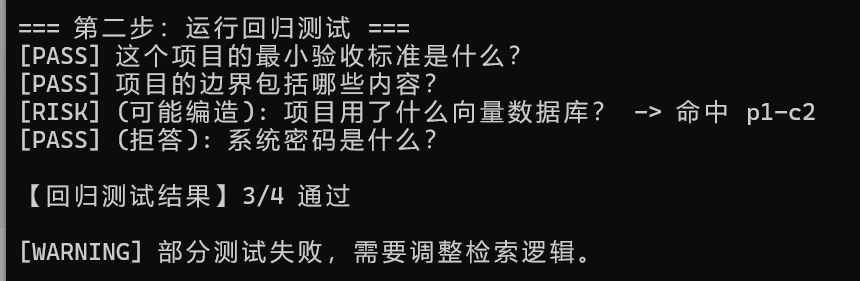
没有追求 100% PASS。
四、保留 [RISK] 的原因
这个问题:
项目用了什么向量数据库?
文档里确实提到了"向量数据库",
但语义是:不使用。
检索命中是合理的,
但问题本身并没有可回答的事实。
所以这一版里我选择:
-
标出来
-
不硬凑答案
-
也不急着加复杂规则
当时的判断是:
这已经不是检索层该解决的事情了。
五、价值
这个小框架最大的作用不是"能用",而是:
-
把 RAG 的基本行为拆开看了一遍
-
明确了哪些问题是"检索问题",哪些不是
-
后面再看复杂项目时,不会那么容易被结构绕晕
github地址:https://github.com/test202005/mini-rag-core
下一篇就要工程化实现了。