如果有价值 $100 万美金的顶级专家任务,AI 能完成其中多少?
答案是 48 万美金,而只需要 100 美元的 Token 费用。
这个数字怎么来的?Humanlaya Data Lab 联合北京通用人工智能研究院(BIGAI)、xbench、M-A-P,招募来自 Morgan Stanley、世达(Skadden)、协和医院、中国电网、清华大学等顶级机构或学府的 100+ 位资深专家,耗时 2000+ 小时,构建了等价于人类专家工作价值百万美元级评测基准 ------ $OneMillion-Bench。
作为该基准的主导构建机构,Humanlaya 是一家成立于 2025 年的 AI 数据实验室,通过定义真实、高经济价值的可验证任务,推动大模型能力边界的拓展与经济价值的落地。相关论文、代码与数据已经公开,链接如下:
-
GitHub:github.com/humanlaya/O...
-
Hugging Face:huggingface.co/datasets/hu...
-
官网地址:www.humanlaya.com
随着 OpenClaw 的爆火,人们越来越关注 AI Agent 能够实际替人类完成的任务。$OneMillion-Bench 的核心想法很直白:用 "人类专家的时间与成本" 给任务定价,再用 "是否满足专家要求" 衡量模型交付质量 ------ 如果把 AI 当成 "数字白领专家",总价值 100 万美金的任务,模型到底能赚多少钱?
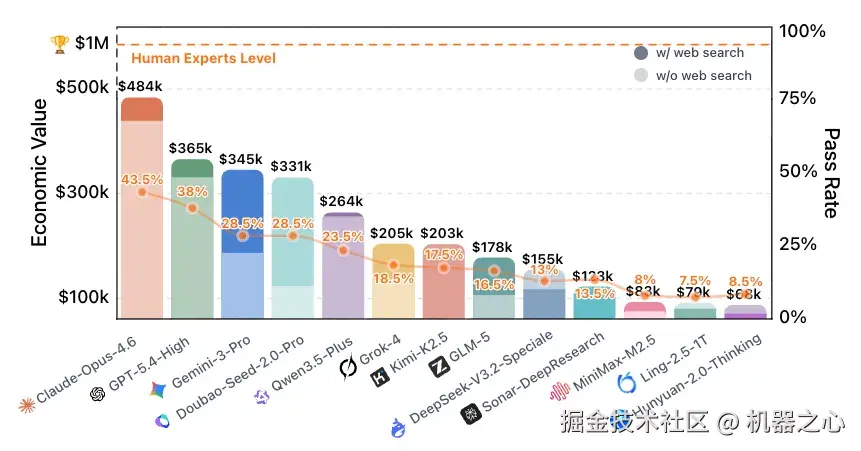
$OneMillion-Bench模型表现和其获取的经济价值
01|"Agent 能挣钱" 成为日常,但行业更缺一把尺:可交付、可复核、可控
从 2025 Agent 元年开始,AI 逐渐从 "答题机" 推进到 "数字员工",但业界现有评测集往往缺乏对实际经济价值的衡量,区分度不足、难以自动化且仅有英文语境。
因此,$OneMillion-Bench 构建了一套兼备高经济价值 × 高区分度 × 可自动评测的基准,它包含 400 道高难题目(200 个英文题 + 200 个中文题),覆盖金融、法律、医疗、自然科学与工业五大领域的 92 个三级领域,与常见的考试题不同,每道题都是真实行业场景下的开放专家任务,采用 Rubrics + LLM as Judge 评测。
该基准要求模型给出可落地的实操方案与判断链路,在这些开放问题上,不仅回答 "是什么",更要说明 "怎么做、按什么顺序做、为什么这么做"。
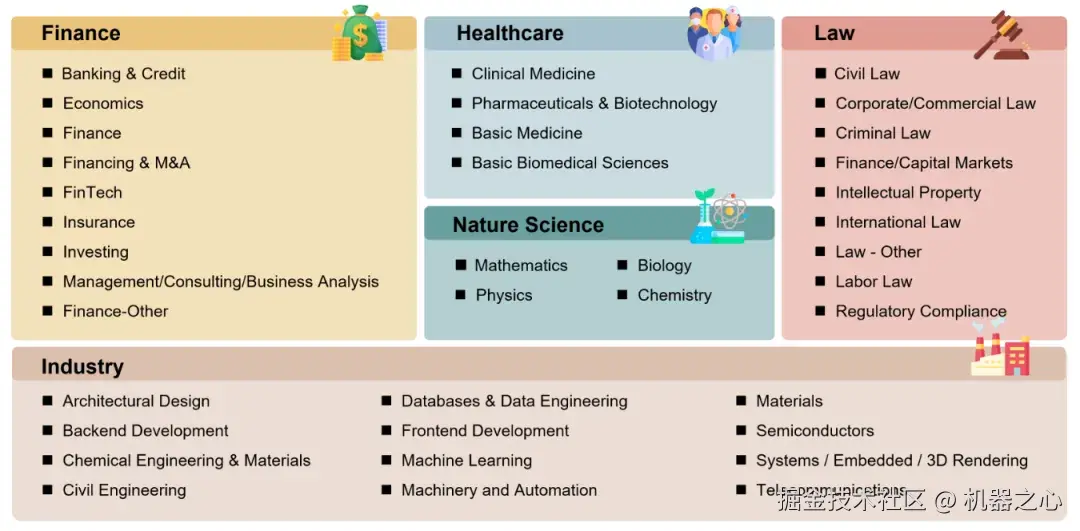
$OneMillion-Bench 5 个领域,37 个二级和 92 个三级细分类别
之所以是 $OneMillion,是因为这些任务真的很 "贵"。
不同于传统只评估模型准确率的榜单,我们用 "钱" 来标价每一道题的现实劳动价值 ------ 任务经济价值 = 资深专家完成该任务的耗时 × 专家时薪。时薪锚定官方或行业权威数据,如中国部分城市人社局、美国劳动统计局,任务的耗时来自多个领域专家的共同评估。
据此,把所有任务的经济价值加和计算后,超过了 100 万美元。如果在现实世界里把这些工作交给资深专家团队完成,你需要支付的成本就是百万美元量级。这样一来,模型评测不再停留在分数上,而是更直观地回答:AI 现在到底能稳定交付多少 "可兑现价值",以及距离真正上岗还差什么。
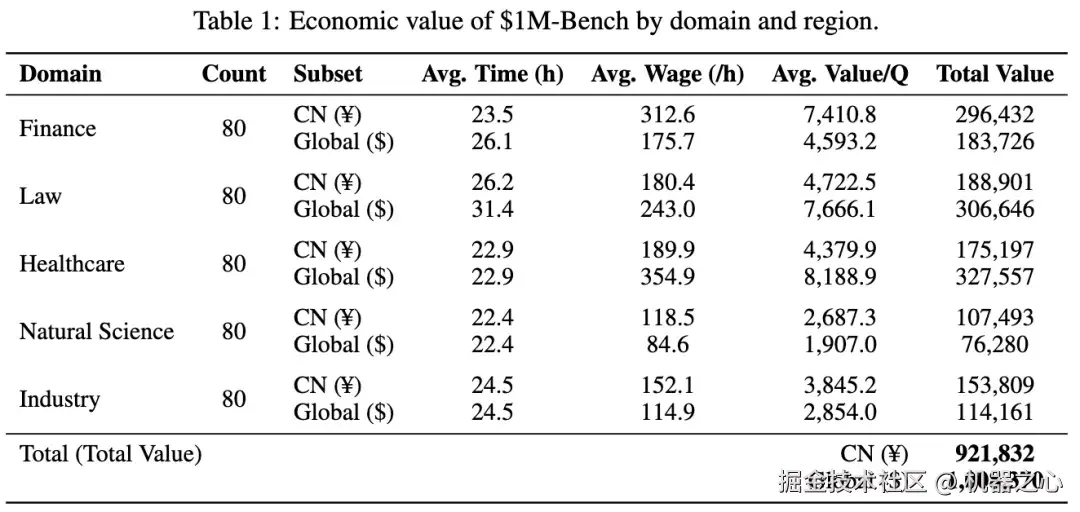
$OneMillion-Bench 经济价值计算
02|四大关键设计:多样化真实场景 + 高价值任务 + 非对称负分机制 + 高质量与一致性
(1)经济价值出发,构建高真实性、高含金量专家任务
我们在评测中引入用货币度量的 "经济价值",核心是衡量模型在真实世界中能创造多少可交付的经济价值。开放式问题很难用单一标准答案衡量,我们邀请一线资深专家将真实工作流拆解为细颗粒度考点:每道题设计 15--35 个考点,累计 7000+ 考点。题目覆盖 5--15 年经验从业者在真实场景中常见的典型任务,专家来自各类头部机构,不只考知识点,更考验特定场景下的专家级决策能力。
(2)引入 "负分项",防止 Reward Hacking
在开放式任务里,模型最容易走向 "越说越多、看起来越专业",蒙到考点就得分。为了避免虚高,我们加入行文逻辑和结构、扣分项考点。模型如果只是堆砌内容,没有合理的逻辑展开,无法 "撞到" 高分。在考点分值设置上,我们采取 +10 ~ -20 的非对称考点分值:正向能力给分更克制,明确或致命错误惩罚更重。这套结构的效果更接近真实使用体感 ------ 做对不一定加分很多,但做错往往会带来更大代价。
(3)覆盖 92 个三级分类,含 CN + Global 两大子集单独区分中国大陆题目,场景足够真实、丰富
我们将任务细化到覆盖 92 个三级分类的真实岗位工作流;CN 是中文题目,Global 是英文题目,收集本地化、真实的题目,尽量还原真实的法规、流程与业务语境,从而更精准刻画不同模型在特定地域业务场景中的能力差异。
(4)一套 "像生产线" 的专家 Pipeline:让高难 Rubrics 题可规模化、可质控
为了确保数据场景真实、考点合理,团队在专家招募、选拔与培训上投入大量成本,专家平均整体通过率低于 5%,题目最终质检通过率 38.1%。数据生产采用 3-4 名专家协作的 Pipeline,包含对抗性评审与仲裁机制。在难度控制上,我们采取双向截断策略,剔除过易样本,对于过难样本二次复审,确保数据质量。
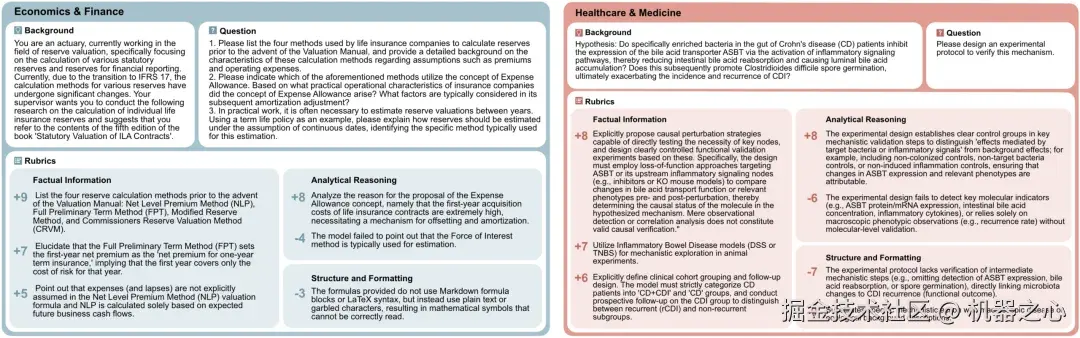
题目示例
03 | 成绩单解读:SOTA 的分数已经合格,但距离交付仍有距离
目前最强模型通过率超过 40%,在 100 万美元的任务上,大约可以产出 50 万美元,而完成任务的 API 成本也就 100 美元左右!AI 不但已经能 "干活",而且在极高难度、极高单价的专业任务里,已经能交付相当可观的美元级别的价值。
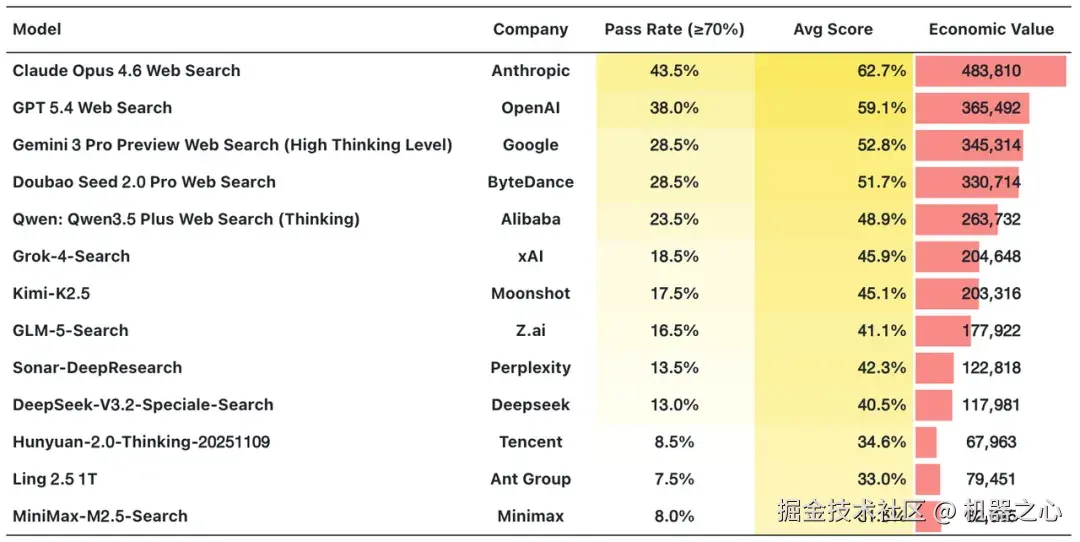
模型的平均通过率、平均分和可以产生的总经济价值
Insight 1:成绩已经合格,但离 "可托付" 还很远
如果只看平均分,头部模型已经进入了合格区间(60%+),第二梯队也普遍在 50% 以上,说明 AI 在专业任务上确实能覆盖不少关键点。但在真实工作里,平均分其实不够用,未达到一定质量需要返工。因此,我们引入了更贴近落地的指标 ------ 通过率(Pass Rate):单题得分达到 70% 及以上,本题才算 "通过"。
基于这个定义,本榜单的 Economic Value(经济价值)也不是按平均分线性折算,而是严格按 "可交付" 口径计算,只有通过的任务才计入 "能赚到的钱"。平均分像 "考试成绩",而通过率才是 "上岗证"。
而从通过率的视角来看,即使是排名第一的 Claude Opus 4.6 Web Search,也骤降到43.5%,即只有不到 45% 的任务可以通过验收,第二梯队多在 25~30% 区间徘徊。换句话说,平均分看起来 "能用",但能在一半以上任务里稳定达到可交付标准的模型,目前还不存在。
目前,AI 已经能稳定交付一部分题目、并且能赚到很可观的价值,但榜单也清楚告诉我们另一半真相:距离可交付的专业任务仍有相当一段路程。
Insight 2:Web Search 是一把双刃剑
Web Search 工具调用通常能显著补齐事实,尤其在经济金融领域的时效性问题,同样适用于医疗、工业、法律中不断迭代和演进的规范和约束。
但它也会引入噪声与 "看似权威的错误来源",从而出现波动甚至回退。下一阶段竞争不只是 "有没有搜索",而是 "会不会搜索" 以及搜索工具的效果如何:会不会选源、会不会交叉验证、会不会把证据链写进推理、会不会在噪声下保持一致性。
Insight 3:复杂推理仍是通用瓶颈,方向正确但缺乏可执行的细节
模型擅长写一段看起来连贯的解释,但一旦任务需要深层理解、多步演绎、或在巨大可能空间里探索,就仍会出现深度不足与准确性波动。典型例子包括软件工程、机器学习相关任务中的探索式问题。这类任务必须先建立结构,再做推导,再做反证,再回溯修正。模型往往会在中途跳步,或者用看似合理的叙述替代真正的推理。
此外,模型容易给出方向正确但是缺乏可执行细节的回复。比如在医疗场景下,需要的是可执行的临床要素,但模型容易泛泛而谈,遗漏关键点。自然科学任务里存在类似的对实验条件的预期不足、对约束不够细、机制链条理解浅。这种失败在真实落地里杀伤力很大,因为它看起来 "很对",但没有可实践的信息量。
05|One Step Further ------ 将把模型推进到 "可交付" 的那一步
如果站在 2024 年的视角,会觉得 AI 还是一个 "大玩具"。但站在 2026 年、OpenClaw 把 Agent 推到大众面前之后,我们看到的是另一件事:AI 已经能交付 50 万美元级别的专业价值;接下来竞争的关键,是继续提升这份价值,并且将这份价值变得更稳定、更可复核、更可控,使智能的边际提升能直接转化为生产力和收入。
$OneMillion-Bench 的意义不在于 "再做一个排行榜",而是把 "数字员工" 的能力边界量化出来:你今天和未来可以放心把哪些工作交给它?
更多参考链接:
Humanlaya:lab.humanlaya.com/
BIGAI:www.bigai.ai
xbench:xbench.org
M-A-P:huggingface.co/m-a-p