🔍 核心知识点提取
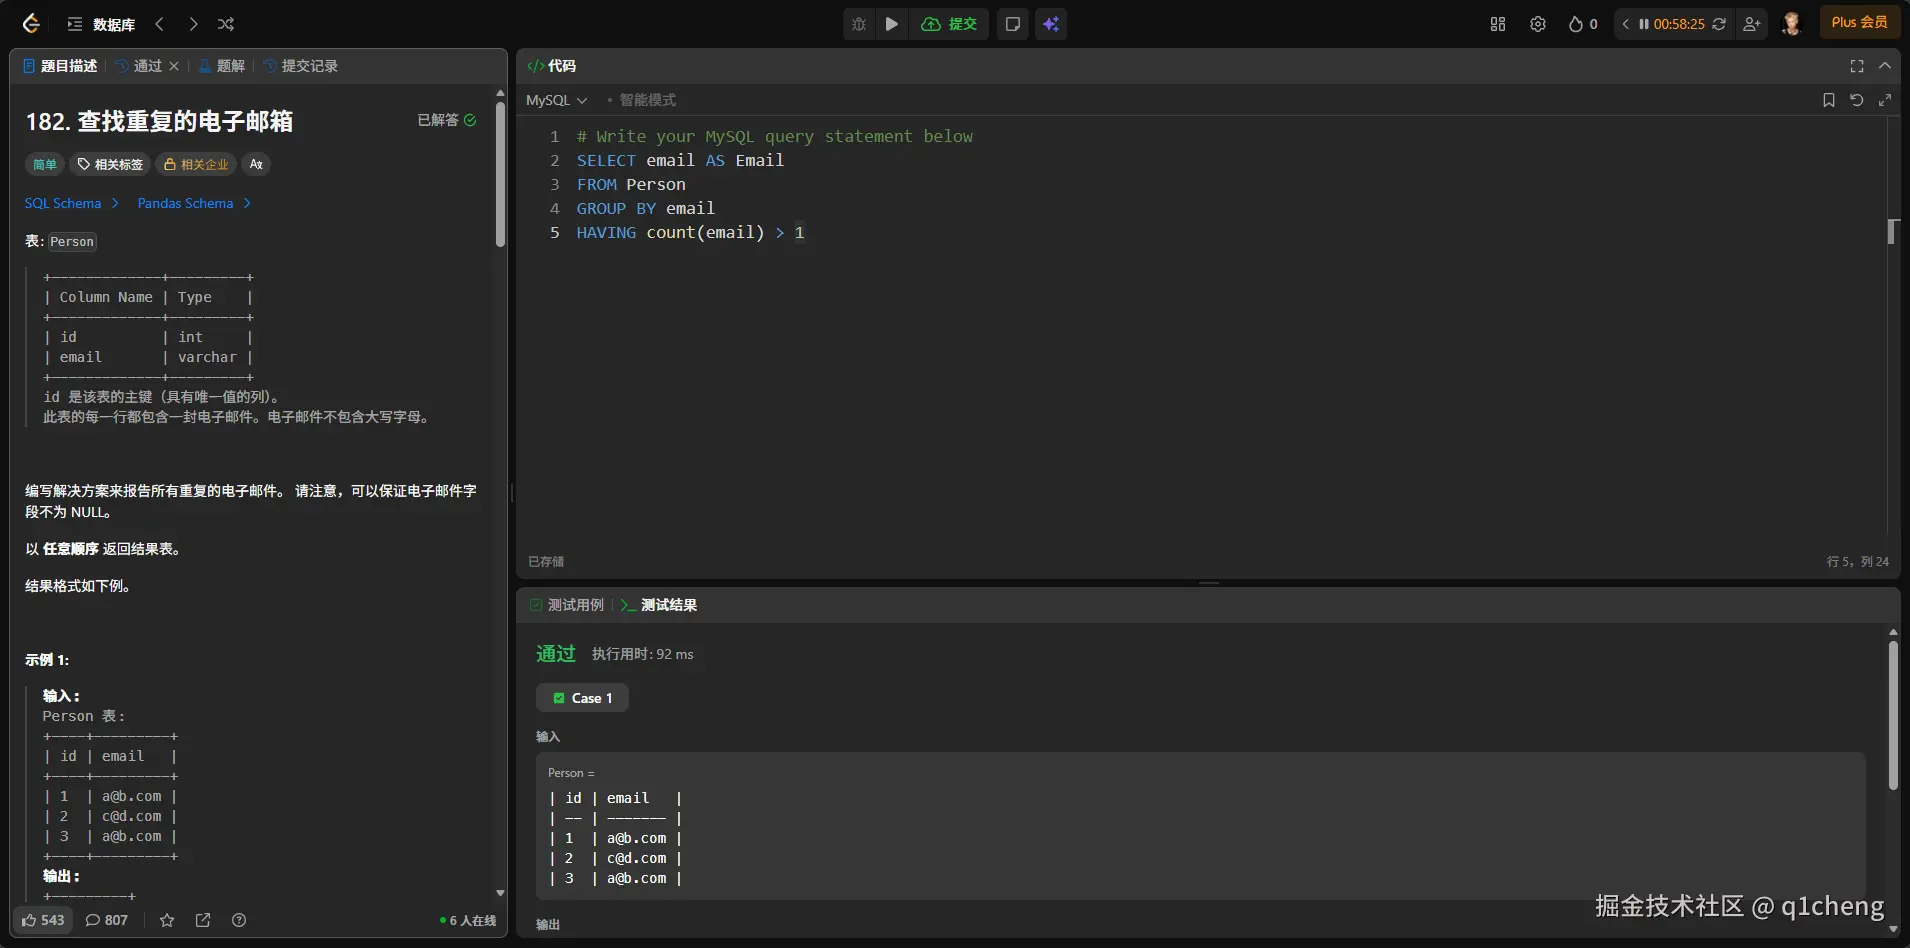
1. 表结构与业务需求
-
表名 :
Person -
关键字段:
id:主键,唯一标识每条记录email:电子邮箱字段(非 NULL,无大写字母)
-
业务需求 :找出所有重复出现的电子邮箱(即出现次数 ≥ 2 的邮箱)
2. SQL 核心解题思路
(1)分组统计 + 筛选(最推荐)
使用 GROUP BY 对邮箱分组,再用 HAVING 筛选出重复项:
sql
sql
SELECT email AS Email
FROM Person
GROUP BY email
HAVING COUNT(email) > 1;-
核心逻辑:
GROUP BY email:将相同邮箱的记录归为一组COUNT(email):统计每组邮箱的出现次数HAVING COUNT(email) > 1:只保留出现次数大于 1 的组(即重复邮箱)
(2)自连接去重(另一种实现)
通过表自连接,匹配不同 id 但邮箱相同的记录:
sql
vbnet
SELECT DISTINCT p1.email AS Email
FROM Person p1
JOIN Person p2
ON p1.email = p2.email AND p1.id != p2.id;- 关键 :
p1.id != p2.id确保匹配的是不同记录,DISTINCT避免同一重复邮箱多次输出。
(3)子查询方式
先统计每个邮箱的次数,再筛选次数 > 1 的:
sql
vbnet
SELECT email AS Email
FROM (
    SELECT email, COUNT(*) AS cnt
    FROM Person
    GROUP BY email
) AS temp
WHERE cnt > 1;
3. 关键语法与概念
GROUP BY分组 :按指定列(email)将数据分组,用于聚合统计- 聚合函数
COUNT():统计每组内的记录数 HAVING子句 :对分组后的结果进行过滤(区别于WHERE:WHERE过滤行,HAVING过滤组)DISTINCT去重:确保重复邮箱只输出一次- 别名
AS:将结果列名重命名为题目要求的Email
4. Pandas 实现思路(对应 Pandas Schema)
用 Pandas 处理时,核心是分组统计 + 筛选:
python
运行
ini
import pandas as pd

def duplicate_emails(person: pd.DataFrame) -> pd.DataFrame:
    # 分组统计邮箱出现次数
    email_count = person['email'].value_counts()
    # 筛选出现次数>1的邮箱
    duplicate_emails = email_count[email_count > 1].index
    # 封装成要求格式的 DataFrame
    result = pd.DataFrame({'Email': duplicate_emails})
return result- 另一种写法(用
groupby+filter):
python
运行
lua
def duplicate_emails(person: pd.DataFrame) -> pd.DataFrame:
    return person.groupby('email').filter(lambda x: len(x) > 1)[['email']].drop_duplicates().rename(columns={'email': 'Email'})
5. 边界情况与注意事项
- 非 NULL 保证 :题目明确
email字段不为 NULL,无需处理 NULL 值 - 大小写:题目说明邮箱无大写字母,无需额外做大小写转换
- 去重要求 :重复邮箱只需返回一次,不能多次输出(
DISTINCT或 Pandas 去重可满足)
💡 总结
这道题核心考察 分组聚合(GROUP BY + 聚合函数) 和 分组后筛选(HAVING) ,是 SQL 中处理重复数据的经典基础题型。