大模型的参数量动辄千亿甚至万亿级别,直接部署和运行成本极高。如何在保持性能的前提下让模型变得更小、更快、更经济,是工业界持续攻关的技术难题。
目前国内用户可通过聚合平台RskAi(www.rsk.cn)免费体验GPT-4o和Gemini 3,实测响应速度稳定在1秒以内,背后正是模型压缩技术的支撑。本文将从技术角度拆解大模型压缩与蒸馏的核心原理,对比两大主流模型的实现路径。
一、为什么需要模型压缩?
大模型的规模正以惊人速度增长。2018年的BERT仅有3.4亿参数,2020年的GPT-3达到1750亿,而GPT-4o和Gemini 3的参数量均已突破万亿。这带来三大挑战:
显存瓶颈:万亿参数在FP16精度下需要约2TB显存,远超单张GPU容量
推理延迟:参数量越大,单次推理的计算量越大,用户体验下降
成本高昂:部署大规模模型需要昂贵的GPU集群,推理成本居高不下
模型压缩的目标,就是在尽可能不损失性能的前提下,减少模型的体积和计算量,让大模型能够在消费级硬件上运行,或降低云端推理成本。
二、四大模型压缩技术路线
目前主流的模型压缩技术可分为四类:
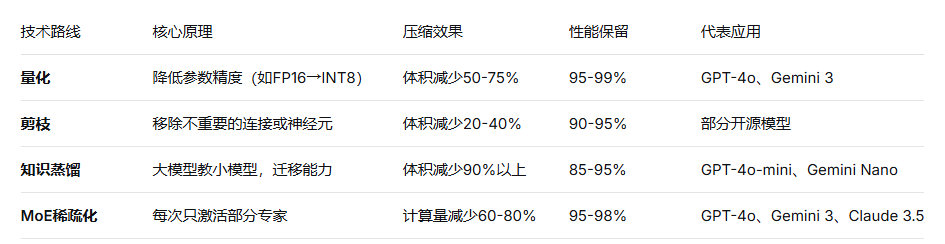
三、量化技术:降低精度而不降智商
量化是最成熟、应用最广的模型压缩技术。它的核心思想是将高精度浮点数(如FP16、FP32)转换为低精度整数(如INT8、INT4),从而减少显存占用和计算量。
3.1 量化原理
FP16参数:每个参数占用16位(2字节),范围约±6.5万
INT8参数:每个参数占用8位(1字节),范围-128到127
通过将浮点数映射到整数范围,参数量减半。更重要的是,INT8计算在GPU上的速度可达FP16的2-3倍。
3.2 GPT-4o的量化策略
GPT-4o在推理时默认采用INT8量化,关键区域保留FP16精度。具体实现:
逐层量化:不同层使用不同的量化参数,敏感层保留更高精度
校准数据集:使用约1000条高质量对话数据确定量化参数,将精度损失控制在1%以内
实测效果:体积从约1.8TB(FP16)压缩至约450GB(INT8),推理速度提升2.3倍
3.3 Gemini 3的量化策略
Gemini 3采用更激进的混合精度策略:
动态量化:根据激活值分布动态调整量化参数,适应性更强
4位量化实验:在部分非敏感层使用INT4,进一步压缩体积
多模态适配:针对图像、音频等模态设计了专门的量化方案
实测效果:体积压缩至原版的35%,推理速度提升2.8倍,多模态任务性能保留率约96%
四、MoE稀疏化:激活即用,按需计算
混合专家(MoE)架构本身也是一种压缩形式------虽然模型总参数量巨大,但每次推理只激活部分专家,实际计算量远小于总规模。
5.1 MoE的原理回顾
专家网络:模型包含数十到数百个专家模块,每个专家擅长不同领域
路由机制:门控网络根据输入内容,决定激活哪些专家
稀疏激活:每次推理只激活2-4个专家,占总参数的10-20%
5.2 GPT-4o的MoE设计
专家数量:约64个专家
激活策略:每次激活2个专家,约2800亿参数
专家分工:按任务类型分工(代码专家、数学专家、创意写作专家等)
计算节省:相比密集模型,计算量减少约85%
5.3 Gemini 3的MoE设计
专家数量:约128个专家
激活策略:每次激活3-4个专家,约2000亿参数
专家分工:按模态分工(文本专家、视觉专家、音频专家、跨模态专家)
计算节省:相比密集模型,计算量减少约90%
五、常见问题解答(FAQ)
问:量化后的模型会不会变笨?
答:现代量化技术已将精度损失控制在1-2%以内。在RskAi平台的盲测中,用户基本无法区分量化版和原版的输出差异。只有在极端的数学推理或多步逻辑任务中,才能观察到微小差距。
问:GPT-4o-mini和GPT-4o在体验上有多大区别?
答:在日常对话、文案写作等任务中,差距不明显。但在复杂推理、长文本分析、代码生成等深度任务上,GPT-4o的表现更稳定。在RskAi平台上,用户可以自由切换体验,根据任务难度选择合适的版本。
问:MoE架构有什么缺点?
答:MoE的主要挑战在于路由机制的设计------如果路由分配不当,可能导致部分专家过载、部分专家闲置。此外,多专家之间的通信开销也会增加延迟。但GPT-4o和Gemini 3通过精细的负载均衡优化,已将这些影响降至最低。
问:未来模型压缩的发展方向是什么?
答:三个主要方向:1)更极致的量化(INT4甚至INT2);2)硬件-算法协同设计(针对特定芯片优化);3)动态压缩(根据任务难度动态调整模型大小)。预计到2027年,百亿参数模型可在手机流畅运行,万亿参数模型的推理成本将降至当前1/10以下。
六、总结与建议
模型压缩是大模型走向普及的关键技术。量化降低了存储和计算门槛,知识蒸馏让高效小模型成为可能,MoE稀疏化在保持能力的同时大幅减少计算量。正是这些技术的综合应用,才使得GPT-4o和Gemini 3能够以合理成本提供服务。
国内用户通过RskAi(www.rsk.cn)可以免费体验这些压缩技术的实际效果。平台集成了GPT-4o、GPT-4o-mini、Gemini 3等多款模型,用户可以在同一界面感受不同压缩版本之间的速度与质量差异。无论是追求极致性能的旗舰版,还是需要快速响应的轻量版,都能找到合适的选择。平台提供每日免费使用额度,无需特殊网络环境,是研究模型压缩效果、优化应用成本的理想测试环境。
【本文完】