个人游戏笔记本免费"养龙虾"(二)用显卡GPU运行OpenClaw,CUDA的安装与配置
- Win10下配置WSL2使用CUDA
-
- [1、windows安装nvidia GPU驱动](#1、windows安装nvidia GPU驱动)
- 2、在WSL2中安装CUDA
- [3、添加CUDA Toolkit路径](#3、添加CUDA Toolkit路径)
- 4、关联nvidia-smi
- [5、【解决】error:unable to allocate CUDA0 buffer](#5、【解决】error:unable to allocate CUDA0 buffer)
- 测试结果
系列文章:
1. 个人游戏笔记本免费"养龙虾"(Win10+WSL2+OpenClaw 部署与配置指南)
Win10下配置WSL2使用CUDA
参考文献1:Win10下配置WSL2使用CUDA搭建深度学习环境-腾讯云
1、windows安装nvidia GPU驱动
根据自己的显卡型号以及操作系统选择对应驱动,我这里是RTX 2060,操作系统是Win 10 64位。
官网上有两种类型的驱动程序,一个是GeForce Game Ready 驱动程序,另外一个是NVIDIA Studio 驱动程序 。注意:我们要选择GeForce Game Ready 驱动程序,不要选错了。
驱动下载地址:NVIDIA GeForce 驱动程序 - N 卡驱动 | NVIDIA
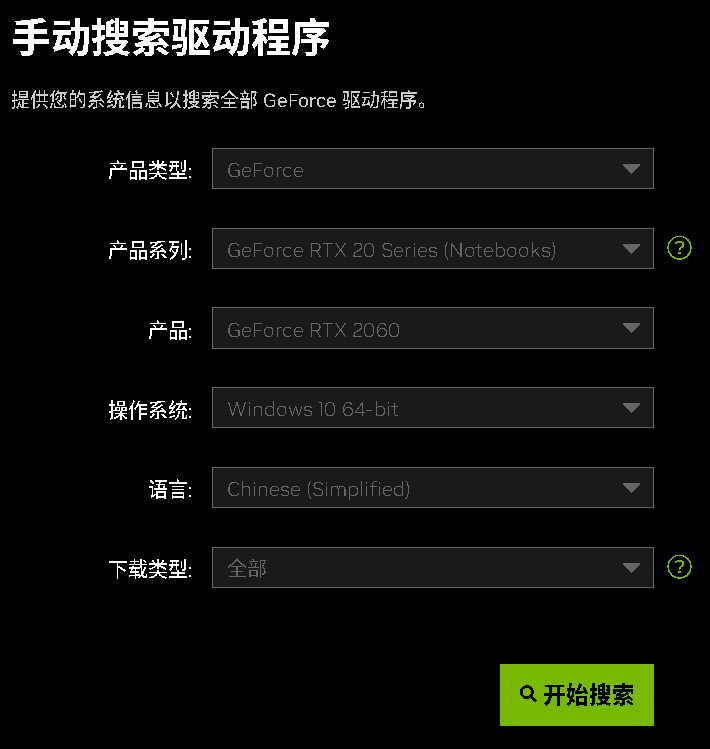
安装完驱动后,在powershell中输入nvidia-smi,可以看到驱动支持的最高CUDA版本。
2、在WSL2中安装CUDA
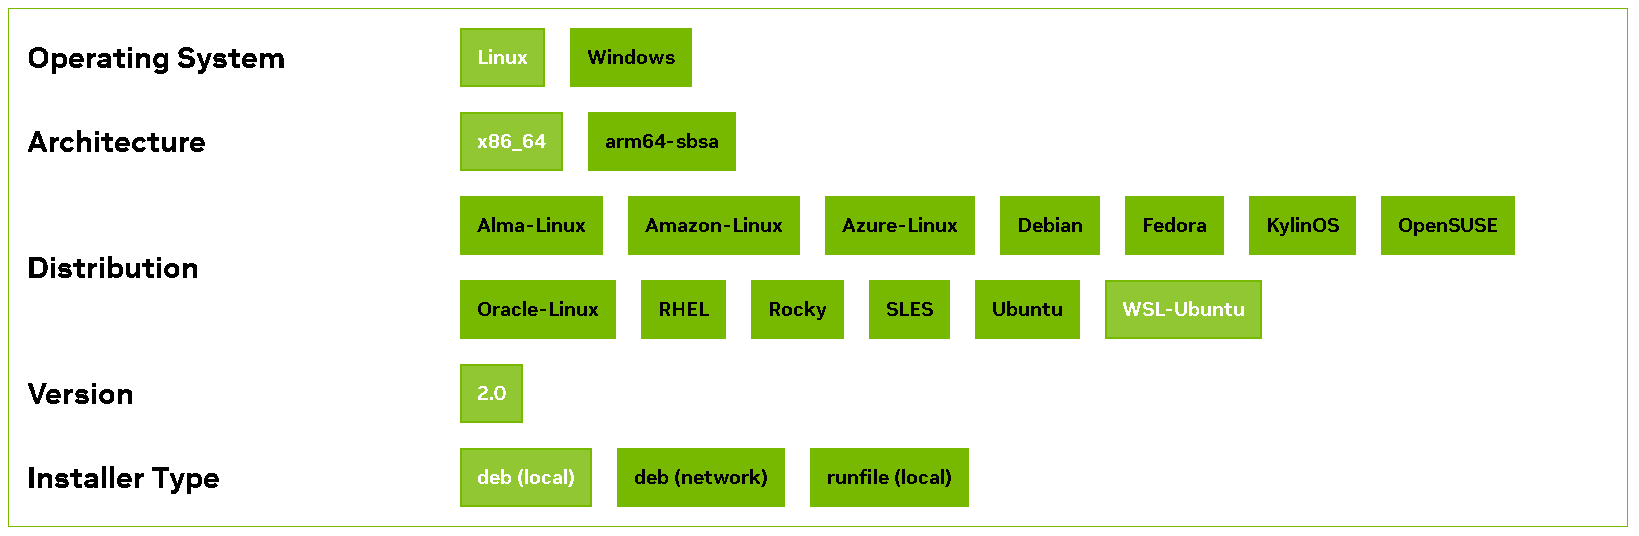
进入英伟达官网,找到CUDA Tookit下载页面,按下图选择对应的版本。根据平台类型选择Linux_x86_64_WSL_Ubuntu 2.0_deb(local)。
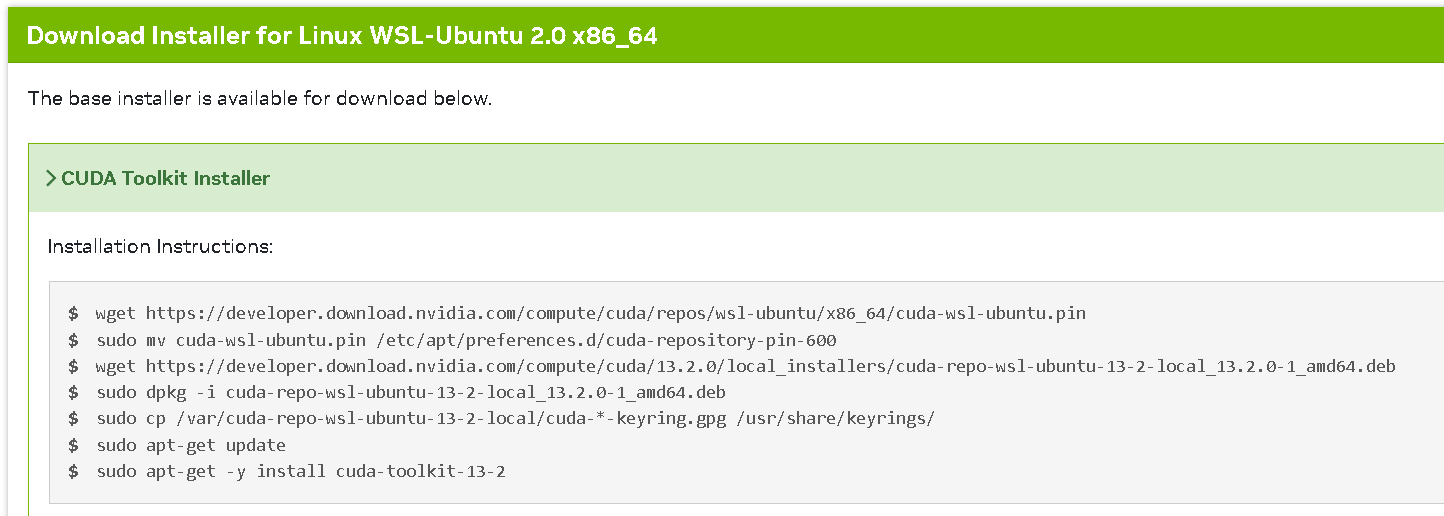
网页中显示出Ubuntu的执行命令。考虑到网速下载快慢问题,可以先用Windows的浏览器下载第一和第三项的文件,到d:盘。接着,在WSL_Ubuntu 终端中,先切换到d:盘($ cd /mnt/d/),再依次输入指令。这样,下载的速度会快些。
3、添加CUDA Toolkit路径
安装完成后,配置对应的环境变量,默认是修改.bashrc文件,
bash
# 1. 打开bash配置文件
$ nano ~/.bashrc

# 2. 在文件末尾添加以下内容
export PATH=/usr/lib/wsl/lib:$PATH
export LD_LIBRARY_PATH=/usr/local/cuda-13.2/lib64:$LD_LIBRARY_PATH

# 3. 按Ctrl+O保存,按Enter确认文件名,按Ctrl+X退出

# 4. 使配置立即生效
$ source ~/.bashrc
4、关联nvidia-smi
在上一篇文章中,我们在windwos下输入nvidia-smi是可以运行的,同样其实在WSL中也可以使用nvidia-smi命令,不过WSL的nvidia-smi在 /usr/lib/wsl/lib/目录,故我们只需要对/usr/lib/wsl/lib/nvidia-smi进行软链接到/usr/bin/:
bash
ln -s /usr/lib/wsl/lib/nvidia-smi /usr/bin/nvidia-smi注意:一旦系统安装了Windows NVIDIA GPU驱动程序,CUDA便可在WSL2中使用。安装在Windows主机上的CUDA驱动程序将在WSL 2内部被模拟为 ,因此用户切勿在WSL 2内部安装任何NVIDIA GPU Linux驱动程序。这里必须非常小心,因为默认的CUDA Toolkit会捆绑驱动程序,很容易在默认安装过程中覆盖WSL2的NVIDIA驱动程序。我们建议开发人员使用从CUDA Toolkit下载页面获取的WSL2(Ubuntu)专用CUDA Toolkit,以避免此类覆盖。
5、【解决】error:unable to allocate CUDA0 buffer
参考文献2:error: llama runner process has terminated
模型参数过大时,会报错:
error: llama runner process has terminated:error loading mode: unable to allocate CUDAO buffer
主要原因是:
- (1)多 GPU 冲突
默认使用集成显卡(而非独立显卡)。多 GPU 显存分配冲突。
解决方法:禁用集成显卡(需在 BIOS 中设置) - (2)GPU显存不足
解决方法:选用参数规模较小的模型,例如选择qwen3.5:2b,而不能选择qwen3.5:4b
测试结果
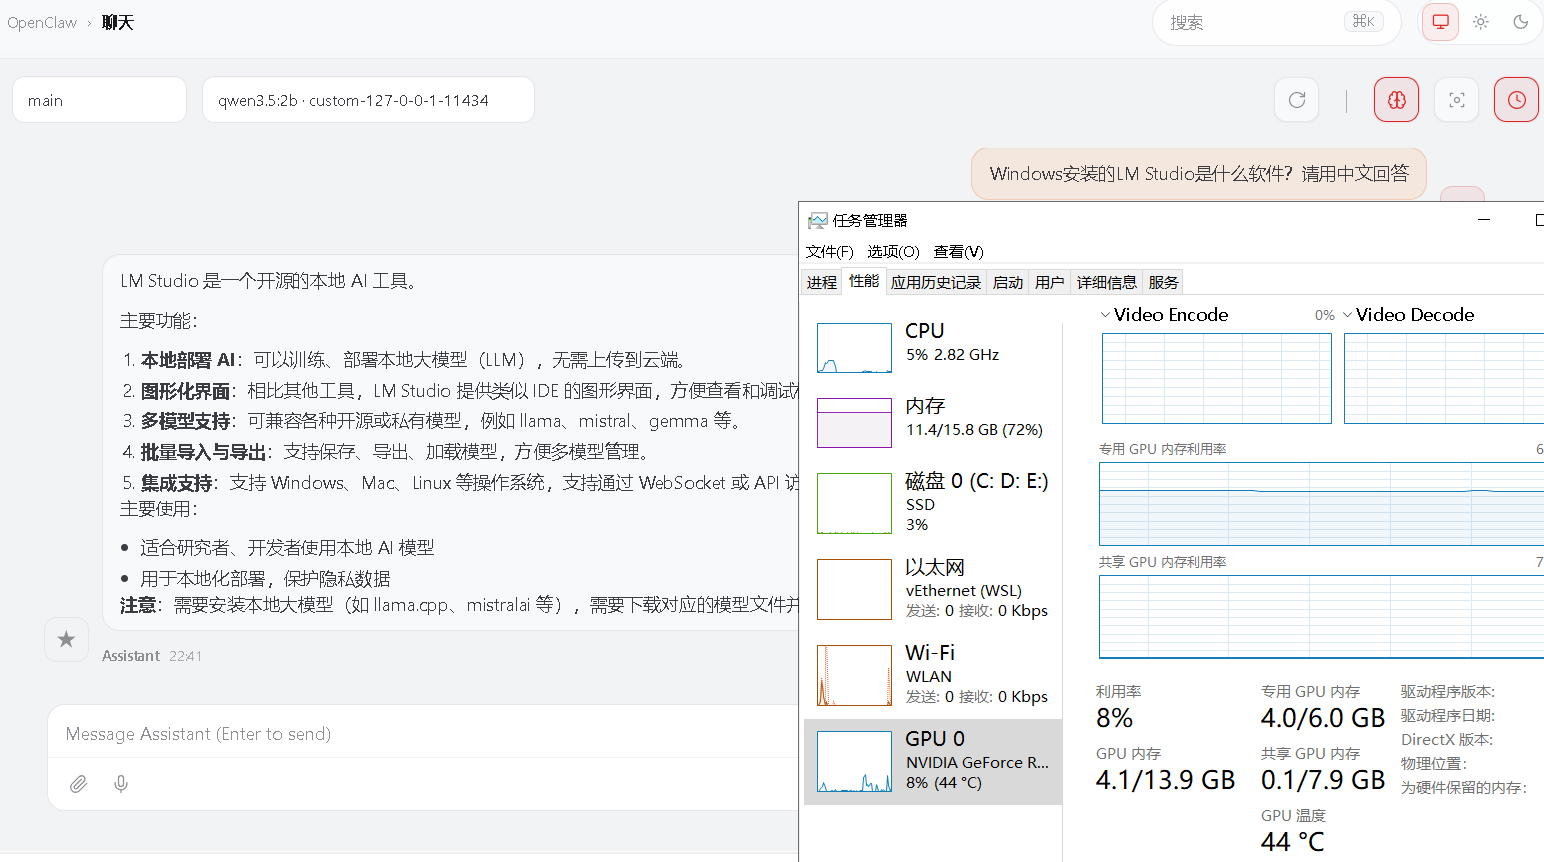
打开资源管理器,在openclaw中对话时,可以看到占用了4.1G的GPU内存,GPU和CPU的利用率都在10%以下。如果不配置使用GPU,那么CPU的使用率会持续在100%。
另外,要关闭不必要的软件。否则,openclaw也会因为内存不足而崩溃。