一、人工智能的终极矛盾:莫拉维克悖论
远在古希腊时期,人类就梦想着创造能自主思考的机器------从皮格马利翁的加拉蒂亚,到代达罗斯的塔洛斯,再到赫淮斯托斯的潘多拉。千年之后,当人类第一次构思可编程计算机时,就已经在思考计算机能否变得智能。
但 AI 研究者们很快发现了一个深刻的矛盾,后来被称为莫拉维克悖论(Moravec's Paradox):
对人类困难的抽象任务(如象棋、数学推导),计算机反而容易解决;而对人类毫不费力的直觉任务(如识别人脸、理解语言),计算机却极其困难。
IBM 的深蓝在 1997 年击败了国际象棋世界冠军 Garry Kasparov。国际象棋仅有 64 个位置和 32 枚棋子,完全可以由一组形式化规则来描述。设计出成功的策略是巨大成就,但向计算机"描述"象棋这个问题本身并不难。
真正的难题在于:一个人的日常生活需要关于世界的巨量知识------什么是"影子"、一把椅子从侧面看和从正面看为什么是同一把椅子、一个人拿着电动剃须刀的时候仍然是一个人......这些知识是主观的、直观的,根本无法用形式化的规则穷尽描述。
这就引出了 AI 的核心问题:如何让计算机获得这些非形式化的、人类凭直觉掌握的知识?
二、AI 方法的四个发展阶段
书中梳理了解决这个核心问题的四代方法,每一代都是对前一代局限性的突破:
2.1 第一代:知识库方法 ------ 硬编码世界知识
核心思路:将人类关于世界的知识用形式化语言写成规则,输入给计算机。
代表项目:Cyc(始于 1984 年)
Cyc 项目包括一个推断引擎和一个用 CycL 语言描述的声明数据库,这些声明全部由人类监督者手工输入。其目标是建立一个涵盖所有常识的数据库。
经典失败案例:Cyc 无法理解"Fred 在早上剃须"这个简单故事。它的推理过程如下:
- Cyc 知道:人体不包含电气零件
- Cyc 发现:Fred 正拿着一个电动剃须刀(电气设备)
- Cyc 推断:实体"正在剃须的 Fred"(FredWhileShaving)含有电气部件
- Cyc 产生困惑:Fred 在刮胡子的时候是否仍然是一个人?
致命缺陷:这个笨拙的过程暴露了硬编码方法的根本困境------世界的复杂性是无穷的,任何有限的规则集都无法完整描述常识。人类的常识推理依赖于数以亿计的隐式假设,而这些假设我们自己甚至都说不清楚。
2.2 第二代:经典机器学习 ------ 从数据中学习映射
核心突破:与其硬编码知识,不如让系统从数据中自动提取模式。
原理:给定人工设计的特征(feature),机器学习算法学习特征与结果之间的映射关系。
具体例子:
- 逻辑回归判断剖腹产 :医生提供一组特征(是否有子宫疤痕、胎位如何等),逻辑回归学习这些特征如何与各种结果相关联。但关键在于------它无法影响特征的定义方式。如果把患者的 MRI 原始扫描(像素)作为输入,它将完全无法工作,因为单个像素与分娩并发症之间的相关性微乎其微。
- 朴素贝叶斯区分垃圾邮件:基于词频等人工特征来分类。
核心局限:性能严重依赖于人工设计的特征。对于很多任务,我们根本不知道应该提取哪些特征。书中举了一个生动的例子:
假设我们想检测照片中的汽车。我们知道汽车有轮子,所以想用"车轮是否存在"作为特征。但根据像素值来描述"车轮看上去像什么"几乎不可能------同一个车轮的图像会因为阴影、光照、视角、遮挡等因素而千差万别。
表示的力量 :书中用了一个极其精妙的例子来说明数据表示的重要性。假设在散点图中有两类数据需要用一条线分开:在笛卡尔坐标下,这两类数据混杂在一起,根本无法线性分割。但只要转换到极坐标系,一条简单的垂直线就能完美分开。数据没变,变的只是表示方式,而任务从"不可能"变成了"轻而易举"。
这说明:阿拉伯数字比罗马数字更容易做算术运算,不是因为数字本身变了,而是因为表示更好了。表示的选择对机器学习性能的影响是决定性的。
2.3 第三代:表示学习 ------ 自动发现特征
核心突破:不仅学习特征到输出的映射,还学习特征本身的构造方式。
典型代表:自编码器(Autoencoder)
自编码器由两部分组成:
- 编码器函数:将输入数据转换为一种不同的内部表示(通常是低维的)
- 解码器函数:将内部表示还原回原来的形式
训练目标:输入经过编码再解码后,尽可能完整地保留信息。这迫使编码器必须学到数据中最本质的结构------那些真正重要的变差因素(factors of variation)。
什么是变差因素?
这是一个核心概念。变差因素指影响观察数据的潜在原因------它们通常不能被直接观察到:
- 分析语音时:变差因素包括说话者的年龄、性别、口音和正在说的词语
- 分析汽车图像时:变差因素包括汽车的位置、颜色、太阳的角度和亮度
在现实应用中,困难源于多个变差因素同时影响每一个数据点。比如一张夜晚拍摄的红色汽车照片,单个像素的值几乎接近黑色(因为夜晚光照),汽车轮廓的形状取决于拍摄视角。大多数应用需要我们"理清"这些变差因素,只关注我们需要的那些。
表示学习的困境:从原始数据中提取高层次的抽象特征(如"说话口音")本身就需要接近人类水平的理解能力,这几乎和解决原问题一样困难。
2.4 第四代:深度学习 ------ 层次化表示学习
核心突破:通过多层简单表示来逐步构建复杂表示,解决了表示学习中"一步到位"的困境。
深度学习的关键洞察:
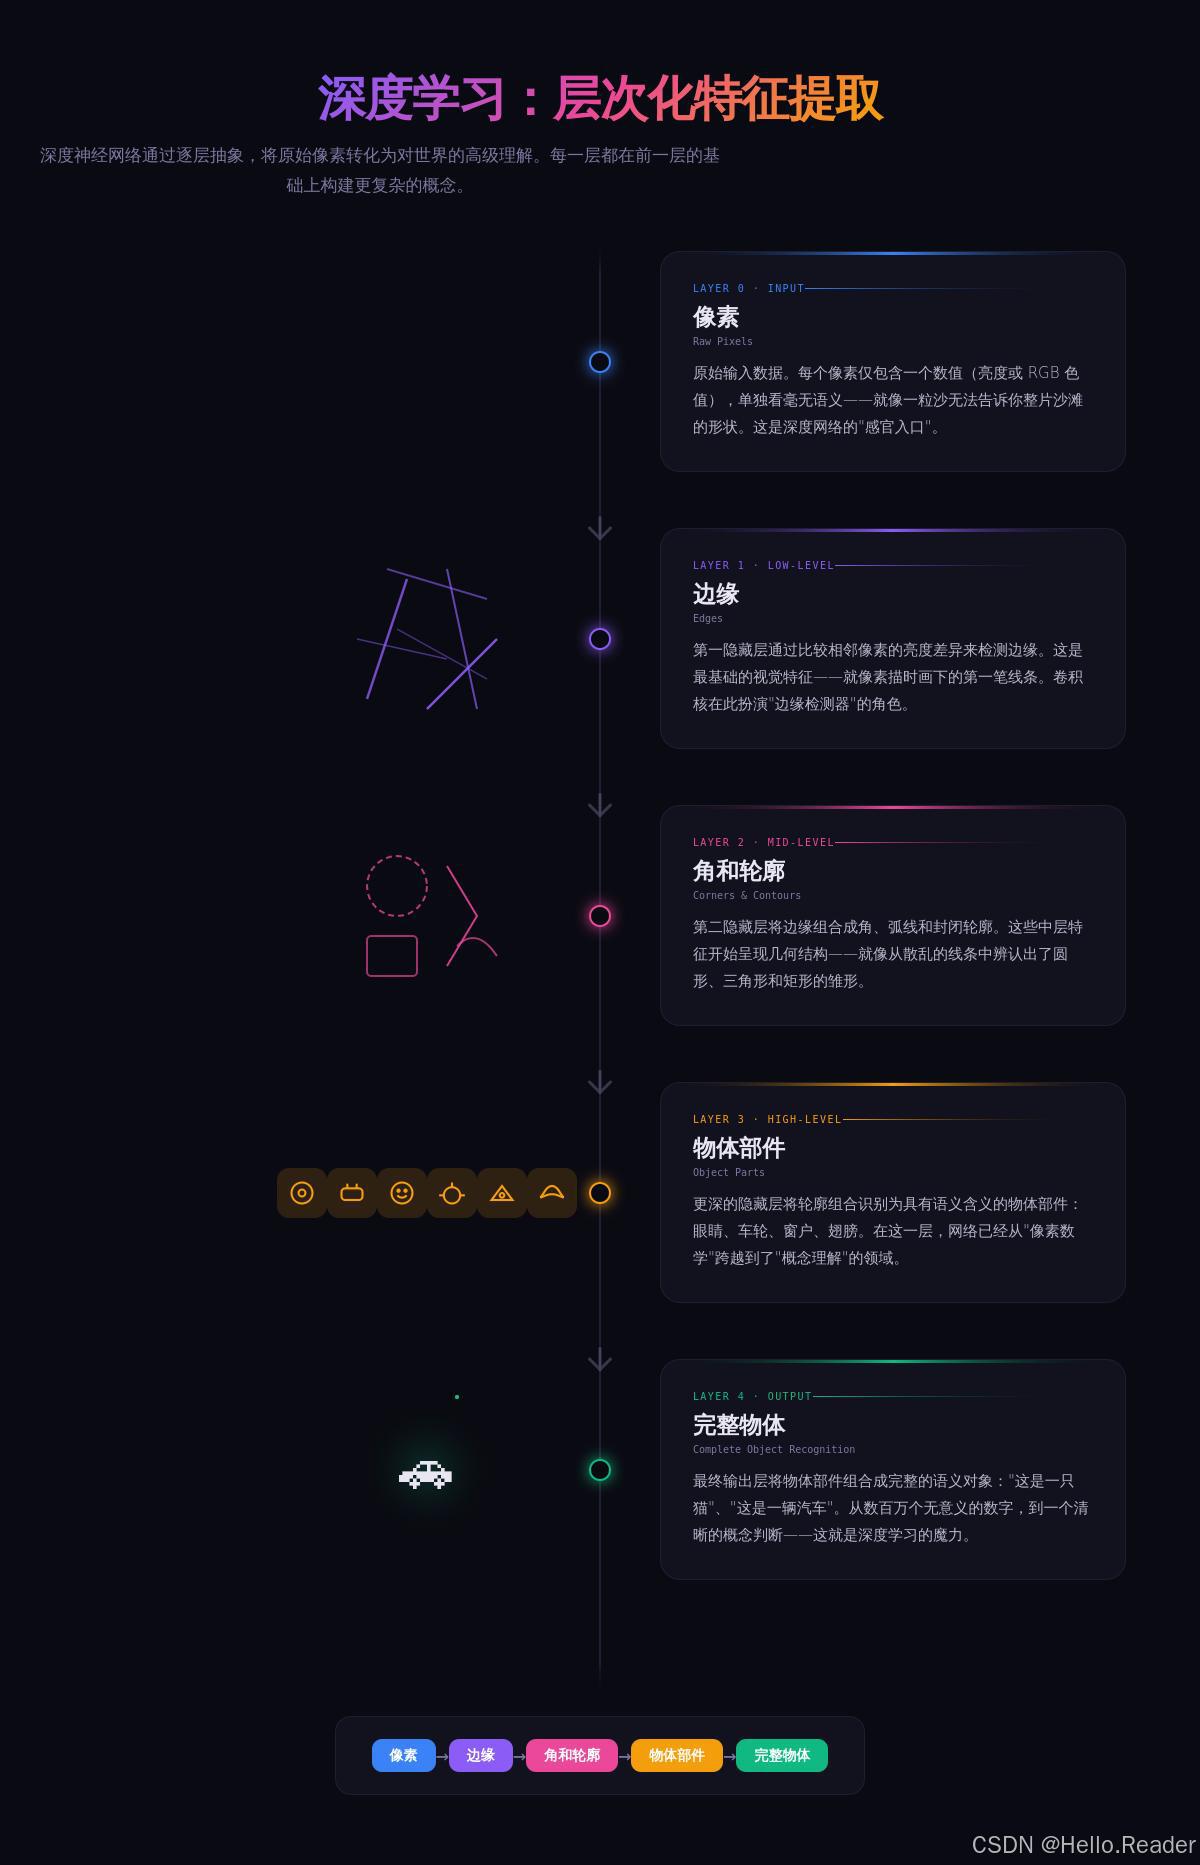
- 第一层:比较相邻像素的亮度来识别边缘
- 第二层:将边缘组合成角和轮廓
- 第三层:将角和轮廓组合成物体部件(眼睛、车轮)
- 最终层:将部件组合成完整对象的识别结果
每一层只做一小步抽象,但层层叠加后就能完成从"像素"到"概念"的跨越。
深度学习模型的典型例子 是前馈深度网络(也称多层感知机, MLP)。它本质上是一个将输入映射到输出的数学函数,只不过这个函数由许多较简单的函数复合而成。每一次函数应用都为输入提供了一个新的表示。
三、理解"深度"的两个视角
书中提出了两种理解模型"深度"的方式,它们从不同角度揭示了深度的本质。
视角一:计算图的深度(顺序指令数)
将模型看作从输入到输出的计算流程图,最长路径的长度就是深度。
关键洞察:深度取决于你如何定义"一步"。以逻辑回归 σ(wᵀx) 为例:
- 如果把加法、乘法、sigmoid 各算一步 → 深度为 3
- 如果把逻辑回归整体算一步 → 深度为 1
这就像同一个程序用不同语言编写,代码行数不同一样。
视角二:概念图的深度(概念层级数)
在深度概率模型中,关注的是概念之间的层级关系深度,而非计算步骤数。
精彩例子:AI 系统观察一张脸部图像,其中一只眼睛在阴影中:
- 系统最初只看到一只眼睛
- 但检测到"脸"的存在后,系统推断第二只眼睛也可能存在
概念图只有两层(眼睛层和脸层),但计算图可能需要 2n 层------因为对简单概念的理解会在获得复杂概念的信息后进一步精细化。
深度学习的两种解读
书中提出了理解深度学习的两种互补视角:
视角 A:表示学习视角------每一层学习数据的一种新表示,逐层从简单到抽象。
视角 B:程序视角------每一层表示相当于执行一组并行指令后计算机的存储器状态。更深的网络能执行更多的顺序指令,后面的指令可以参考早期指令的结果。这赋予了深度网络极大的计算能力。在这个视角下,某层的激活值不仅仅包含对输入变差因素的解释,还可能存储"状态信息"------类似传统程序中的计数器或指针,帮助模型组织其处理过程。
四、AI 学科的层级关系
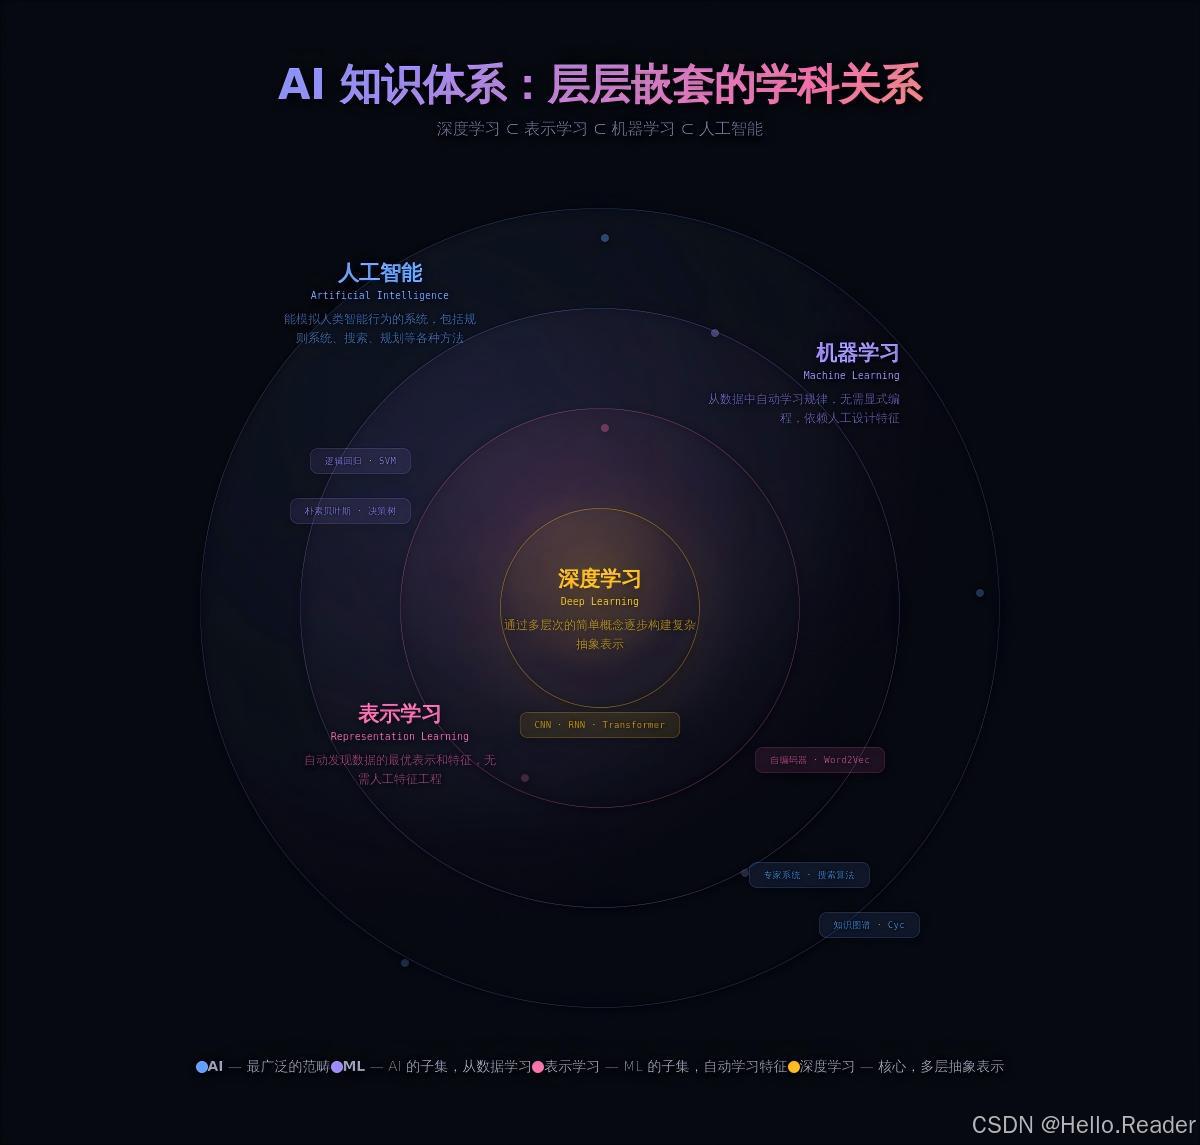
每一层都是上一层的子集和深化。书中用两张图展示了它们之间的关系:
四种方法的对比:
| 方法 | 谁设计输入特征? | 谁设计特征到输出的映射? | 代表技术 |
|---|---|---|---|
| 知识库 AI | 人 | 人 | Cyc、专家系统 |
| 经典机器学习 | 人 | 机器从数据学 | 逻辑回归、SVM、朴素贝叶斯 |
| 表示学习 | 机器从数据学 | 机器从数据学 | 自编码器 |
| 深度学习 | 机器分多层从数据学 | 机器从数据学 | CNN、RNN、深度网络 |
可以看到,从上到下,"人工"的成分越来越少,"自动"的成分越来越多。
五、深度学习的三次浪潮(详解)
深度学习并非一夜之间诞生的新技术。它经历了三次浪潮,每次浪潮都有其名称、核心突破和衰退原因。
5.1 第一次浪潮(1940s-1960s):控制论 Cybernetics
时代背景:最早的学习算法试图模拟生物学习------大脑怎样学习、为什么能学习。
核心模型与事件:
-
McCulloch-Pitts 神经元(1943):最早的脑功能计算模型。这个线性模型通过检验函数 f(x,w) 的正负来识别两类输入。但权重需要由操作人员手动设置。
-
感知机 Perceptron(1950s) :第一个能从数据中学习权重的模型。这是一个里程碑------机器第一次能够从样本中自动调整自己的参数。
-
自适应线性单元 ADALINE :返回函数 f(x) 本身的值来预测实数。用于调节其权重的训练算法是随机梯度下降(SGD)的一种特例------稍加改进后的 SGD 至今仍是深度学习的主要训练算法。
衰退原因 :线性模型有一个致命局限------无法学习 XOR(异或)函数 。Minsky 和 Papert 在 1969 年的著作中指出了这一点,导致对神经网络研究的资助大幅削减。批评者从 XOR 问题推广到对整个"受生物学启发的学习"方法的普遍抵触,引发了第一次 AI 寒冬。
5.2 第二次浪潮(1980s-1990s):联结主义 Connectionism
时代背景:联结主义(也称并行分布处理, PDP)在认知科学的背景下出现。当时大多数认知科学家研究符号推理模型,但符号模型难以解释大脑如何用神经元实现推理。联结主义者开始研究基于神经系统实现的认知模型,很多思想可追溯到心理学家 Donald Hebb 在 1940 年代的工作。
联结主义的核心思想:当网络将大量简单的计算单元连接在一起时,可以实现智能行为。
关键突破:
① 反向传播算法的普及(Backpropagation)
反向传播算法使得训练具有内部表示(隐藏层)的深度神经网络成为可能。虽然它曾黯然失色,但截至今日仍然是训练深度模型的主导方法。
② 分布式表示(Distributed Representation)
这是联结主义时期形成的最重要概念之一。核心思想:
- 系统的每个输入都应该由多个特征表示
- 每个特征都应该参与多个输入的表示
具体例子:假设视觉系统需要识别"红色/绿色/蓝色 × 汽车/卡车/鸟类"这 9 种组合。
局部表示(一对一方式):需要 9 个神经元,每个对应一种组合(红汽车、红卡车、红鸟......)。每个神经元必须独立学习颜色和物体的概念,互不共享。
分布式表示:只需 6 个神经元------3 个描述颜色,3 个描述物体身份。描述"红色"的神经元可以从所有红色物体的图像中学习"红色"的概念,而不仅仅从某一类中学习。
优势:参数大幅减少,学习效率大幅提高,泛化能力更强。这个概念是本书的核心主题之一。
③ LSTM 长短期记忆网络(1997)
Hochreiter 和 Bengio 分别指出了对长序列建模时的根本性数学难题(梯度消失/爆炸问题)。Hochreiter 和 Schmidhuber 于 1997 年提出 LSTM 来解决这些问题。如今 LSTM 在许多序列建模任务中广泛应用。
衰退原因(双重打击):
- 商业泡沫破裂:基于神经网络的创业公司寻求投资,做法野心勃勃但不切实际。当 AI 不能实现这些不合理的期望时,投资者彻底失望。
- 竞争对手崛起:核方法(SVM)和图模型在很多重要任务上表现优异,进一步削弱了人们对神经网络的信心。
第二次浪潮的衰退一直持续到 2007 年。
低谷期的坚守者:加拿大高级研究所(CIFAR)通过其 NCAP 研究计划帮助维持了神经网络研究的火种。该计划联合了三位后来被称为"深度学习三巨头"的研究者:
- Geoffrey Hinton(多伦多大学)
- Yoshua Bengio(蒙特利尔大学)
- Yann LeCun(纽约大学)
5.3 第三次浪潮(2006-至今):深度学习 Deep Learning
引爆点:2006 年的突破
Geoffrey Hinton 证明了一种名为**深度信念网络(DBN)的神经网络可以使用贪婪逐层预训练(Greedy Layer-wise Pretraining)**策略有效训练。其他 CIFAR 附属研究组很快证明同样的策略可以训练多种类型的深度网络,并系统性地提高泛化能力。
这一次浪潮正式普及了"深度学习"这一术语,强调两点:
- 研究者现在有能力训练以前不可能训练的深层网络
- "深度"具有理论上的重要性
关键认知转变:
"目前在复杂任务达到人类水平的学习算法,与 1980 年代努力解决玩具问题的学习算法几乎是一样的。最重要的新进展是现在我们有了这些算法得以成功训练所需的资源。"
这句话道破了一个深刻的事实:不是算法变了,而是数据、算力和工程实践变了。
六、深度学习成功的三大驱动力(详解)
6.1 与日俱增的数据量
数据量的增长史也是一部从"手工制造"到"数字洪流"的历史:
| 时代 | 数据规模 | 代表数据集 |
|---|---|---|
| 20世纪初 | 数百~数千样本 | 手动制作的统计度量 |
| 1950s-1980s | 小型合成数据集 | 低分辨率字母位图 |
| 1980s-1990s | 数万样本 | MNIST 手写数字(6万张) |
| 2000s | 数万~数十万 | CIFAR-10(6万张彩色图) |
| 2010s | 数百万~数千万 | ImageNet(1400万张)、Sports-1M |
| 机器翻译 | 数亿句对 | WMT 英法数据集 |
关键经验法则(截至 2016 年):
- 每类约 5,000 个标注样本 → 可接受的性能
- 1,000 万以上标注样本 → 达到或超越人类表现
为什么数据这么重要? 因为统计估计的核心难题是"观察少量数据并在新数据上泛化"。当数据足够多时,这个负担大大减轻------机器不需要那么"聪明"也能表现得好。
Hinton 的比喻:他将 MNIST 数据集描述为"机器学习的果蝇"------就像生物学家用果蝇做实验一样,机器学习研究者可以在 MNIST 这个受控环境下研究算法的行为。
6.2 与日俱增的模型规模
联结主义的核心见解之一:大量简单的计算单元协同工作才能产生智能行为。单独的神经元或小集合的神经元并不特别有用。
- 人工神经网络的规模大约每 2.4 年翻一倍
- 每神经元的连接数量已经与小型哺乳动物大脑在同一数量级上
- 但在神经元总数上,即使现在的大型网络也比青蛙的神经系统还小
- 按目前的趋势,至少要到 2050 年代,人工神经网络才能具备与人脑相同数量级的神经元
驱动力:更快的 CPU、通用 GPU 的出现、更快的网络连接和更好的分布式计算软件基础设施。
"其神经元比一个水蛭还少的神经网络不能解决复杂的人工智能问题,这是不足为奇的。"
6.3 与日俱增的精度、复杂度和现实世界影响
图像识别的进化轨迹:
| 阶段 | 能力 |
|---|---|
| 最早期 | 识别裁剪紧凑的小图中的单个对象 |
| 中期 | 处理更大尺寸的图像 |
| 现代 | 处理高分辨率照片,识别 1000+ 类别,无需裁剪 |
ImageNet ILSVRC 竞赛------深度学习的登场秀:
- 2012 年前(传统方法):top-5 错误率 26.1%
- 2012 年(AlexNet,卷积网络首次参赛):top-5 错误率骤降至 15.3%
- 此后每年持续刷新,截至书写作时:3.6%
语音识别:在 1990 年代提高后一直停滞到约 2000 年。深度学习的引入使错误率陡然下降,有些甚至降低了一半。
任务复杂度的演进:
- 单对象识别 → 整个字符序列输出:神经网络可以学习输出描述图像的完整字符序列,而不仅仅是单个对象
- 固定输入映射 → 序列到序列学习(Seq2Seq):LSTM 等循环网络用于对序列之间的关系建模,引领了机器翻译的颠覆性发展
- 神经图灵机:能学习读写存储单元,可以从样本中学习简单程序(如排序),将深度学习推向"自我编程"的方向
- 深度强化学习:DeepMind 的系统学会玩 Atari 视频游戏并匹敌人类,深度学习也显著改善了机器人控制的性能
工业应用:Google、Microsoft、Facebook、IBM、Baidu、Apple、Adobe、Netflix、NVIDIA 等顶级技术公司全面采用。
科学贡献:
- 预测分子相互作用,帮助设计新药
- 搜索亚原子粒子(粒子物理学)
- 自动解析构建人脑三维图的显微镜图像
- 为神经科学家提供可研究的视觉处理计算模型
七、神经科学与深度学习:灵感而非蓝图
书中用了相当篇幅讨论深度学习与神经科学的关系。这个讨论极其重要,因为媒体经常过度强调两者的相似性。
7.1 神经科学提供了什么?
① 可行性证明:大脑证明了智能行为是可能的。概念上,建立智能的直接途径是逆向大脑背后的计算原理。
② 通用算法假说------雪貂实验
这是书中最引人入胜的案例之一:神经学家将雪貂的大脑重新接线,使视觉信号传送到听觉区域,结果雪貂竟然学会了用听觉处理区域"看"东西。
这暗示:大脑的不同区域可能运行着相似的通用学习算法。在此之前,机器学习研究是分散的,不同社群分别研究 NLP、计算机视觉、运动规划和语音识别。这个发现启发了一种统一的方法论。
③ 架构灵感:
- 新认知机受哺乳动物视觉系统结构启发,后来成为现代**卷积网络(CNN)**的基础
- **整流线性单元(ReLU)**的思想部分受生物神经元特性启发
7.2 神经科学不提供什么?
书中非常明确地指出了边界:
"大家不应该认为深度学习在尝试模拟大脑。"
原因一:我们对大脑的了解远远不够。 要深刻理解大脑使用的算法,需要同时监测至少数千相连神经元的活动。目前我们做不到这一点,甚至连大脑最简单、最深入研究的部分都远远没有理解。
原因二:更接近生物的不一定更好。 真实的神经元计算着与整流线性单元非常不同的函数,但更接近真实神经网络的系统并没有导致机器学习性能的提升。
原因三:灵感来源是多元的。 现代深度学习从许多领域获取灵感,特别是应用数学的基本内容------线性代数、概率论、信息论和数值优化。
深度学习 vs 计算神经科学:这是两个不同的领域。深度学习关注"如何构建能解决智能任务的系统",计算神经科学关注"构建大脑如何真实工作的精确模型"。虽然研究人员在两个领域之间来回穿梭,但目标和方法是不同的。
八、核心概念完整速查表
| 概念 | 定义 | 书中举例 |
|---|---|---|
| 特征 (Feature) | 数据的单个可测量属性 | 是否存在子宫疤痕、声道大小估计 |
| 表示 (Representation) | 数据的描述方式,好的表示让任务更容易 | 笛卡尔坐标 vs 极坐标 |
| 变差因素 (Factors of Variation) | 影响观察数据的潜在不可观测原因 | 光照、视角、年龄、口音 |
| 表示学习 (Representation Learning) | 让机器自动学习数据的有效表示 | 自编码器 |
| 深度学习 (Deep Learning) | 通过多层简单表示逐步构建复杂表示 | 像素→边缘→轮廓→部件→物体 |
| 分布式表示 (Distributed Representation) | 每个输入由多个特征表示,每个特征参与多个输入的表示 | 6个神经元编码9种颜色×物体组合 |
| 反向传播 (Backpropagation) | 计算损失函数对每个权重梯度的算法 | 1980s 普及,至今仍是主导训练方法 |
| 知识库方法 (Knowledge Base) | 将世界知识硬编码为形式化规则 | Cyc 项目 |
| 多层感知机 (MLP) | 多层简单函数复合而成的深度网络 | 前馈深度网络 |
| 贪婪逐层预训练 | 2006年突破,使深度网络的有效训练成为可能 | 深度信念网络 |
| LSTM | 长短期记忆网络,解决长序列建模的梯度问题 | 1997年提出,广泛用于NLP |
九、深度思考题
基础理解:
- 用你自己的话解释"莫拉维克悖论"。为什么象棋对计算机简单,而人脸识别却很难?
- Cyc 项目的"Fred 剃须"故事揭示了知识库方法的什么根本缺陷?
- 书中笛卡尔坐标/极坐标的例子说明了什么?请再举一个"换表示就能简化问题"的生活例子。
深入思考 :
-
"分布式表示"相比"局部表示"有哪些具体优势?如果物体类别从 3 种增加到 100 种,两种方式各需要多少神经元?
-
为什么"深度"(多层)比"宽度"(单层很多神经元)更有效?用"计算机程序"的类比来解释。
-
书中说"目前达到人类水平的算法和 1980 年代的算法几乎一样"------那真正改变了什么?这对你学习深度学习有什么启示?
批判思维 :
-
深度学习的三次浪潮为什么会有衰退?当前的第三次浪潮有可能再次衰退吗?需要什么条件?
-
书中说"不应该认为深度学习在模拟大脑"。但如果有一天我们真正理解了大脑的算法,这对深度学习意味着什么?