什么是跳表?
跳跃表(skiplist)是一种有序数据结构, 它通过在每个节点中维持多个指向其他节点的指针, 从而达到快速访问节点的目的。
跳跃表支持平均O(logN)、最坏O(N)复杂度的节点查找, 还可以通过顺序性操作来批量处理节点。
跳表的实现
跳表的结构如下:
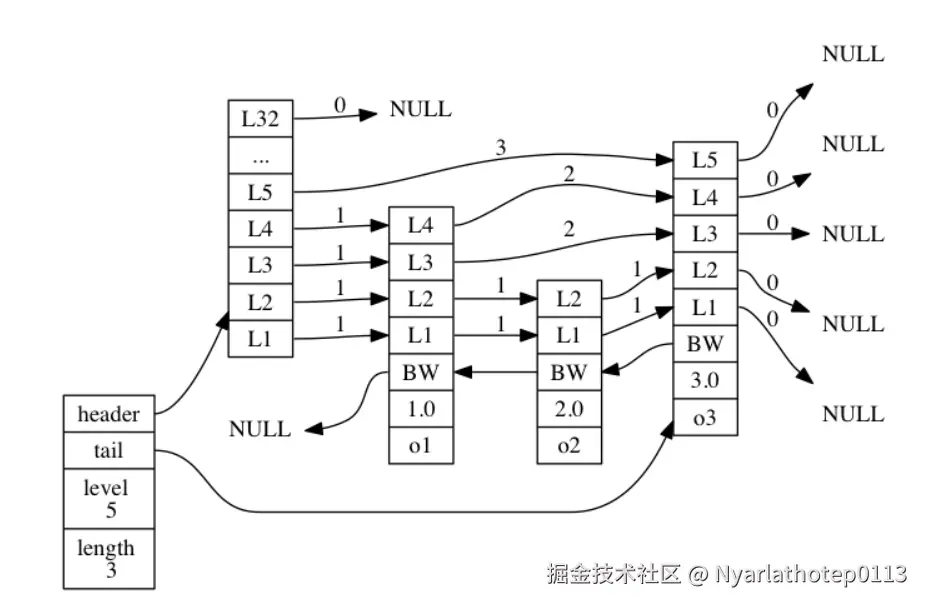 该结构包含以下属性:
header:指向跳跃表的表头节点。tail:指向跳跃表的表尾节点。level:记录目前跳跃表内,层数最大的那个节点的层数(表头节点的层数不计算在内)。length:记录跳跃表的长度,也即是,跳跃表目前包含节点的数量(表头节点不计算在内)。
跳表节点结构如下所示:
arduino
typedef struct zskiplistNode {

    // 后退指针
    struct zskiplistNode *backward;

    // 分值
    double score;

    // 成员对象
    robj *obj;

    // 层
    struct zskiplistLevel {

        // 前进指针
        struct zskiplistNode *forward;

        // 跨度
        unsigned int span;

    } level[];

} zskiplistNode;score是一个double类型的浮点数,跳表中的所有节点都按分值从小到大来排序。
obj指向一个字符串对象,而字符串对象则保存着一个SDS值。
在同一个跳跃表中,各个节点保存的成员对象 必须是唯一 的,但是多个节点保存的分值却可以是相同的:分值相同的节点将按照成员对象在字典中的大小来进行排序,成员对象较小的节点会排在前面 (靠近表头的方向),而成员对象较大的节点则会排在后面(靠近表尾的方向)。
backward用于从表尾到表头方向访问节点,并且只能后退到前一个节点。
level数组可以包含多个元素,每个元素都包含一个指向其他节点的指针,程序可以通过这些层来加快访问其他节点的速度,一般来说,层的数量越多,访问其他节点的速度就越快。
在每一次创建跳表节点时,程序根据幂次定律 (power law,越大的数出现的概率越小)随机生成一个介于 1 和 32 之间的值作为 level 数组的大小,这个大小就是层的"高度"。
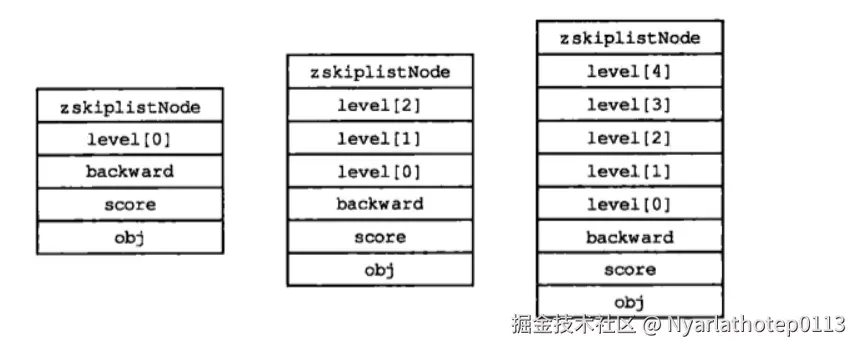 每一层中都有一个前进指针,用于从表头向表尾方向访问节点。 每一层也有一个跨度用于记录两个节点之间的距离:
- 两个节点之间的跨度越大, 它们相距得就越远。
- 指向
NULL的所有前进指针的跨度都为 0 , 因为它们没有连向任何节点。