🎬 博客主页:博主链接
🎥 本文由 M malloc 原创,首发于 CSDN🙉
🎄 学习专栏推荐:LeetCode刷题集!
🏅 欢迎点赞 👍 收藏 ⭐留言 📝 如有错误敬请指正!
📆 未来很长,值得我们全力奔赴更美好的生活✨
------------------❤️分割线❤️-------------------------
文章目录
-
- [😧 本章讨论的测试方法如下:](#😧 本章讨论的测试方法如下:)
- [😧白盒测试(White-Box Testing)](#😧白盒测试(White-Box Testing))
-
- [逻辑覆盖测试(Logic-Coverage Testing)](#逻辑覆盖测试(Logic-Coverage Testing))
- [等价划分(Equivalence Partitioning)](#等价划分(Equivalence Partitioning))
- [边界值分析(Boundary-Value Analysis)](#边界值分析(Boundary-Value Analysis))
- 四、如何巩固学习
😁在所有可能的测试用例中,哪个子集最有可能发现最多的错误?
对软件测试用例设计方法的研究为这个问题提供了答案。
😧 本章讨论的测试方法如下:
- 黑盒测试
- 白盒测试
- 等价类划分
- 边界值分析
- 因果图分析
- 错误测试
- 语句覆盖
- 判断覆盖
- 条件覆盖
- 判定/条件覆盖
- 多重条件覆盖
😧白盒测试(White-Box Testing)
逻辑覆盖测试(Logic-Coverage Testing)
白盒测试关注的是测试用例执行的程度或覆盖程序逻辑结构(源代码)的程 度。
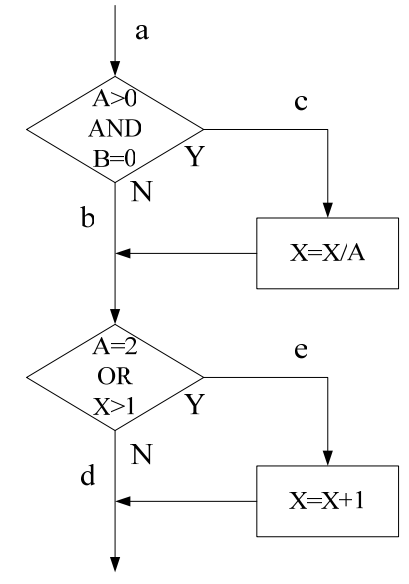
如果完全从路径测试中跳出来看,那么有价值的目标似乎就是将程序中的每条语句至少执行一次。遗憾的是,这恰是合理的白盒测试中较弱的准则。
等价划分(Equivalence Partitioning)
将一个好的测试用例描述为具有相当高的可能性发现某个错误来,
此外还讨论了对程序的穷举输入测试是无法实现的。因此,当测试某个程序时,我们就被限制在从所有可能的输入中努力找出某个小的子集。理所当然,我们要找的子集必须是正确的,并且是可能发现最多错误的子集。
确定这个子集的一种方法,就是要意识到一个精心挑选的测试用例还应具备另外两个特性:
- 严格控制测试用例的增加,减少为达到"合理测试"的某些既定日标而必须设计的其他测试用例的数量。
- 它覆盖了大部分其他可能的测试用例。也就是说,它会告诉我们,使用或不使用这个特定的输入集合,哪些错误会被发现,哪些会被遗漏掉。
使用等价划分方法设计测试用例主要有两个步骤:(1)确定等价类;(2)生成测试用例
- 确定等价类
确定等价类是选取每一个输入条件(通常是规格说明中的一个句子或短语)并将其划分为两个或更多的组。可以使用上述的表格来进行划分。
注意,我们确定了两类等价类:有效等价类代表对程序的有效输入,而无效等价类代表的则是其他任何可能的输入条件(即不正确的输入值)。
在给定了输入或外部条件之后,确定等价类大体上是一个启发式的过程。下面给出了一些指导原则:
- 如果输入条件规定了一个取值范围(例如,"数量可以是从 1 到 999"),那么就应确定出一个有效等价类(1<数量<999 ) ,以及两个无效等价类(数量<1,数量>999)。
- 如果输入条件规定了取值的个数(例如,"汽车可登记一至六名车主"),那么就应确定出一个有效等价类和两个无效等价类(没有车主,或车主多于六个)。
- 如果输入条件规定了一个输入值的集合,而且有理由认为程序会对每个值进行不同处理(例如,"交通工具的类型必须是公共汽车、卡车、出租车、火车或摩托车"),那么就应为每个输入值确定一个有效等价类和一个无效等价类(例如,"拖车")。
- 如果存在输入条件规定了"必须是"的情况,例如"标识符的第一个字符
必须是字母",那么就应确定一个有效等价类(首字符是字母)和一个无效等价类(首字符不是字母)。
- 生成测试用例
第二步是使用等价类来生成测试用例,其过程如下:- 为每个等价类设置一个不同的编号。
- 编写新的测试用例,尽可能多地覆盖那些尚未被涵盖的有效等价类,直到所有的有效等价类都被测试用例所覆盖(包含进去)。
- 编写新的用例,覆盖一个且仅一个尚未被覆盖的无效等价类,直到所有的无效等价类都被测试用例所覆盖。
边界值分析(Boundary-Value Analysis)
经验证明,考虑了边界条件的测试用例与其他没有考虑边界条件的测试用例相比,具有更高的测试回报率。所谓边界条件,是指输入和输出等价类中那些恰好处于边界、或超过边界、或在边界以下的状态。边界值分析方法与等价划分方法存在两方面的不同:
- 与从等价类中挑选出任意一个元素作为代表不同,边界值分析需要选择一个或多个元素,以便等价类的每个边界都经过一次测试。
- 与仅仅关注输入条件(输入空间)不同,还需要考虑从结果空间(输出等价类)设计测试用例。
四、如何巩固学习
提示:可阐述你是如何形成更系统和清晰的知识体系并进行回顾的
提醒:以上内容仅做参考,可自行发散。在发布作品前,请把不需要的内容删掉。