系统架构设计师-案例分析-数据库系统设计
ORM技术
ORM(Object-Relational Mapping),它在关系型数据库和对象之间作一个映射,在具体操作数据库的时候,就不需要再去和复杂的SQL语句打交道,只需像操作对象一样即可。
ORM把数据库映射成对象。如
- 数据库的表------》类
- 记录------》对象
- 字段------》对象的属性
ORM的优点:
- 使用ORM可以大大降低学习和开发成本;
- 程序员不用再写SQL来进行数据库操作;
- 减少程序的代码量
- 降低由于SQL代码质量差而带来的影响。
ORM的缺点:
- 不太容易处理复杂查询语句;
- 性能较直接用SQL差。
数据库类型比较
关系数据库模块与NoSQL模式的特征对比
| 特征 | 关系数据库模式 | NoSQL模式 |
|---|---|---|
| 并发支持 | 支持并发、效率低 | 并发性能高 |
| 存储与查询 | 关系表方式存储、SQL查询 | 海量数据存储、查询效率高 |
| 扩展方式 | 向上扩展 | 向外扩展 |
| 索引方式 | B树、哈希等 | 键值索引 |
| 应用领域 | 面向通用领域 | 特定应用领域 |
| 数据一致性 | 实时一致性 | 弱一致性 |
| 数据类型 | 结构化数据 | 非结构化 |
| 事务 | 高事务性 | 弱事务性 |
| 水平扩展 | 弱 | 强 |
| 数据容量 | 有限数据 | 海量数据 |
内存数据库与关系型数据库的对比
| 主要数据模型 | 读写性能 | 存储容量 | 可靠性 | |
|---|---|---|---|---|
| 内存数据库 | 键-值对模式 | 内存直接读写,性能相对较高 | 基于内存存储,存储容量受限 | 恢复机制复杂可靠性较低 |
| 关系型数据库 | 关系模式 | 外村读写,性能相对较低 | 基于存盘存储,存储容量大 | 内建恢复机制,可靠性较高 |
关系型数据库与文件系统的对比
| 设计难度 | 数据冗余程度 | 数据架构 | 应用扩展性 | |
|---|---|---|---|---|
| 关系型数据库 | 针对特定应用系统设计,难度较大 | 遵守数据库范式,数据冗余较小 | 以数据库为中心组织,管理数据 | 数据库独立于应用系统,数据库系统接口标准化,易于在不同应用之间共享数据 |
| 文件系统 | 针对特定应用系统设计,难度较小 | 可能在多个文件中复制相同的数据属性,数据冗余较大 | 以应用为中心管理数据 | 符合特定应用系统要求的文件数据很难在不同的应用系统之间共享 |
缓存技术
Redis
Redis是一个开源的使用ANSIC语言编写、支持网络、可基于内存亦可持久化的日志型、Key-Value数据库,并提供多种语言的API。
Redis数据类型表
| 数据类型 | 存储的值 | 说明 | 应用场景 |
|---|---|---|---|
| string | 字符串、整数或浮点数 | 基本类型 | 可用于缓存层、计数器、共享用户Session、分布式锁、分布式系统的全局序列号等。 |
| list | 列表 | 字符串列表,可以模拟栈、队列等形式 | 栈、队列、阻塞队列、最新列表等,如回复评论、点赞、粉丝列表 |
| set | 无序集合 | 每个值不能重复 | 用户标签、好友/关注/粉丝/感兴趣的人集合、随机展示、黑/白名单、抽奖小程序等 |
| hash | 包括键值对的无序散列表 | key-value对的一种集合,特别适合用于存储对象 | 存储对象、电商购物车等 |
| zset | 有序集合 | 每个元素有一个分数 | 排名,如推荐排名前10的热门帖子 |
MemCache
MemCache是一个高性能的分布式的内存对象缓存系统,用于动态Web应用以减轻数据库负担。MemCache通过在内存里维护一个统一的巨大的Hash表,它能够用来存储各种格式的数据,包括图像、视频、文件以及数据库检索的结果等。
Redis与MemCache的差异:
- 数据类型方面。Redis和Memcache都是将数据存放在内存中,都是内存数据库。他们都支持键值对数据类型。同时MemCache还可以用于缓存其他东西,如图片、视频等,Redis还支持List、Set、Hash等数据结构的存储
- 内存管理机制方面。在Redis中,并不是所有的数据都一直存储在内存中的,这是和MemCache相比一个最大的区别。当物理内存用完时,Redis可以将一些很久没用到的Value交换到磁盘。而在MamCache中,数据都是缓存在内存中。
- 数据持久化方面。Redis支持内存数据的持久化,而且提供两种主要的持久化策略:RDB快照和AOF日志。MemCache不支持数据持久化操作。Redis支持数据的备份,即master-slave模式的数据备份。Memcache宕机后,数据不可恢复,Redis数据丢失后可以通过AOF恢复。
Redis与MamCache能力比较
| 特征 | Redis | Memcache |
|---|---|---|
| 数据类型 | 丰富的数据结构 | 简单key/value结构 |
| 持久化 | 支持 | 不支持 |
| 分布式存储 | 多种方式,主从、哨兵、Cluster等 | 客户端哈希分片/一致性哈希分片 |
| 多线程支持 | 不支持 | 支持 |
| 内存管理 | 无 | 私有内存池/内存池 |
| 事务支持 | 有限支持 | 不支持 |
缓存中的常见问题:
- 缓存击穿:在高并发访问下,被频繁访问的数据项在缓存中失效时,大量的并发请求会直接涌入后端存储数据库上,导致数据负载增大。缓存可以通过使用互斥锁、分布式锁、热点数据预加载等方式来避免
- 雪崩:是指缓存层整体失效,导致大量请求涌入后端。雪崩问题可以通过设置不同的过期时间、使用多个独立的缓存集群等来避免。
- 缓存穿透:请求查询体格不存在于缓存和数据库中的键。缓存穿透可以使用布隆过滤器来判断请求的键是否有效,从而减轻数据库压力。
分布式锁
分布式锁是是一种在分布式系统环境下,通过多个节点对共享资源进行访问控制的一种同步机制。它的主要目的是防止多个节点同时操作同一份数据,从而避免数据的不一致性。
实现分布式锁的方式:
- 使用MySQL,基于唯一索引
- 使用ZooKeeper,基于临时有序节点
- 使用Redis,基于setnx命令。
解决死锁的策略:设置锁的超时时间、使用Redlock算法、引入锁的等级、使用一致性哈希算法以及使用锁粒度更小的方式等。
规范化
不规范化带来的四大问题
- 数据冗余:数据被重复存储。
- 修改异常:修改导致数据不一致。
- 插入异常
- 删除异常:删除了不该删除的数据。
反规范化技术
规范化设计后,数据库设计者希望牺牲部分规范化来提高性能,这种从规范化设计的回退方法称为反规范化技术。
采用反规范化技术的益处:降低连接操作的需求、降低外键和索引的数目,还可能减少表的数目,能够提高查询效率。
可能带来的问题:
- 数据的重复存储,浪费磁盘空间
- 数据的完整性问题,为了保障数据的一致性,增加了数据维护的复杂性,会降低修改速度
- 增加冗余列:在多个表中保留相同的列,通过增加数据冗余减少或避免查询时的连接操作。
- 增加派生列:在表中增加可以由本表或其他表中数据计算生成的列,减少查询的连接操作并避免计算或使用集合函数。
- 重新组表:如果许多用户需要查看两个表连接出来的结果数据,则把这两个表重新组成一个表来减少连接而提高性能。
- 水平分割表:根据一列或多列数据的值,把数据放到多个独立的表中,主要用于表数据规模很大、表中数据相对独立或数据需要存放到多个介质上时使用。
- 垂直分割表:对表进行分割,将主键与部分列放到一个表中,主键与其他列放到另一个表中,在查询时减少I/O次数。
并发控制
并发操作就是在多用户系统中,可能出现多个事务同时操作同一数据的情况。并发操作会导致3种数据不一致问题。
- 丢失更新
当两个事务T1和T2读入同一数据做修改,并发执行时,T1把T2或T2把T1的修改结果覆盖掉,造成了数据的丢失更新问题,导致数据不一致。 - 不可重复读
事务T1读取了数据R,事务T2读取并更新了数据R。当事务T1再读取数据R进行核对时,得到的两次读取数据不一致。 - 读脏数据
事务T1更新了数据R,事务T2读取了更新后的数据R,事务T1由于某种原因被撤销,进行了数据回滚,数据R恢复原值,事务T2读取了脏数据。
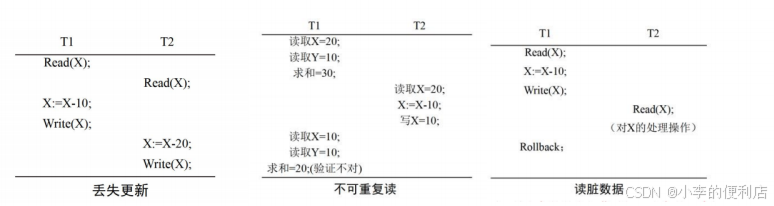
造成以上3种数据不一致的主要原因就是事务的并发操作破坏了事务的隔离性。
封锁协议
并发控制的主要技术是封锁(Lock)技术。
两种封锁协议
| 基本封锁类型 | 特点 |
|---|---|
| 排他锁(X锁) | 事务T对数据A加X锁:(1)只允许事务T读取、修改数据A;(2)只有等该锁解除之后,其他事务才能够对数据A加任何锁类型。 |
| 共享锁(S锁) | 解决了X锁太严格,不允许其他事务并发读的问题。事务T对数据A加S锁,则:(1)只允许事务T读取数据A但不能够修改;(2)可允许其他事务对其加S锁,但不允许加X锁。 |
加锁遵循一个基本原则:如果该事务只读数据,就只加读锁;如果该事务要写数据,就加写锁。
分布式数据库
分布式数据库是由一组数据组成的,这组数据分布在计算机网络的不同计算机上,网络中的每个节点具有独立处理的能力,它可以执行局部应用,同时,每个节点也能通过网络通信子系统执行全局应用。分布式数据库系统是在集中式数据库技术的基础上发展起来的。
特点:
- 数据独立性。
- 集中与自治共享结合的控制结构。
- 适当增加数据冗余度
- 全局一致性、可串行性和可恢复性
分布式数据库的优点:
- 分布式数据库可以解决企业部门分散而数据需要相互联系的问题。
- 如果企业需要增加新的相对自主的部门来扩充机构,则分布式数据库可以在对当前机构影响最小的情况下进行扩充
- 分布式数据库可以满足均衡负载的需要
- 当企业已存在几个数据库系统,而且实现全局应用的必要性增加时,就可以由这些数据库自上而下构成分布式数据库系统
- 相对规模的分布式数据库系统在出现故障的概率上不会比集中式数据库系统低,但由于其故障的影响仅限于局部数据应用,因此,就整个系统来说,它的可靠性是比较高的。
数据分片
数据分片将数据库整体逻辑结构分解为合适的逻辑单位,然后由分布模式来定义片段及其副本在各场地的物理分布,其主要目的是提高访问的局部性,有利于按照用户的需求,组织数据的分布和控制数据的冗余度。
- 水平分片。水平分片将一个全局关系中元组分裂成多个子集,每个子集为一个片段。分片条件由关系中的属性值表示。对于水平分片,重构全局关系可通过关系的并操作实现。
- 垂直分片。垂直分片将一个全局关系按属性分裂成多个子集,应满足不相交性。对于垂直分片,重构全局关系可通过连接运算实现。
- 导出分片。导出分片又称为导出水平分片,即水平分片的条件不是本关系属性的条件,而是其他关系属性的条件。
- 混合分片。混合分片就是在分片中采用水平分片和垂直分片两种形式的混合。
分布透明性是指用户不必关心数据的逻辑分片,不必关心数据存储的物理位置分配细节,也不必关心局部场地上数据库的数据模型。
- 分片透明性是分布透明性的最高层次,它是指用户或应用程序只对全局关系进行操作而不必考虑数据的分片。
- 位置透明。位置透明是指用户或应用程序应当了解分片情况,但不必了解片段的存储场地。
- 局部数据模型透明性。局部数据模型透明性是指用户或应用程序应当了解分片及各分片存储的场地,但不必了解局部场地上使用的是何种数据模型。
数据仓库
数据仓库集成是把多种来源的数据集中在一起,建立数据仓库,所有数据都驻留在单个数据库服务器上,配置大型处理器和存储容量。数据仓库主要用于决策支持,在数据处理过程中强调分析。其特点是:集成的数据、面向主题、数据相对稳定、包含历史信息
数据仓库的结构通常包含四个层次:
- 数据源:是数据仓库系统的基础,是整个系统的数据源泉
- 数据的存储与管理:是整个数据仓库系统的核心
- OLAP(联机分析处理)服务器:对分析需要的数据进行有效集成,按多维模型组织,以便进行多角度、多层次的分析,并发现趋势。
- 前端工具:主要包括各种报表工具、查询工具、数据分析工具、数据挖掘工具以及各种基于数据仓库或数据集市的应用开发工具。