FireRed-Image-Edit
github地址:github.com/FireRedTeam...
FireRed-Image-Edit 项目概览
FireRed-Image-Edit 是由 FireRedTeam(小红书智能创作团队)开源的通用图像编辑大模型。该模型基于扩散模型(Diffusion)架构,专为"按指令编辑图片"而设计。
通俗理解:它是 Photoshop 与 Stable Diffusion 的结合体,但只需输入自然语言即可完成复杂编辑任务。
1. 核心定位
- 类型:Instruction-driven(指令驱动)图像编辑模型
- 输入输出:Text + Image →→ Edited Image
- 应用场景:内容创作、电商设计、AI 工具开发、视觉增强
2. 六大核心能力
1. 强大的图像编辑能力
无需手动抠图或分层,仅需一句话即可修改图片(如更换背景、替换衣物、添加物体)。模型能自动理解复杂需求。
- 示例:"把这张照片改成日落场景,并给人物加墨镜"
2. 身份一致性 (SOTA 水平)
在 AI 编辑领域保持人物特征不变是难点,该模型在此方面表现卓越(State-of-the-Art)。修改后,人物的脸部、五官及核心特征依然保持原样。
3. 多图融合 (Multi-image)
支持输入多张图片进行智能组合。系统可自动完成裁剪与拼接。
- 典型场景:虚拟试穿(A 人物 + B 衣服 →→ 合成试穿图)
4. 文本与字体编辑能力
可修改图片中的文字内容,同时完美保留原有字体风格。这一点解决了多数模型无法保持字体一致性的痛点。
5. 图像修复与美化
- 老照片修复:提升清晰度,去除瑕疵。
- 人像优化:支持美颜、妆容调整及细节增强。
6. 多任务统一模型
一个模型即可覆盖多种任务,无需切换不同模型:
- 图像编辑与生成
- 风格迁移
- 修复增强
- 虚拟试穿
3. 技术架构解析
| 维度 | 详细说明 |
|---|---|
| 模型架构 | 基于 Diffusion Transformer,支持文本条件、图像条件及多模态融合。 |
| 训练规模 | 约 16 亿 (1.6B) 数据样本(包含文本 - 图像对、专业图像编辑对)。 |
| 训练流程 | 预训练 (Pretrain) →→ 监督微调 (SFT) →→ 强化学习优化 (RL)。 |
| 性能优化 | 支持模型蒸馏与量化;在高端 GPU 下推理速度约为 4.5 秒/张。 |
4. 性能表现与生态
-
基准测试:在 ImgEdit、GEdit 等权威图像编辑基准中达到或超越 SOTA(State-of-the-Art)。
-
人类评测:指令理解能力更强,图像一致性显著优于竞品。
-
工程生态:
- 开源协议:Apache-2.0(支持本地部署)
- 工具链:原生支持 ComfyUI 节点、LoRA 微调扩展。
5. GitHub 仓库内容
通常包含以下核心组件:
- 推理代码 (Inference Scripts)
- 模型加载与配置方式
- ComfyUI 专用节点
- 示例 Prompt 库
- LoRA 扩展包
6. 适用人群
- AI 开发者:构建修图、换装、设计类 AI 产品。
- 内容创作者:快速生成电商海报、营销素材。
- 研究人员:研究 Diffusion + Editing 算法方向。
7. 局限与注意点
根据社区反馈及模型特性,需注意以下限制:
- 分辨率支持:超高分辨率输出仍需优化(建议配合放大插件使用)。
- 极端角度:人脸在极端角度变化下的保持一致性仍有挑战。
- 硬件要求:完整版模型需要较高的 GPU 显存。
8. 总结
FireRed-Image-Edit 是当前最强的开源"图像编辑型大模型"之一。其核心优势在于:一句话改图、高身份一致性、以及强大的多图融合能力。
懒人包使用
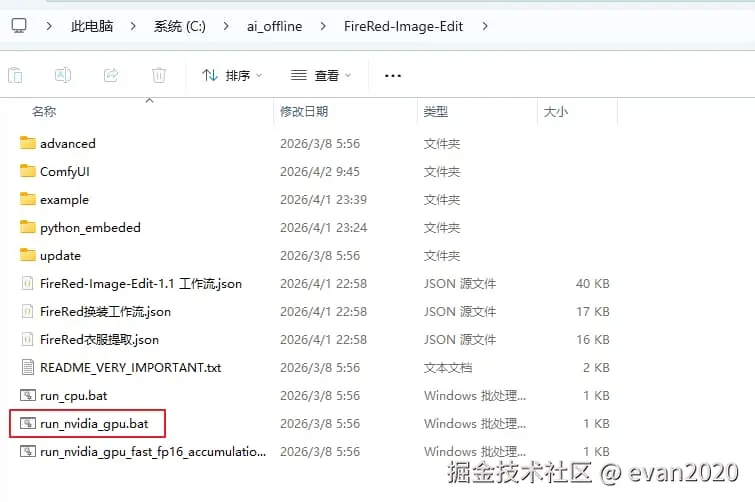
双击run_nvidia_gpu.bat
终端启动
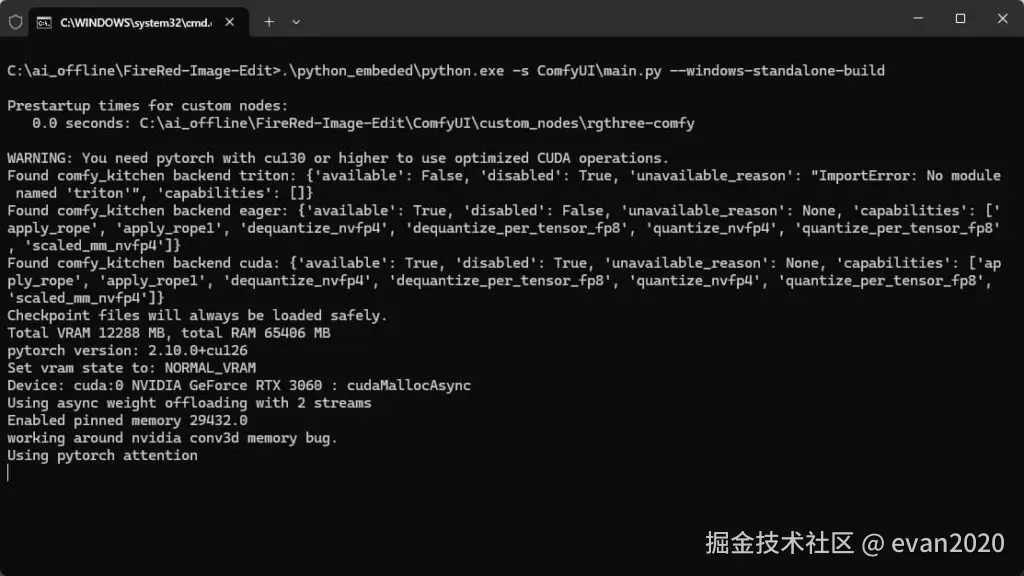
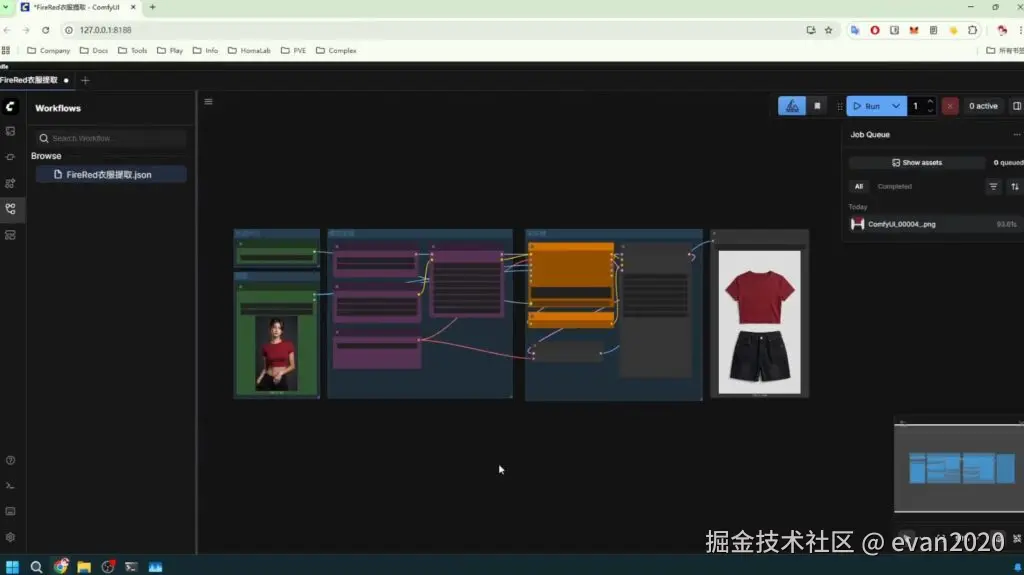
会自动打开浏览器
选择人物图片,点击run,就可以获取对应的衣物图片
Tips
点击此处 网盘下载
如果网页里面没有提取衣物工作流,可以把懒人包里面的文件(FireRed衣服提取.json),直接拖拽到网页,就有了工作流,ctrl+s保存
如果点击run报错,提示找不到对应的模型,报红框错误(需要手动点击模型,选择模型)
如果遇到红框问题,可以查看本文视频