微调就是在已经训练好的基座大模型上,用你自己的数据集继续训练,让模型更符合你的特定需求。
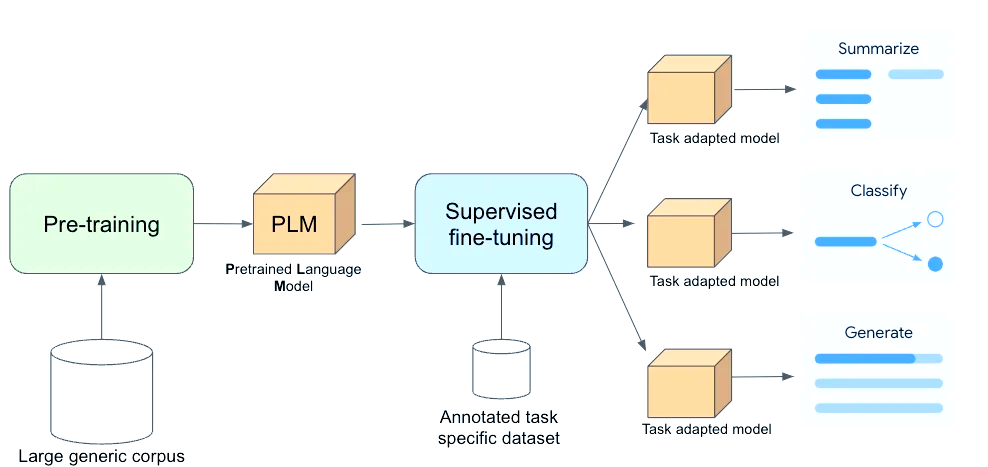
有哪几种方式
1.按参数更新规模分类(教它什么?)
- 全量微调(Full Fine-Tuning,简称FFT)
更新模型所有参数
优点:性能上限最高
缺点:训练成本高,容易过拟合。容易出现灾难性遗忘
- 参数高效微调(Parameter-Efficient Fine-Tuning,简称PEFT)
只更新/添加极少量参数(通常<1%甚至<0.1%),原始权重大多冻结
优点:训练速度快
缺点:极端情况下性能可能略低于全参数,但实际差距已非常小。
PEFT内部又细分为几种经典技术
-
- Adapter Tuning(适配器微调):在Transformer层中插入小型可训练的Adapter模块
- LoRA及其变体(目前最流行)
-
-
- LoRA(Low-Rank Adaptation):在权重矩阵旁添加低秩矩阵。
- QLoRA(量化LoRA):结合4bit量化,进一步降低显存(单卡即可微调70B模型)
-
-
- Prompt Tuning :不改动模型内部网络,只在输入的 Prompt 层面加上一些"虚拟的、可被机器训练的 Token"。显存占用极小,但 对复杂任务(如控制机械臂)效果往往不如 LoRA
2.按训练目标 / 数据类型分类(怎么教它?)
- 监督微调 (Supervised Fine-Tuning, SFT)
使用指令-标签对 数据进行训练
- 对齐微调 / 偏好训练
让模型输出更符合人类偏好(有用、无害、诚实)
常见方法:
-
- RLHF (Reinforcement Learning from Human Feedback,基于人类反馈的强化学习):不直接给标准答案,而让模型自己生成几个答案,然后让人类 或打分模型)来评价"哪个更好",用扣分和加分来引导它。 效果好但流程复杂、不稳定。
- DPO (Direct Preference Optimization,直接偏好优化) :RLHF 的升级版。RLHF 过程太复杂 (需要同时跑好几个模型),DPO 直接通过数学推导,把"选 A 不选 B"的偏好直接融合到类似 SFT 的训练流程里,大大简化了训练难度。
- 其他辅助分类
• 继续预训练(Continued Pre-training):用领域无标签数据继续做下一token预测(类似预训练),常用于领域适应(如金融、医疗),之后再接SFT。
• 部分参数微调(Partial / Layer-wise):只调最后几层或特定层(介于全参数和PEFT之间,早期的做法)。
• 无监督微调:较少见,通常指继续预训练。