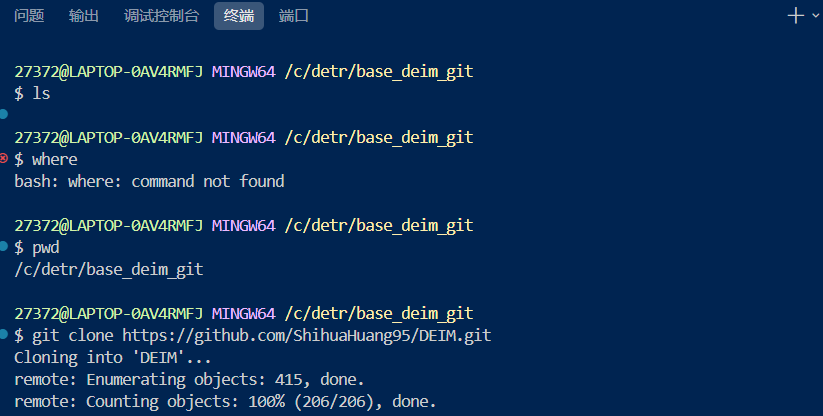
新建了一个文件夹,专门想学习跑一下deim,这里吧git的项目的源代码克隆过去了。
这里命令会:从 GitHub 下载整个 DEIM 项目;自动创建一个 DEIM 文件夹;把代码、配置文件、文档全部放进去
cd DEIM 导航过去看看 readme 说了啥
准备一个demo数据集(原始图片就行),只有训练的时候才需要做标注,所以jpg,png都可以;扔进去就能跑
转换格式会自动读取 images labels 和classes.txt
训练思路:
首先,你得有数据。VisDrone 数据集下载下来,是图片加 txt 标注的格式。但 DEIM 这个模型认的是 COCO 格式,也就是 JSON 文件。所以你要做个转换,把 VisDrone 的 txt 转成 COCO 的 JSON,生成 train.json 和 val.json。转换完,数据就准备好了。
第二步:理解配置文件的"接力赛"
DEIM 的训练不是单个文件能搞定的,是一堆配置文件"接力"完成的。你得搞清楚这个接力顺序,不然就会像我一开始那样,踩进坑里。
跑代码的入口
你运行命令时指定的 -c configs/deim_dfine/deim_hgnetv2_s_visdrone.yml,这就是第一棒 ,是总入口。它里面写了 __include__,意思是:"我跑完了,接下来交给后面的人"。
第一棒交给谁?
deim_hgnetv2_s_visdrone.yml 里 include 了两个:
-
dfine_hgnetv2_s_coco.yml------ 网络结构(backbone、encoder、decoder 这些) -
deim.yml------ 训练策略(优化器、损失函数、学习率调度)
关键转折点:第二棒又交给谁?
dfine_hgnetv2_s_coco.yml 自己也有一堆 include,其中有个 coco_detection.yml。这就是坑所在!
coco_detection.yml 里写的是 COCO 数据集的路径:/datassd/COCO/train2017/ 这些。如果不管它,训练就会去加载 COCO 数据,而不是你的 VisDrone。
第三步:我的误区
我一开始以为,只要在 deim_hgnetv2_s_visdrone.yml 里多加一个 include,把 visdrone_detection.yml 塞进去,就能覆盖 COCO 的配置。
错了!
因为 dfine_hgnetv2_s_coco.yml 先被加载,它里面的 coco_detection.yml 已经把所有数据配置(路径、transforms、policy)都定死了。后面再加 visdrone_detection.yml,要么覆盖不干净,要么干脆被忽略,导致配置混成一团,训练报错。
第四步:正确的"偷梁换柱"
既然 dfine_hgnetv2_s_coco.yml 是必经之路,那就在源头动手脚。
把 dfine_hgnetv2_s_coco.yml 里的:
'../dataset/coco_detection.yml'改成:
'../dataset/visdrone_detection.yml'这样,当 deim_hgnetv2_s_visdrone.yml → dfine_hgnetv2_s_coco.yml → 数据集配置时,自然就走到了 VisDrone 的路径,而不是 COCO。
同时,deim_hgnetv2_s_visdrone.yml 里那个多余的 visdrone_detection.yml include 可以注释掉,因为数据流已经通过 dfine_hgnetv2_s_coco.yml 拿到了 VisDrone 配置,不需要重复加载。
第五步:VisDrone 配置里写什么?
visdrone_detection.yml 要完整,不能偷懒只写路径。因为 COCO 配置里原本有完整的 transforms(Mosaic、数据增强、ConvertPILImage 这些),你替换的文件也得有,不然图像格式转换会出错。
所以 visdrone_detection.yml 里要有:
-
num_classes: 10(VisDrone 10 类) -
img_folder和ann_file指向你的 VisDrone 路径 -
完整的
transforms和policy(从 COCO 配置复制过来,改都不用改)
第六步:调 batch size 和训练
配置通了,开始训练。3090 的 24GB 显存,batch size 4 太浪费,24 又爆内存。最后调到 12 或 8,配合显存优化,稳稳当当跑完 132 个 epoch。
模型验证与测试集探索
第一轮跑完,学习一下怎么用测试集 看看模型到底行不行
1. 找到训练成果
从 outputs/deim_hgnetv2_s_visdrone19/ 里找到 best_stg1.pth,这是第一轮训练最好的模型权重。
知识点:模型保存机制
-
best_stg1.pth:验证集上表现最好的模型(根据mAP自动保存) -
last.pth:最后一轮训练的模型(可能过拟合或欠拟合) -
通常用
best而不是last,因为中间某轮可能最优、
2. 验证集(val)的作用
用默认配置跑测试,看到 AP=0.3%。
知识点:为什么需要验证集?
-
训练集(train):模型学习用,见过这些图
-
验证集(val):模拟考试,模型没见过,能真实反映泛化能力
-
测试集(test):真考试,最终检验
如果直接用 train 评估 = 自己改自己作业,分数虚高!
3. 测试集(test-dev)的探索
把配置改成 test-dev,想跑更大规模测试。
知识点:官方 vs 非官方 test-dev
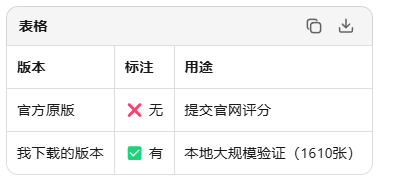
意外发现:我的 test.json 里有完整标注,能算mAP!
4. 对比验证集和测试集结果
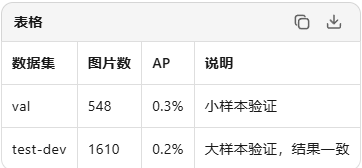
知识点:为什么test-dev AP更低?
-
图片更多(1610 vs 548),更难"蒙对"
-
分布可能略有差异
-
但0.2% vs 0.3% 差不多,说明模型确实没训好
5. 论文指标提取
从日志拿到这些关键数据:
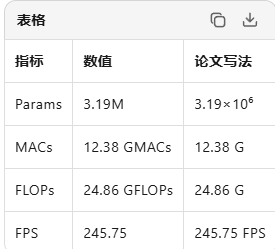
知识点:MACs vs FLOPs
-
MACs(乘加运算):1 MAC = 2 FLOPs(乘+加)
-
论文通常写 FLOPs 或 MACs,看会议要求
第一轮训完 → val验证发现AP只有0.3% → test-dev大规模验证确认效果差 → 提取论文指标 → 必须继续Stage 2优化才能用
总之第一天跑通数据集代码还是很开心的,想自己记录一下思考和学习的过程,虽然借助了ai,但是自己也慢慢学会发现报错的原因并且自己解决,还是有进步啦啦啦~~