ESP32-S3-CAM:豆包语音识别文字后控制小车(规划)

最近一直很忙,有半个月没折腾板子了,但一直都有个想法,搞个复杂一丢丢的需求,通过MIC拾音,然后豆包后台接口去识别语音内容,转成文字后,再控制小车前进还是后退。

这个完整需求要分成几个步骤:

  1. 注册豆包火山引擎开发者接口
  2. 选择豆包语音识别模型
  3. 跑通豆包语音识别接口官方给的python demo
  4. 转换官方demo代码为C代码跑到板子上
  5. 增加mic拾音后通过豆包语音识别后转文字输出
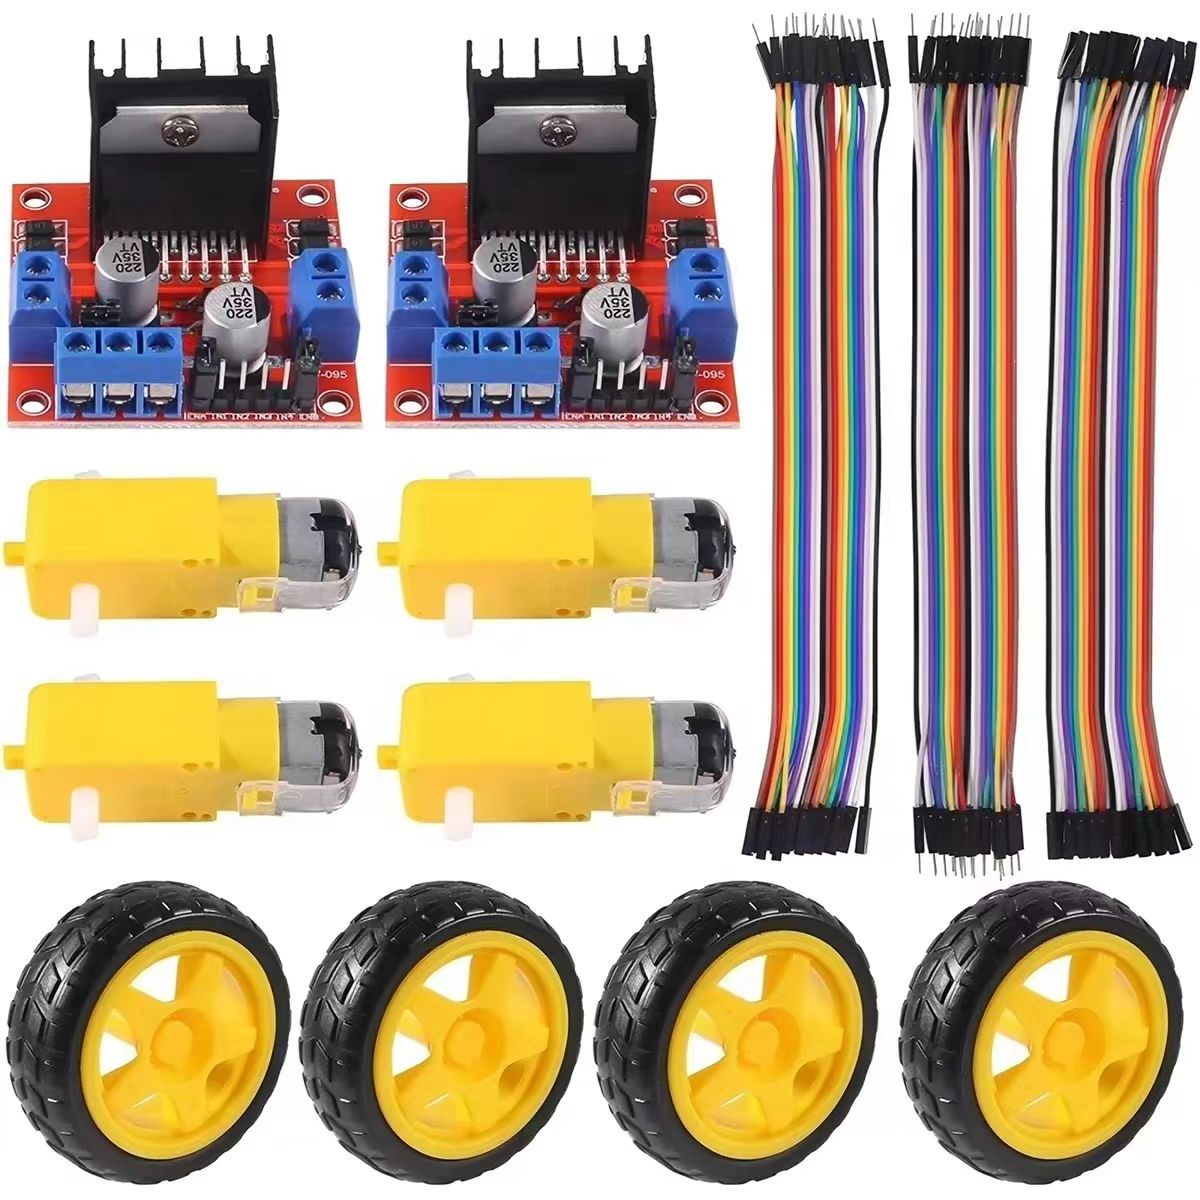
  6. 通过L298N电机+ESP32-S3-CAM芯片驱动小车
  7. 语音识别转文字后根据指令控制小车前进和后退

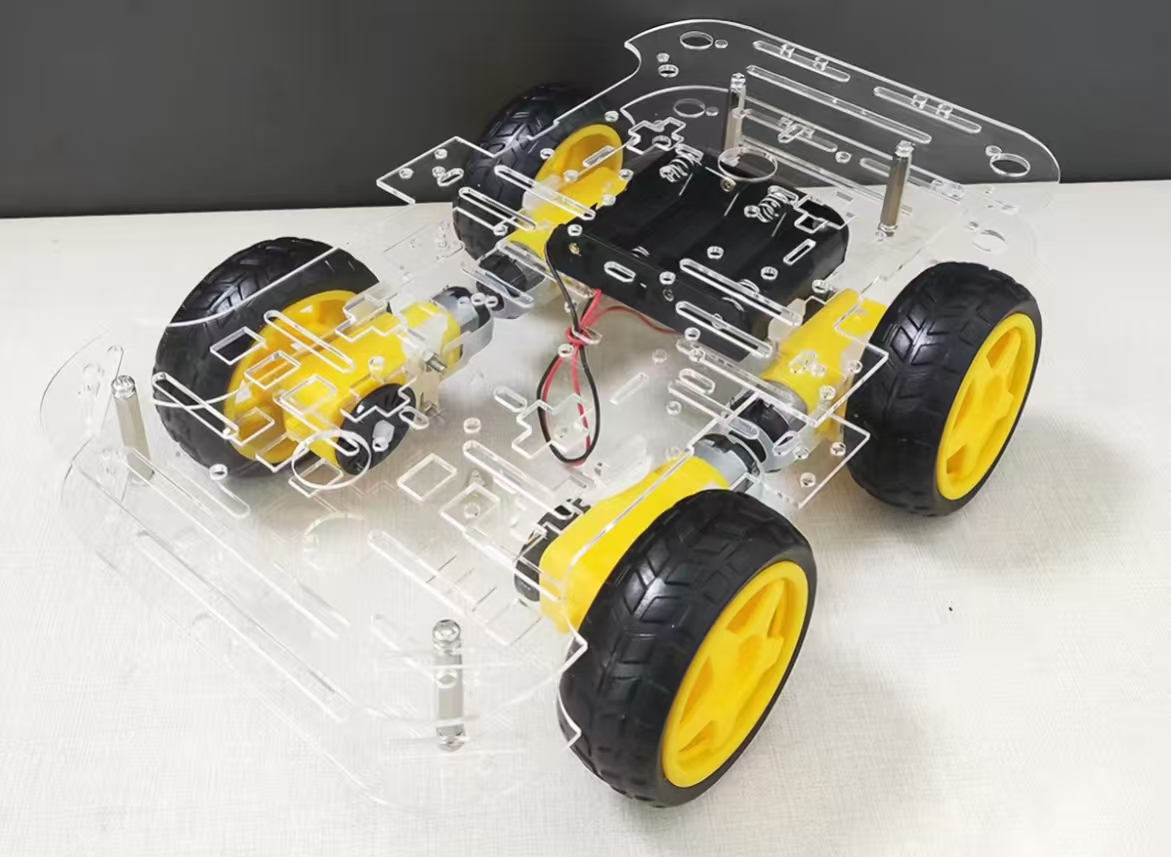
前期准备工作:淘宝买了些硬件,刚开始没经验,其实不仅仅要买轮子,还得买个车架子。
买回来发现组装也挺有意思的,不过这玩意比较脆,中间那两个车板子容易碎,具体怎么装小车后面单独帖子介绍。

ESP32-S3-CAM:豆包语音识别文字后控制小车(一)------注册豆包火山引擎开发者接口

相关推荐
狒狒AI2 分钟前
Remotion / GSAP+Three / HyperFrames / Skia 四栈实测:代码渲染知识视频的选栈方法(附开源技能)
前端·人工智能·aigc
自养Agent7 分钟前
Agent Harness 从用到会造:报错的那层,往往不是坏掉的那层
人工智能
RockChinQ7 分钟前
一个 Telegram 群,三条事件路由:欢迎、群规问答与群管理各归一个 Agent
人工智能
果霸大叔10 分钟前
从根上吃透AI Agent:Agent拆解系列之DeerFlow2.0深度拆解
人工智能
2025的限定小孙11 分钟前
AI自己写的SQL自己跑?把执行权从模型手里拿走的三层闸
人工智能
用户4270192301212 分钟前
排障实录 :OpenClaw 升级失败三次,我是怎么把系统救回来的
人工智能
不加辣椒14 分钟前
第 14 章 控制项选型:成本模型与决策框架
人工智能
fanjianzhihui15 分钟前
对话录音质检系统的工程实践:从语音识别到LLM判定的误差控制
人工智能·语音识别
程序员如山石16 分钟前
AI主流开发环境搭建过程
人工智能·程序员
snakeshe101016 分钟前
Linux 下 Ollama 完整实操指南:安装、部署大模型与开启远程访问
人工智能