为什么复制粘贴就乱码了呢?这就要提到一个字体中的概念----Unicode映射。字体文件的本质就是矢量绘图,而复制粘贴需要知道文字的Unicode码,把这个码放到剪贴板里面,其它的软件才会知道是什么字。正规的字体文件,都会带一个Unicode映射表,这个表会告诉软件字体中的第几个字对应的是Unicode中的哪一个字的编码。然后我们才能正确地复制粘贴。由于某些PDF文档在制作的时候,有意将Unicode映射表删掉了,造成我们无法得知复制的字对应的是Unicode的哪一个字,所以无法复制粘贴文档中的文本。这是一个很简单,也很有效的文档反拷贝手段。
软件使用方法:
1、文件菜单打开PDF。或者直接拖拽文档到软件窗口。
2、点击字体名称,查看字体属性,是否嵌入。本软件只处理嵌入字体,不处理Type3类型的pdf自绘字体。
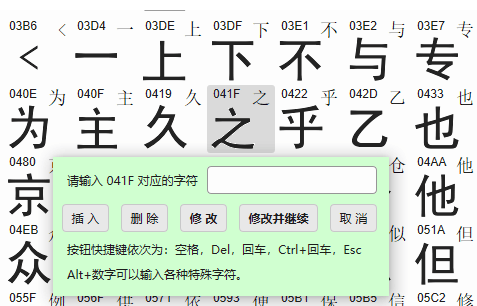
3、按F4,识别右侧窗口中渲染出来的全部字符。点击字符图像可以人工校正。具有插入、删除、修改、修改并继续,等多个功能。
4、按F2,保存当前字体的Unicode映射。
5、如此循环,处理全部需要补充映射的字体。
6、文件菜单--保存PDF
运行环境:
1、由于使用最新的Direct2D构建UI,操作系统要求Windows 22H2或更高,64位操作系统。并安装最新补丁。
2、需要CPU支持SSE4.2、AES、AVX2指令集,否则本软件无法启动。
3、需要显卡支持DirectX 11, Direct 2D。
4、由于OCR比较吃CPU和内存,运行速度与CPU和内存大小有关。电脑配置不要低于8G内存。处理大量字体建议32G内存。
5、不支持Windows7、8、vista和早期的Windows10版本(低于1809)。
6、不支持32位操作系统。
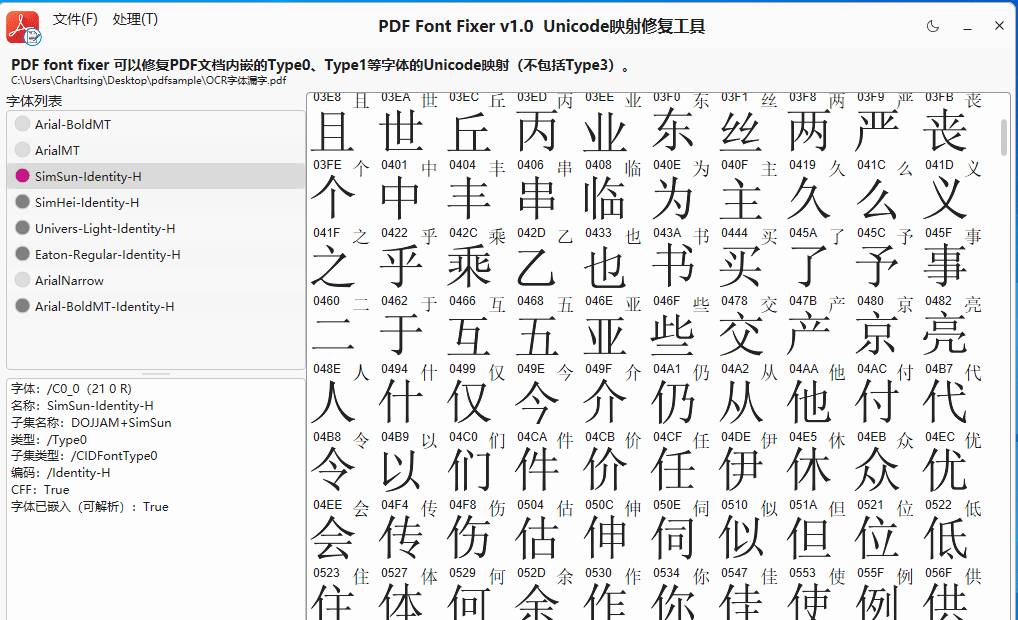
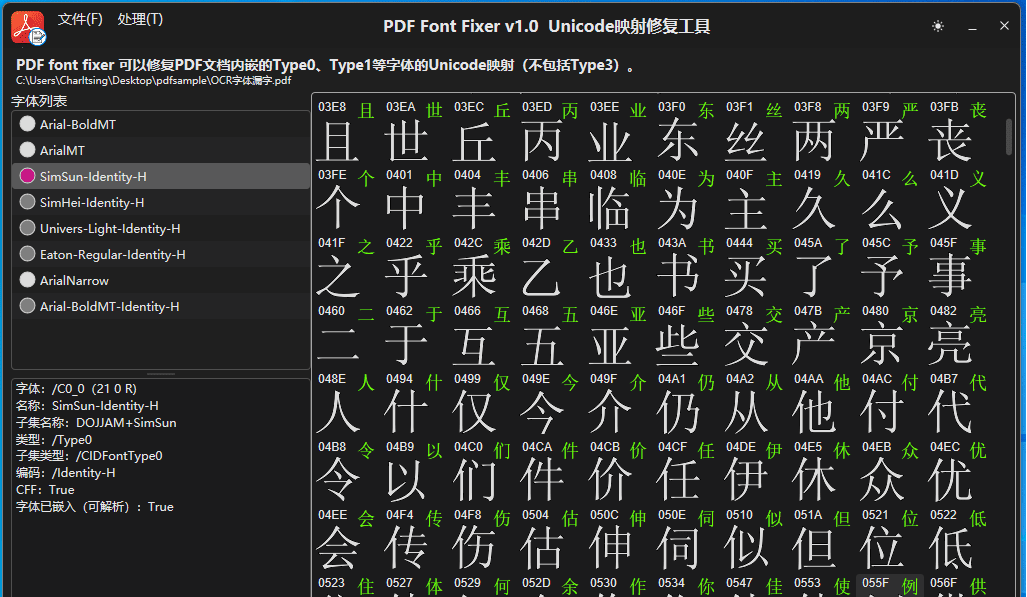
其实,修复PDF字体并不难,市面上也有若干软件支持修复,只是大多为商业版。实现字体修复的难点不在于为PDF字体创建Unicode映射,而在于如何快速准确识别几百~几千个汉字。前些年不怎么具备本机仅使用CPU进行快速OCR的条件,去年随着OCR小模型的进步,目前已经可以实现本机使用普通CPU对汉字进行快速识别。经测试,小模型仅依赖CPU就可以对印刷体汉字进行识别,几百个汉字图像的识别耗时只有1~2秒。不考虑特殊符号的话,实测识别准确率可以达到100%。这就给PDF修复字体缺失的Unicode映射解决了最大的麻烦。
分享了「PDFontFixer-v1.3 .rar」