AI漫剧工具复刻实战:用 React Flow 搭一个前端的无限画布,复刻 TapNow / LiblibTV 的核心交互
AI漫剧,正在慢慢变成一个越来越明确的内容生产方向。
而一个真正好用的工具,本质上就是为了加速 漫剧视频的量产 。现在市面上的工具已经不少了,比如 TapNow、Lovart、LiblibTV 等,它们有一个非常共同的特点:
用可视化拖拽的方式,把角色、场景、素材、提示词等内容组织起来,再组合生成对应的图片或分镜图。
这套方式为什么好用?因为它比纯文生图更可控。
文生图很多时候像抽卡,提示词差一点、语义偏一点,画面就会歪;而图生图或者"角色节点 + 场景节点 + 关系编排"这种方式,会更接近真正的生产流程。尤其是漫剧、漫画分镜、角色一致性、场景延续性这些场景,可控性比随机性更重要。
比如现在很多人用的 gemini3.1-flash(香蕉2) ,在这类能力上已经相当不错;而最近还有"新王登基"的讨论,比如 gpt-image-2。当然,最后到底选哪一个,不是看谁最热,而是看:
- 价格能不能扛住
- 生成效果稳不稳
- 一致性是否够好
- 接口是否容易接入
- 批量生产成本是否可控
所以问题就变得很直接了:
如果把无限画布的前端实现出来,再去对接第三方平台 API,就能做出一套属于自己的 AI 漫剧生产工具。
这件事最吸引我的地方在于:可控。
因为市面上的 SaaS 工具再怎么更新,终究不是你自己的;但如果你把前端画布、节点交互、后端 API 调度都掌握在自己手里,那么迭代节奏、功能方向、成本结构,全部都可以自己定。
当然,前提是你得会一点 AI 编程。
古法编程会不会淘汰我不敢乱说,但有一件事是确定的:
现在一个人复刻一个大厂产品的雏形,比一年前现实太多了。
以前你很难想象:
- 一个人
- 不是资深高级程序员
- 靠 AI 帮你分析、拆解、写代码、修 Bug
- 最后真的把一个"无限画布编辑器"搭到可用
但现在这件事,真的已经可以做了。
我的流程其实很简单:
- 截图对标网站
- 让 GPT 分析页面和交互
- 给 AI 编程工具下达明确需求
- 自己做验收、提 Bug、继续修
- 最后用浏览器自动化测试,反复收敛功能
本质上就是:
人来负责需求和判断,AI 来负责实现和执行。
废话不多说,下面开始正式复刻。
一、整体思路:先截图,再分析,再复刻
我的思路很简单:
先把对标网站的核心界面截图下来,然后交给 GPT 去分析它到底用了什么样的产品结构、交互逻辑和可能的技术实现。
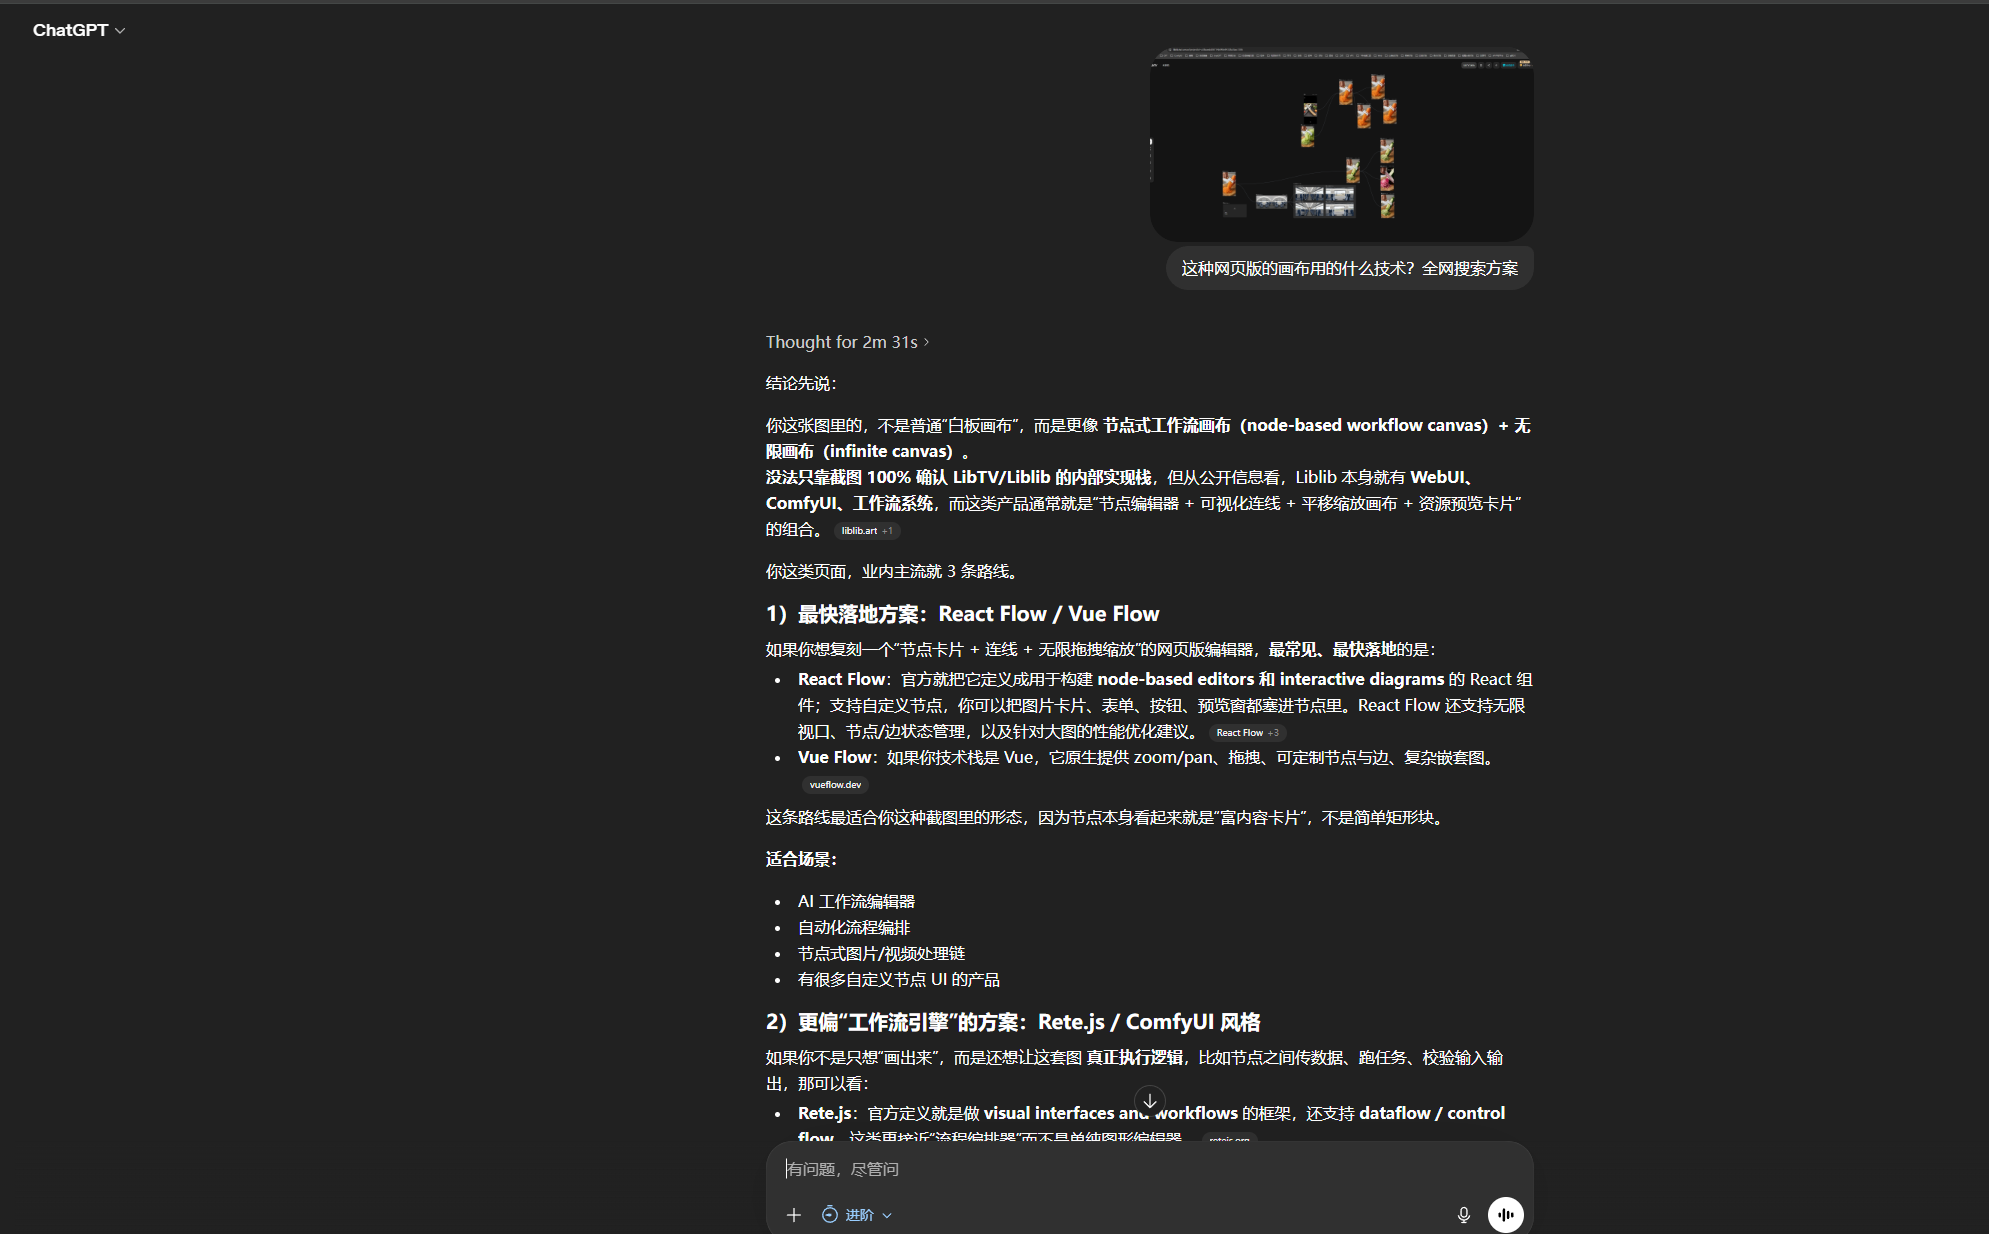
对于这种产品,最快的落地方案其实非常明确:
二、最快落地方案:React Flow / Vue Flow
如果你想复刻一个"节点卡片 + 连线 + 无限拖拽缩放"的网页版编辑器,那么目前最常见、也是最快落地的技术路线就是:
1)React Flow
React Flow 官方本身就把它定义为用于构建 node-based editors 和 interactive diagrams 的 React 组件库。
它非常适合这种场景,因为它支持:
- 自定义节点
- 自定义边
- 画布无限平移与缩放
- 节点/边状态管理
- 大图场景下的性能优化
- 富内容节点渲染
这点很关键。
因为你做的不是一个普通流程图,而是一个"富内容节点编辑器"。节点里可能会有:
- 图片预览
- 角色信息
- 场景参数
- 输入框
- 按钮
- 提示词片段
- 状态标签
也就是说,节点本身不是简单矩形块,而更像一个"可拖拽的功能卡片"。这时候 React Flow 就非常合适。
2)Vue Flow
如果你本身技术栈是 Vue,那么 Vue Flow 也是很直接的一条路线。
它同样原生支持:
- zoom / pan
- 拖拽交互
- 自定义节点与边
- 嵌套图结构
- 复杂画布交互
所以这条路线最适合的场景包括:
- AI 工作流编辑器
- 自动化流程编排
- 节点式图片/视频处理链
- 漫剧分镜编辑器
- 多素材组合式创作工具
三、对标产品:TapNow 和 LiblibTV
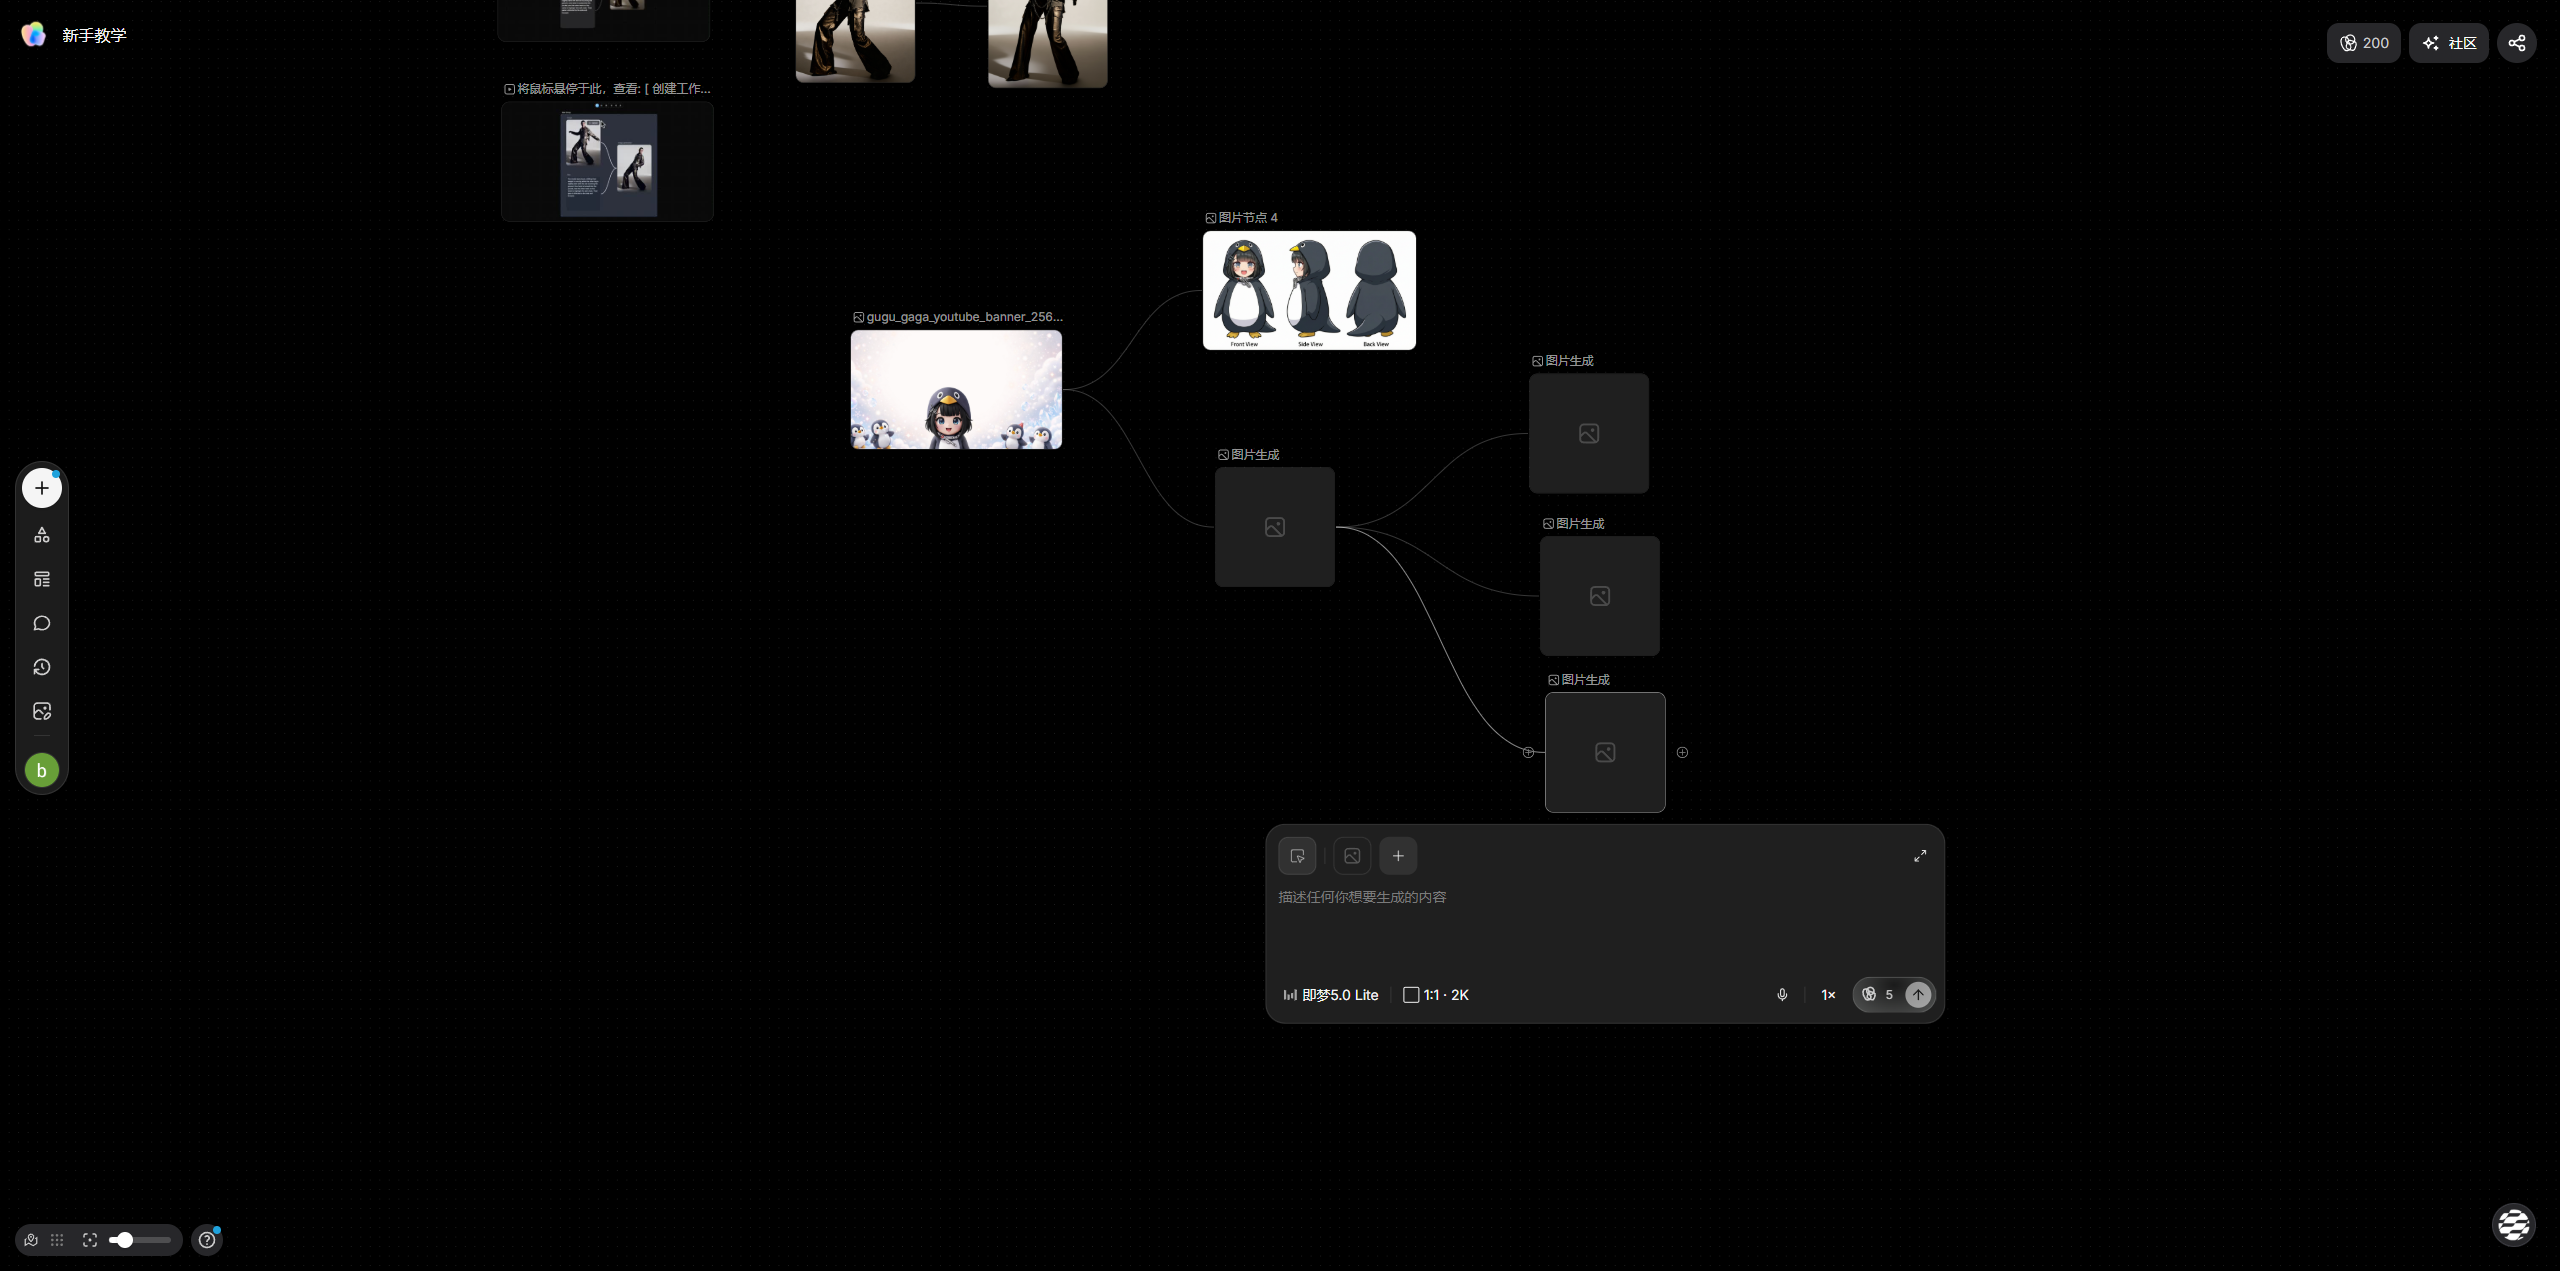
这次主要对标了两个产品。
1)TapNow
2)LiblibTV
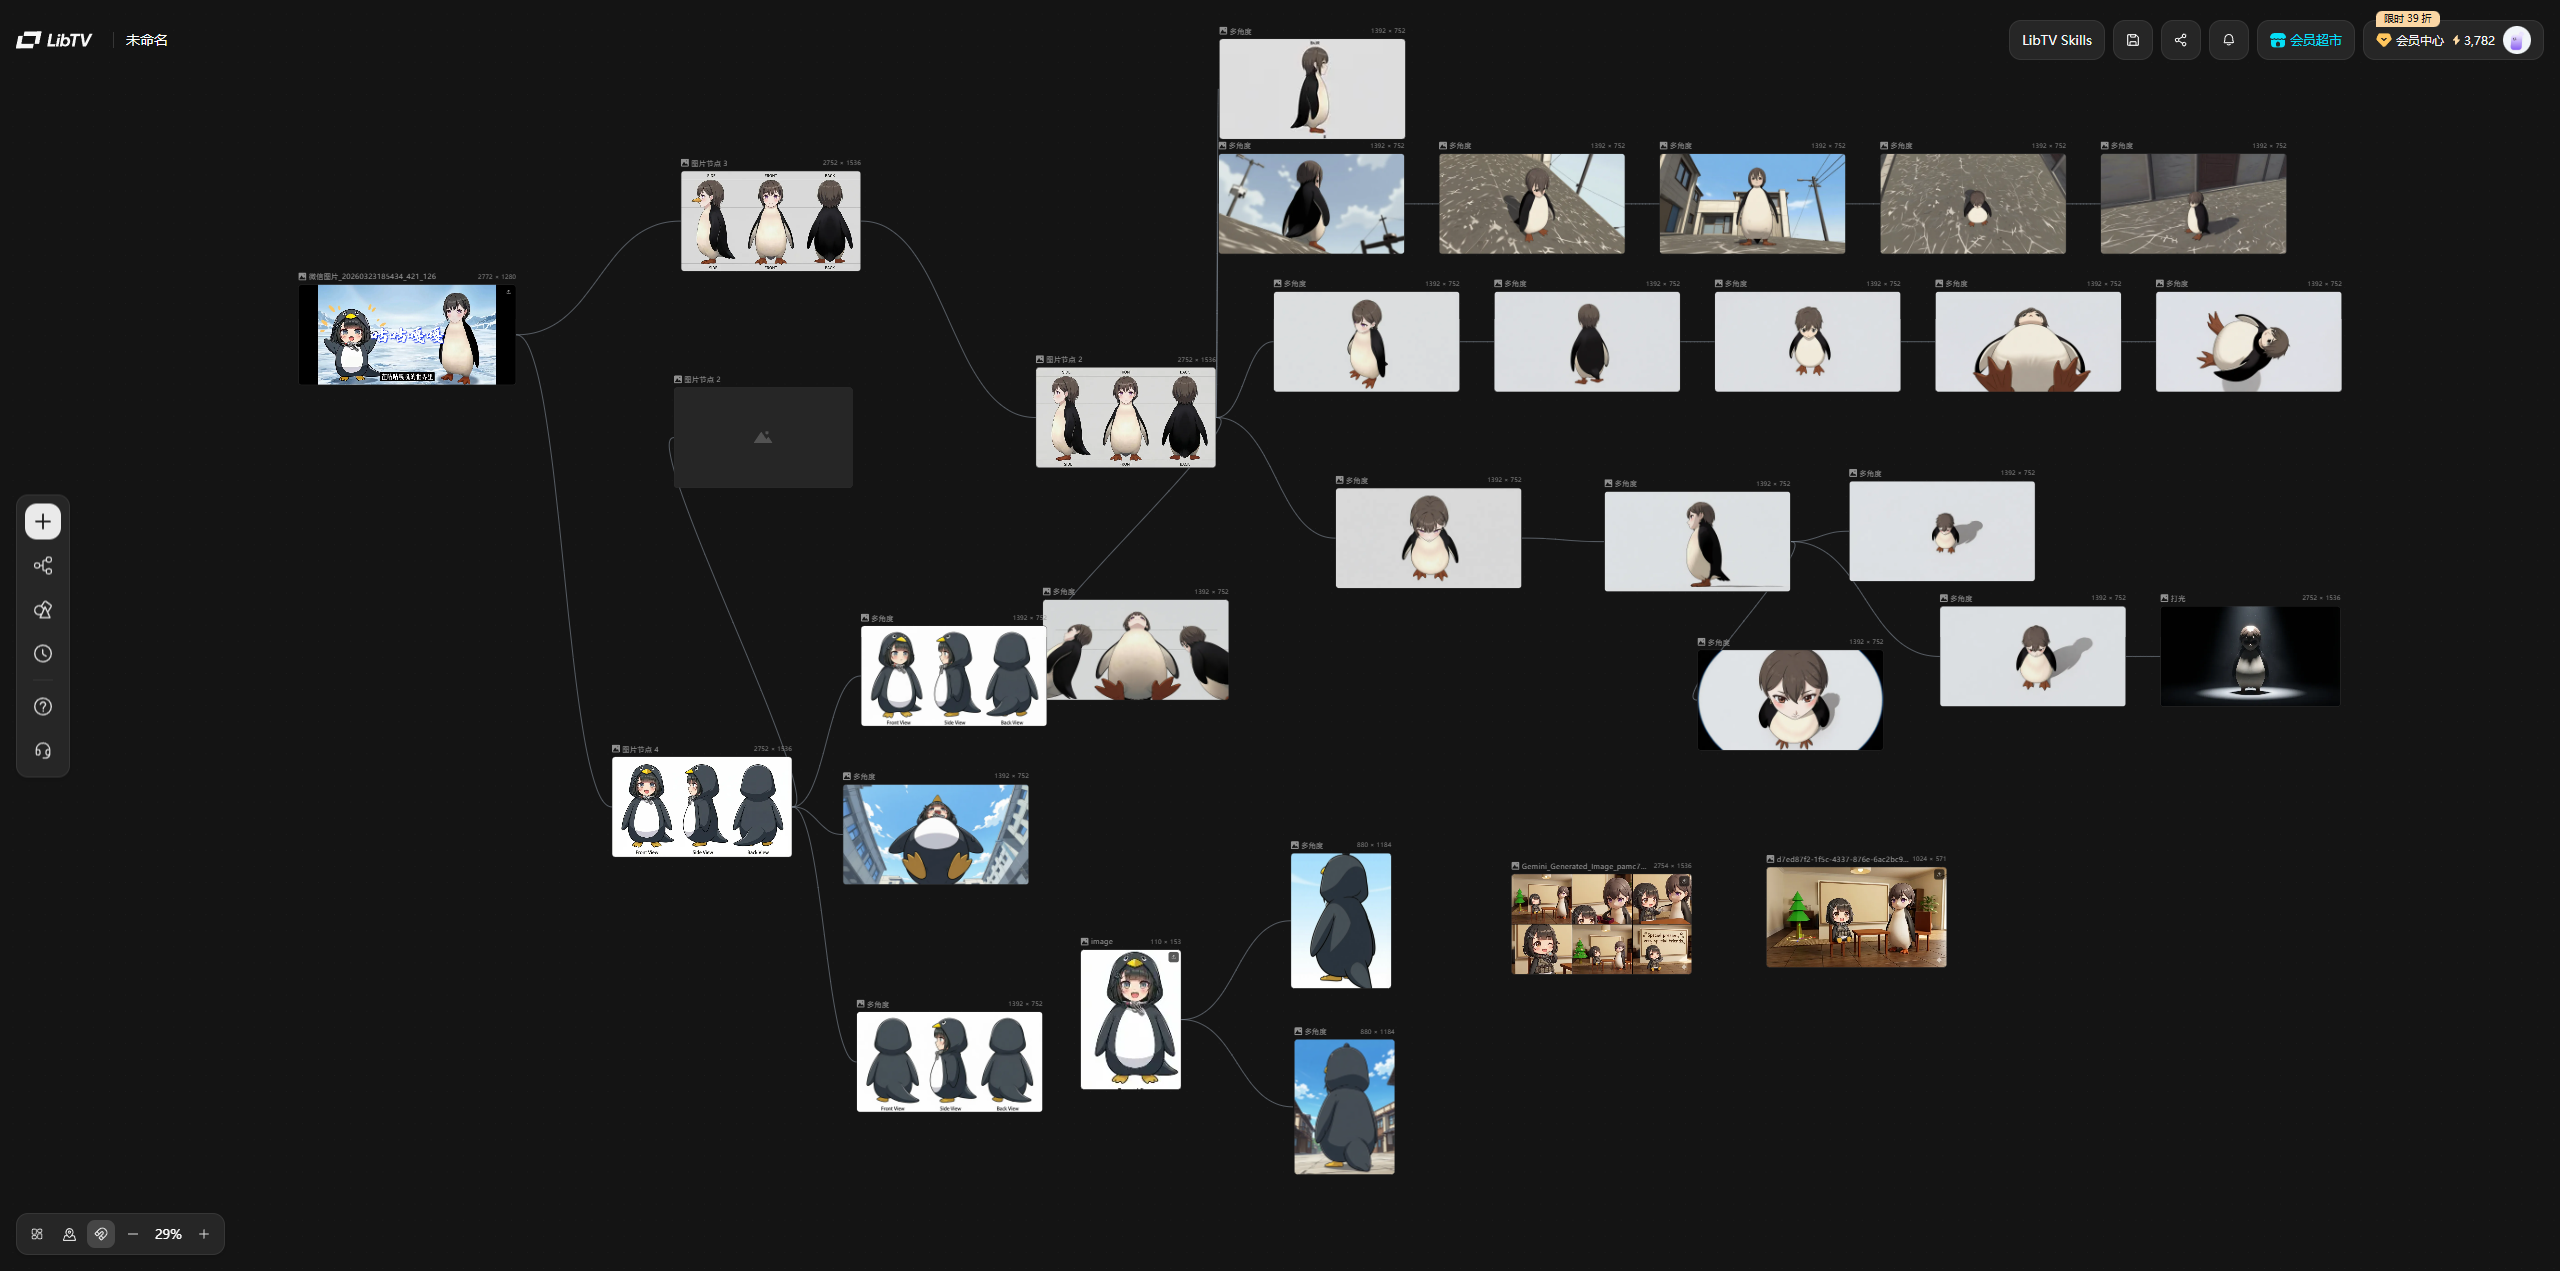
这类产品的共同点其实很明显:
- 都是无限画布形态
- 都支持节点式组织
- 都强调素材与场景的关系管理
- 都在降低分镜制作与图像生成的门槛
- 都属于"可视化编排"而不是纯文本输入
所以如果你要自己做一个 AI 漫剧工具,拿它们做对标是很合理的。
四、实操开始:直接让 AI 生成 React Flow 版本
我这里直接在 COZE 里开干。
模型选自动就行,选好要开始制作的技术栈。
顺带说一句:别选 GLM5.1,真的太废积分了。 虽然效果可以,但真架不住这样造。
我最开始给 AI 的提示词如下:
使用react-flow制作和https://www.liblib.tv/project,libtv一样的项目(对标网站截图)这样的无限画布节点
然后它就给我出了一个初版。

说实话,到这一步我已经挺满意了。
因为这说明一件事:
AI 已经可以很快帮你把"无限画布 + 节点编辑器"的基本骨架搭出来。
当然,初版一定是有问题的,接下来就是修。
五、第一轮修复:连线逻辑不对
初版出来后最明显的问题就是:线不对。
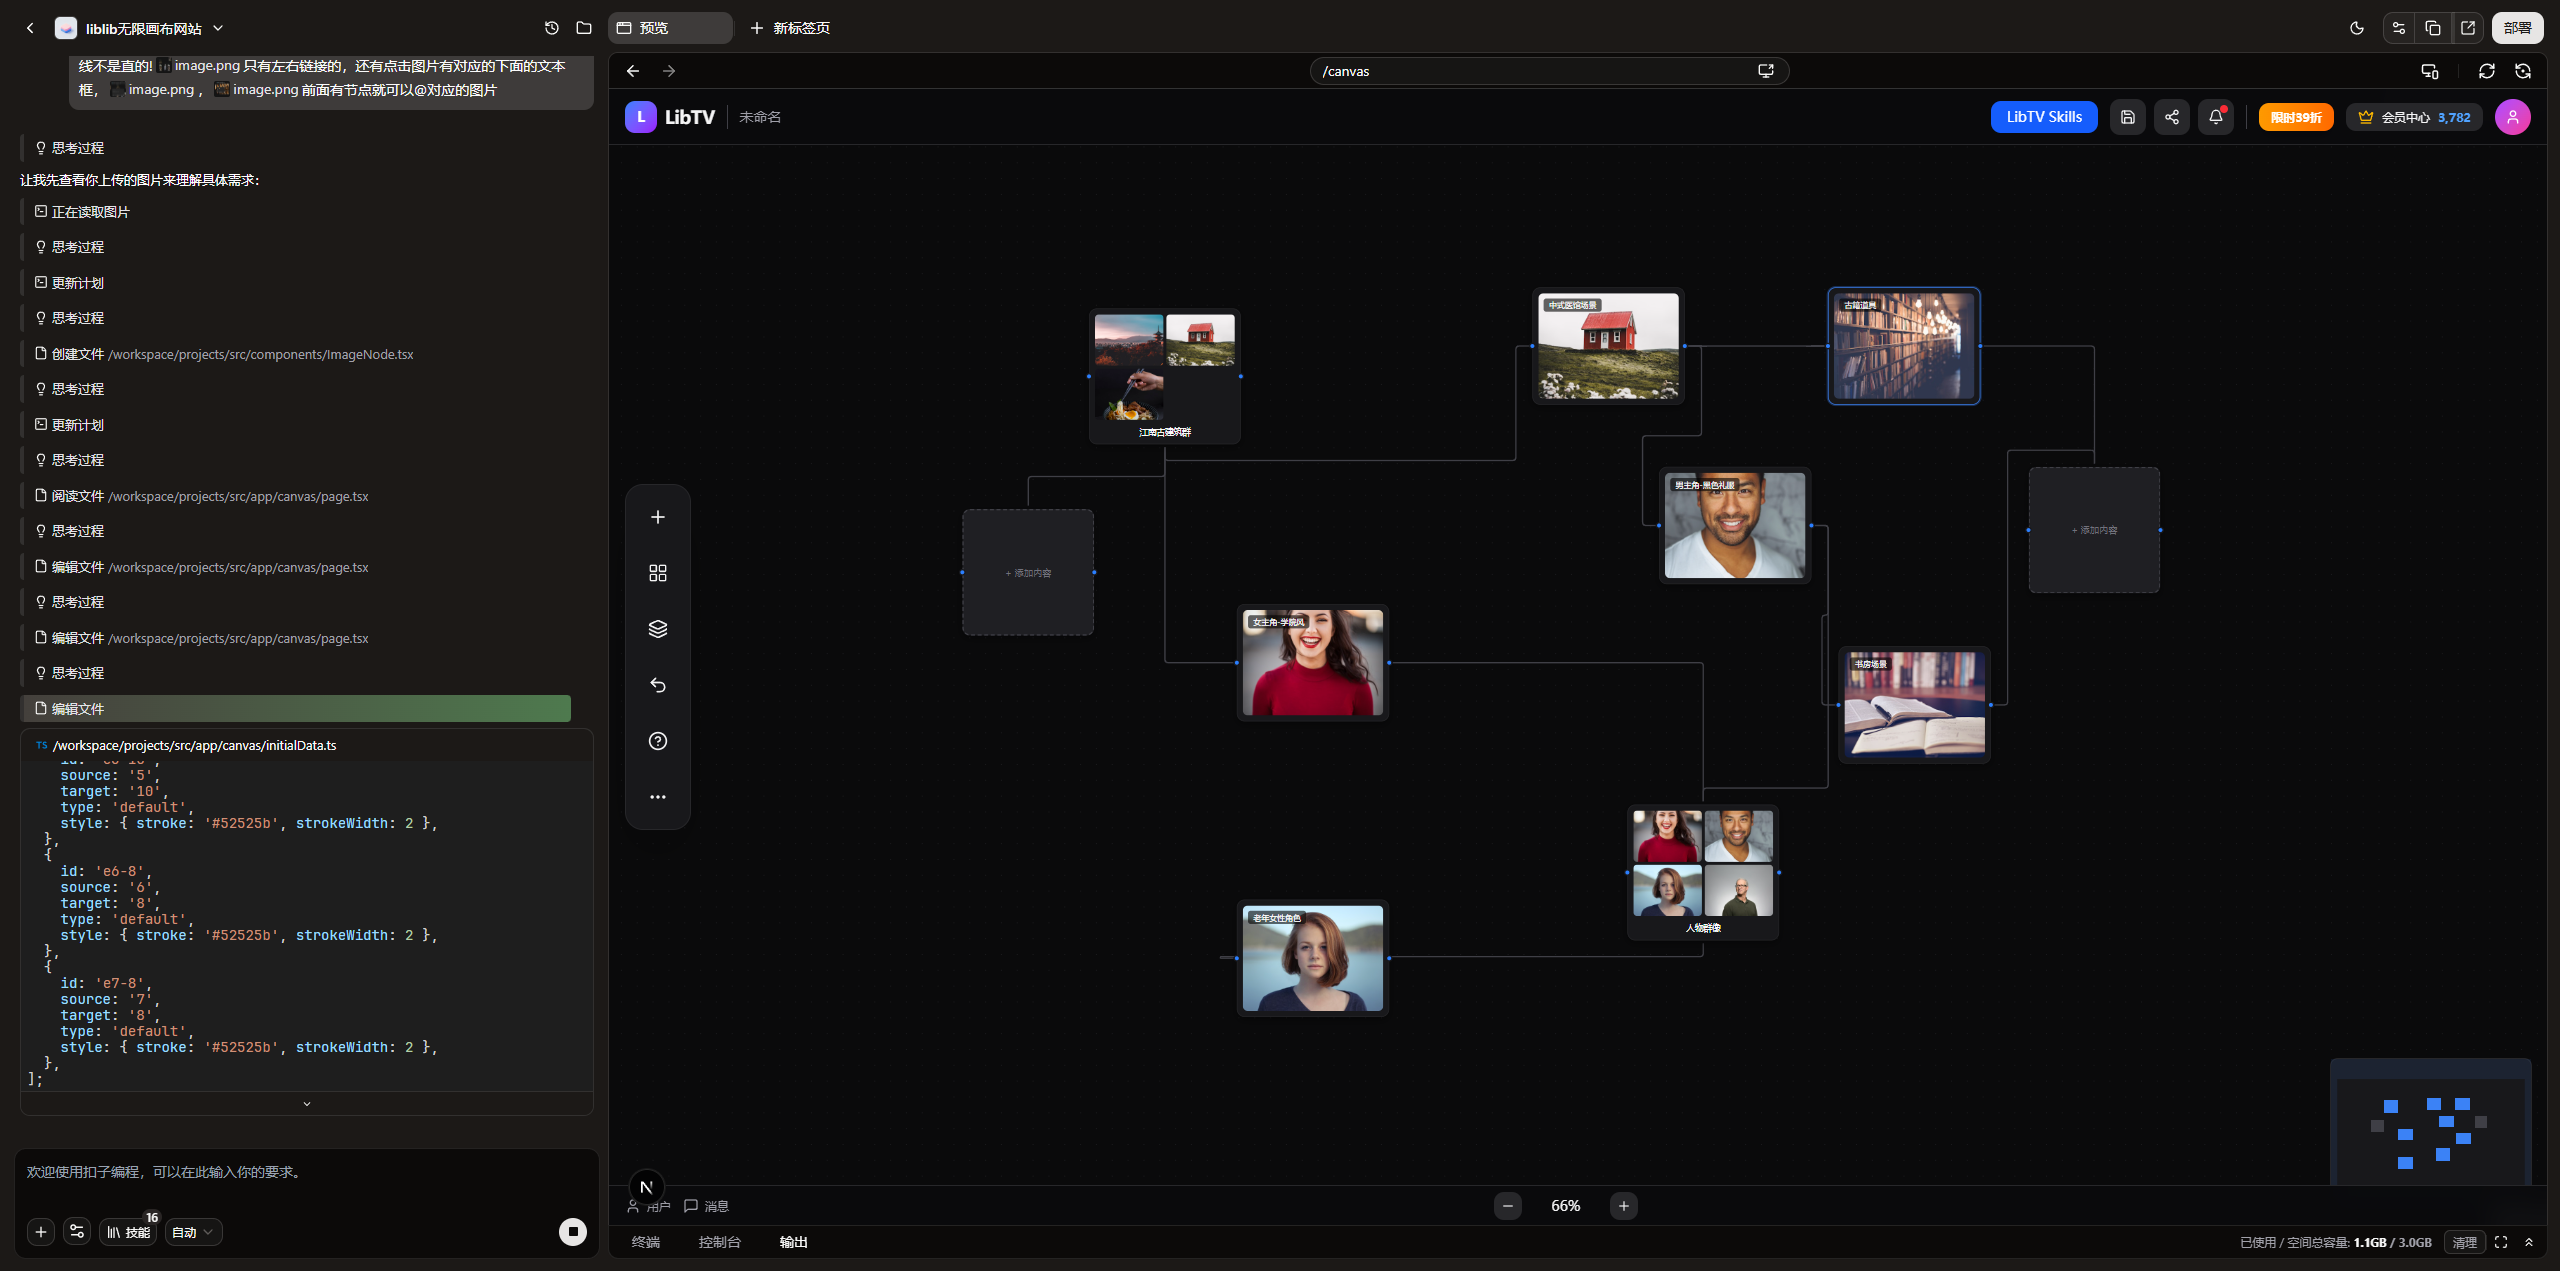
这里最重要的事情不是抱怨 AI 写得不准,而是把问题描述清楚。
我当时给它的提示词如下:
线不是直的! image.png 只有左右链接的,还有点击图片有对应的下面的文本框, image.png , image.png 前面有节点就可以@对应的图片
图片节点的线不对,应该是拖拽右边的然后是右边的连线不是上面的,左边的同理
我拖拽对应的右侧的点连不上对应的左侧的点,修复
这个过程其实特别有代表性。
因为 AI 编程最核心的能力,不只是"让它写代码",而是:
你有没有办法把 Bug 描述成可执行的指令。
比如这里你就得明确告诉它:
- 连线 handle 在哪里
- 左边是输入还是输出
- 右边是输入还是输出
- 节点被点击后要发生什么
- 当前的交互为什么不符合预期
修复之后,效果开始正常起来:

继续收敛之后,变成下面这样:

到这一步,基础的节点连线交互就已经差不多跑通了。
六、第二轮修复:右键菜单要做得像 LiblibTV
连线问题解决之后,很快又发现另一个问题:
右击效果不对。
所以这一步就很简单:继续截图、继续对标、继续让 AI 按图还原。
我的提示词如下:
右击鼠标做成和libtv一样的,如截图
参考截图如下:
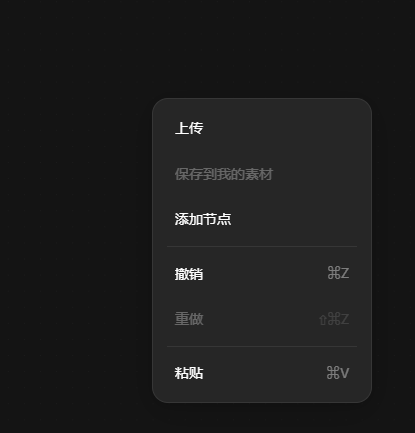
而当时尚未实现时,实际效果是这样的:

继续改完之后,右击菜单的感觉就出来了:
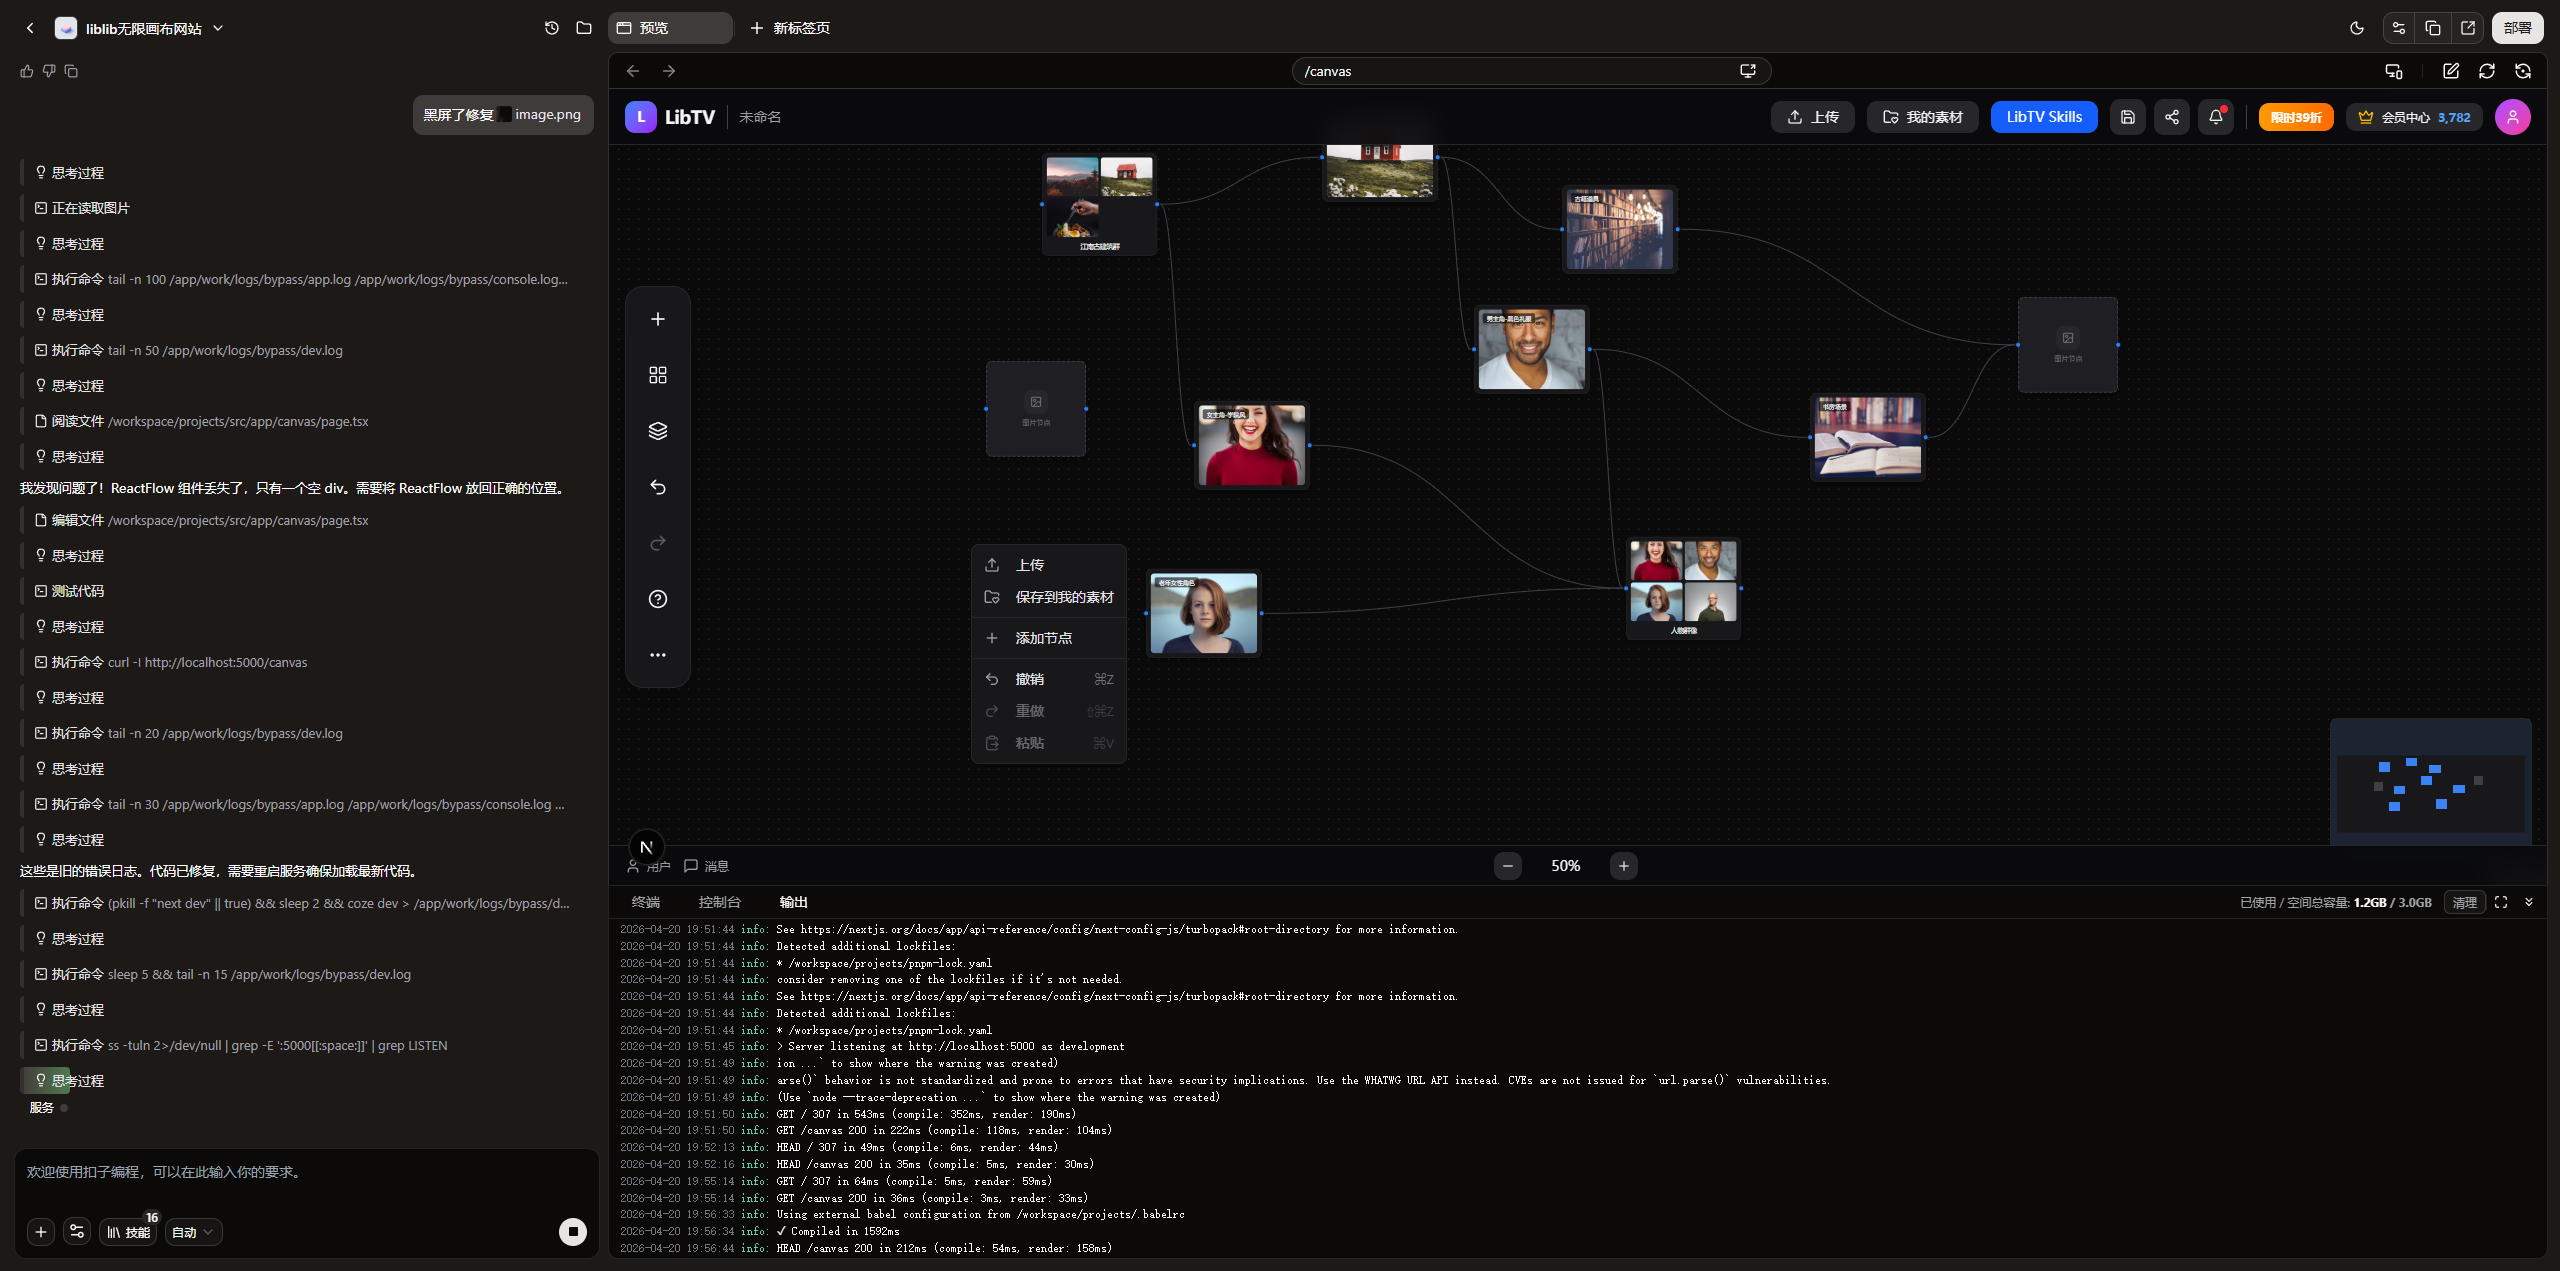
这里我最大的感受就是:
做这类产品,截图比解释更有效。
因为很多交互你用文字描述半天,不如直接把目标图扔给 AI,再加一段明确指令,成功率高得多。
七、进一步优化:把节点内表单重构成底部 Prompt Composer
一开始,编辑表单是直接渲染在节点里的。
但这种做法很快就会暴露问题:
- 节点太重
- 画布信息太密
- 缩放和平移时编辑体验很差
- 节点同时承担展示和编辑职责,越来越乱
所以我决定把编辑表单从节点里拆出来,改成 底部固定悬浮 Prompt Composer。
这一步其实挺关键,因为它会直接影响整套产品是否"像个正式工具"。
我给 AI 的重构提示词如下:
bash
将当前基于 React Flow custom node 的编辑表单,重构为底部固定悬浮 Prompt Composer。
要求:
1. 编辑表单不再作为节点渲染。
2. 表单固定在画布底部中央,不随画布平移和缩放。
3. 使用 React Flow Panel 或外层 absolute overlay 实现。
4. React Flow 中仅保留素材节点、角色节点、聚合节点等真正的图节点。
5. 点击节点时,底部 Prompt Composer 展示该节点的编辑数据。
6. 在 Prompt Composer 中修改内容时,实时同步回对应节点的 data。
7. UI 风格参考:
   - 深色半透明背景
   - 大圆角
   - 毛玻璃
   - 顶部三个快捷按钮:风格、标记、聚焦
   - 中间大 textarea
   - 底部参数工具栏 + 提交按钮
8. 请拆分为:
   - FlowCanvas
   - BottomPromptComposer
   - nodes/*
   - useSelectedNodeEditor
9. 输出完整可运行代码,不要伪代码。
这一步做完之后,整体体验直接上了一个台阶。
八、最终效果展示
最终效果如下:

底部文本编辑区域如下:

这时候它就已经不只是一个"React Flow 壳子"了,而是越来越像一个真正能继续打磨下去的产品原型。
至少这些核心东西已经有了:
- 基础节点系统
- 合理的左右连线
- 右键菜单交互
- 底部独立编辑器
- 更贴近创作流程的 UI 结构
换句话说:
它已经从"能跑"进入到"值得继续做"的阶段了。
九、这还只是个雏形,但方向确实对了
当然,这最终效果肯定还不是我的极限🤣。
真正限制我的,不是想法,也不是技术路线,而是:
免费的 token 被我造完了。
3000 积分,老实说,只够把雏形磨出来。
越往后你越会发现,无限画布这种东西根本不是什么"速成项目",它本质上就是一个完整的大项目。后面还会继续牵扯很多事情,比如:
- 节点系统抽象
- 数据结构设计
- 项目存档与回溯
- 素材管理
- API 调度
- 图像生成任务流
- 状态同步
- 大画布性能优化
- 多人协作
- 权限与资源隔离
所以这种产品,真的只能慢慢打磨。
但话又说回来,现在这个时代已经很夸张了。
以前你根本不敢想,一个人能靠 AI 在这么短时间里把大厂产品的雏形逼出来。
我现在越来越认同一句话:
AI 时代,烧 token 本质上就是在买经验。
你烧得越多,试错越多,反馈越多,成长越快。
不要怕失败。
很多时候失败本身就是学习路径的一部分。
当然,如果真给我无限 Claude Code 4.6 Opus,那整个前后端我是真敢一起通吃。可惜问题还是那个老问题:钱包不给力。
也希望国内各大厂以后真能多给个人开发者一些福利。很多产品不是做不出来,而是差那几轮上下文、几次重试和一点点 token 预算。
最后,送给所有正在折腾 AI 产品的朋友一句话:
别怕烧 token,别怕试错,别怕推翻重来。
方向对了,成功很多时候只是时间问题。
加油💪

COZE项目地址(整个流程和最终成品都在这里面,可以复制直接开发):
https://code.coze.cn/p/7630780309520547875/preview

十、总结
如果你问我:
AI 漫剧工具值不值得做?
我的答案是:非常值得。
因为它正好卡在一个很有潜力的交叉点上:
- AI 图像生成
- 漫画 / 漫剧内容生产
- 无限画布交互
- 可视化工作流编排
- 图生图可控创作
- 多角色多场景组织能力
这些能力一旦组合起来,它就不再只是一个"画图工具",而会逐渐变成一个完整的 AI 内容生产工作台。
如果你也想从 0 到 1 做一个类似 TapNow、LiblibTV 这样的产品,我的建议很直接:
- 先找对标产品
- 截图拆解页面和交互
- 用 GPT 做需求分析
- 先用 React Flow / Vue Flow 做前端雏形
- 再慢慢补齐节点系统、右键菜单、底部编辑器、API 协同
- 最后把生成链路接通,形成完整闭环
先做出来,再持续打磨。
因为很多时候,不是你先把所有问题都想明白了才开始,而是你开始做之后,方向才会越来越清晰。
关键词
AI漫剧、React Flow、Vue Flow、无限画布、节点编辑器、TapNow、LiblibTV、Prompt Composer、图生图、分镜生成、可视化编排、AI工作流