系列文章目录
第一章 规则和传统NLP之NLP概述
第二章 规则和传统NLP之NLP任务范式
第三章 规则和传统NLP之困难和挑战
第四章 NLP常见语料库
第五章NLP(正向,逆向,双向匹配法分词及代码实现)
jieba分词
- 系列文章目录
- [一、 jieba分词](#一、 jieba分词)
- [1. 全模式](#1. 全模式)
- [2. 精确模式](#2. 精确模式)
- [3. 搜索引擎模式](#3. 搜索引擎模式)
- 代码实现和结果
- 结果
一、 jieba分词
jieba做中文分词有三种模式:
1. 全模式
- 切分方式:将句子中的所有可能词语都切分出来,包括一些较小的词和组合词。这意味着同一个句子可能会被切分成多个词语。
- 适用场景:适合用于关键词提取或快速获取文本中的所有潜在词汇。这个模式适合初步分析文本,了解文本的主题。
2. 精确模式
- 切分方式:将句子精确地切分成词语,尽量准确地还原出语义。这个模式会根据词典和语言规则,选择最可能的分词结果。
- 适用场景:适合用于文本分析和语义理解,常用于处理需要分析句子意思的任务,如文本分类和情感分析。
3. 搜索引擎模式
- 切分方式:在精确模式的基础上,对词语进行更细粒度的切分,特别是长词和短词的组合,使得搜索时能更好地匹配用户输入。
- 适用场景:适合用于搜索引擎的词语匹配,尤其是在构建搜索引擎时,可以提高用户输入查询时的匹配准确性。
总的来说,选择哪种模式取决于具体的应用需求:如果需要准确理解文本,使用精确模式;如果需要获取所有可能词汇,使用全模式;如果需要优化搜索结果,使用搜索引擎模式。
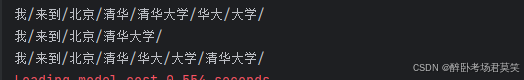
代码实现和结果
python
import jieba

text = '我来到北京清华大学'

# 全模式

seglist = jieba.cut(text,cut_all=True)
for word in seglist:
    print(word,end='/')
print()
#精确模式
seglist = jieba.cut(text,cut_all=False)
for word in seglist:
    print(word,end='/')
print()
# 检索模式
seglist = jieba.cut_for_search(text)
for word in seglist:
    print(word,end='/')
print()
结果