一.LLM
1.全称Large Language Model(大语言模型,简称"大模型")
LLM:Large Language Model(大语言模型,简称"大模型")。
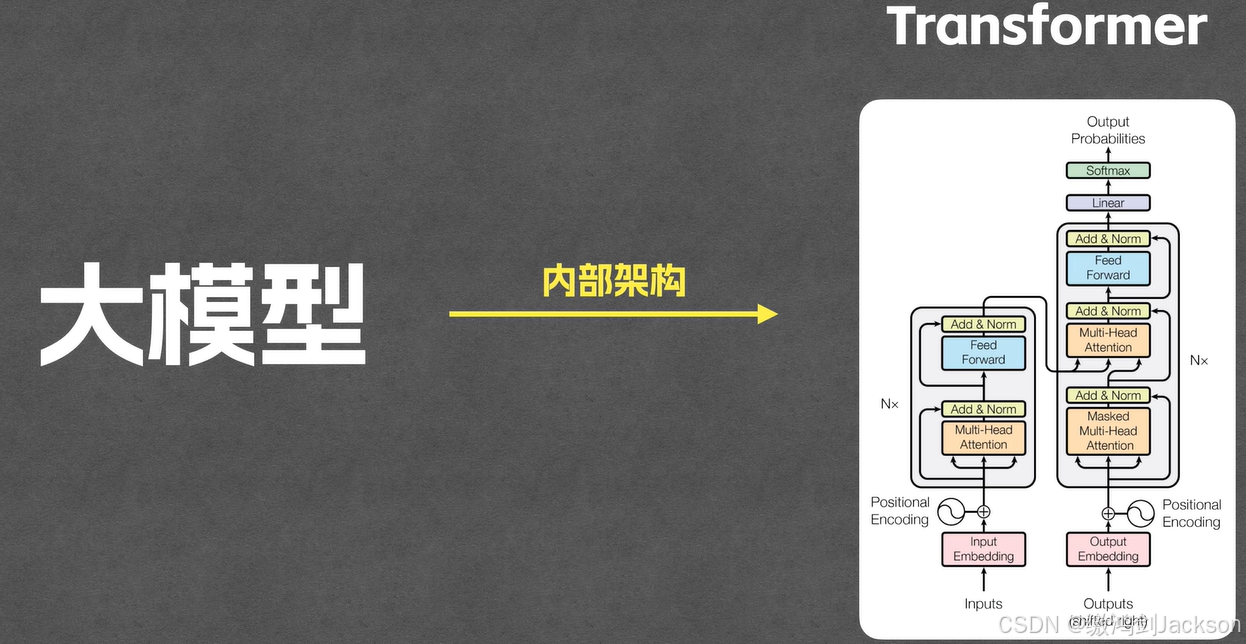
基本上,现在所有的大模型都是基于Transformer这套架构训练出来的。说白了,大模型的底层引擎就是"Transformer"
"Transformer"是由Google发明(点火者),但是真正推广者是OpenAI。
2.我们平时见到的大模型有哪些?
- ChatGPT (OpenAI)
- 通义千问 (阿里)
- 文心一言 (百度)
- 豆包 (字节跳动)
- Kimi (月之暗面)
- DeepSeek (深度求索)
- 等等
3.大模型是怎么工作的?
- 本质就是一个文字接龙游戏
举例
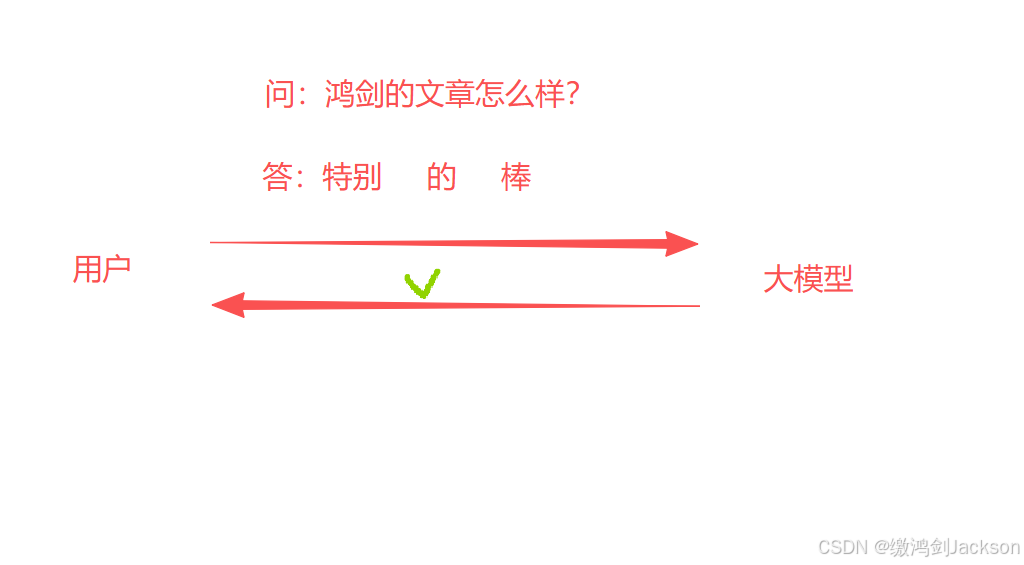
- 当用户问"鸿剑的文章怎么样"?然后大模型对此做出思考。
- 一会,思考的结果是"特别",发送给用户。然后再把"特别"这个词抓回去,再回答"的"拼接到"特别"后面,发送给用户,然后再抓回去,再思考出"棒",拼接到"特别的"后面,答案是"特别的棒",然后再抓回去。发现该问题回答完了,就会输出一个结束标志(图中的绿色对钩)。
- 说白了,本质就是一个词一个词往外蹦的,所以我们用deepseek时,也能明显发现大模型给答案时,就是一个一个词的生成的(也叫流式生成),本质原因就是因为这个大模型的生成特点,就是文字接龙游戏。
二.Token
解析:
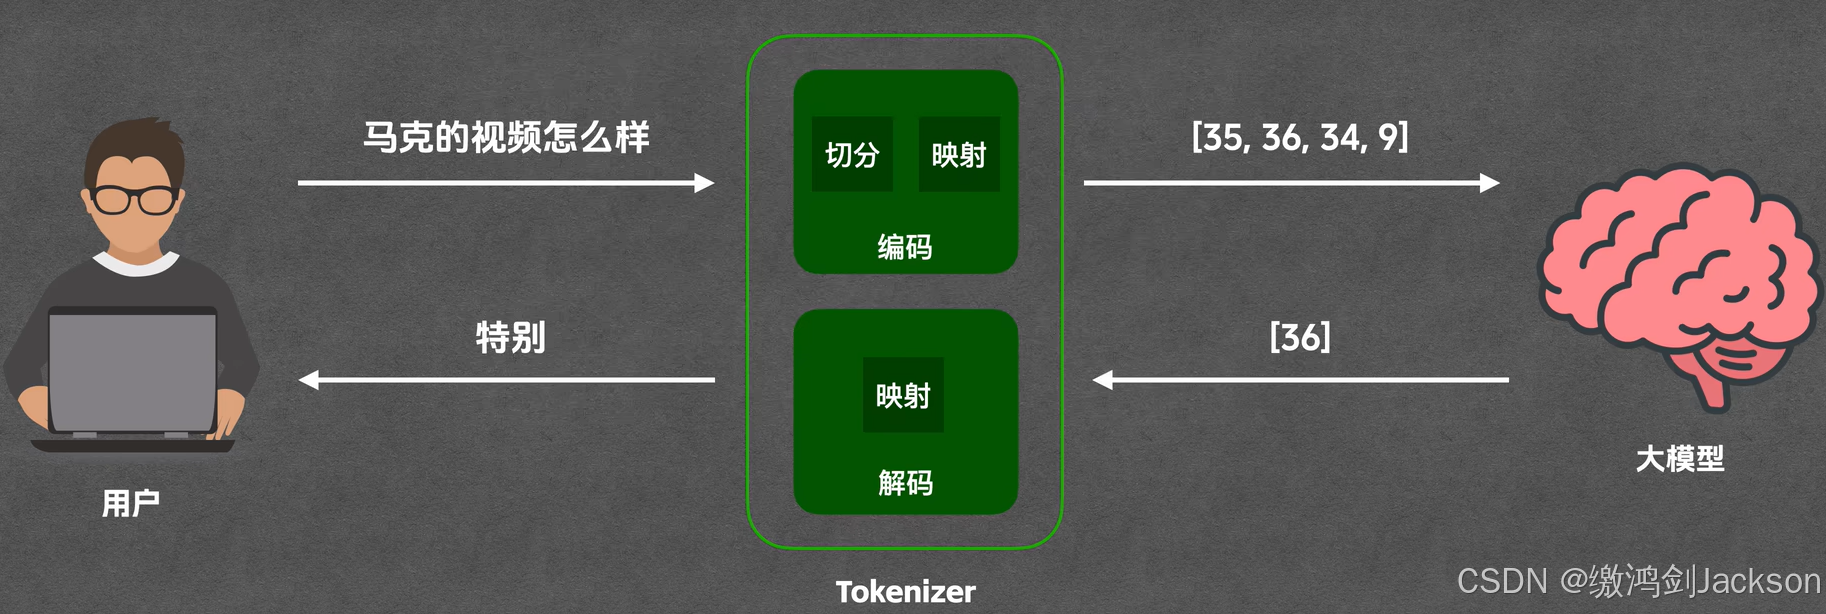
- 大模型本质上是一个庞大的数学函数,里面跑的全是矩阵运算。因此大模型接收的只能是数字,输出的也只能是数字。说白了大模型压根不认识人类写的文字。
- 所以人类要和大模型沟通,需要一个中间人(翻译官),即Tokenizer。它负责编码(将文字转为数字)和解码(将数字转为文字)。
- 所以Token是大模型处理文本的基本单位。
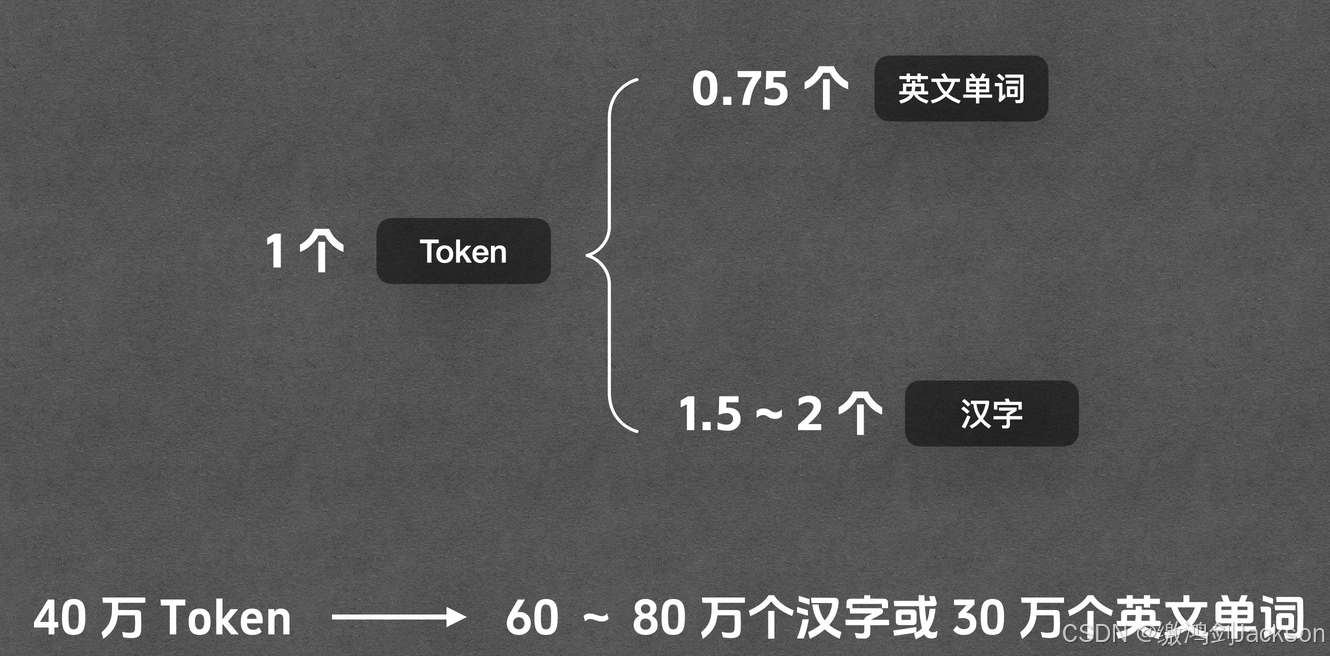
- 而Token不能说对应一个文字、或一个英文单词,而是具体分情况,但是大致比例如下图所示。