Kafka 消息查找流程和消息读取流程

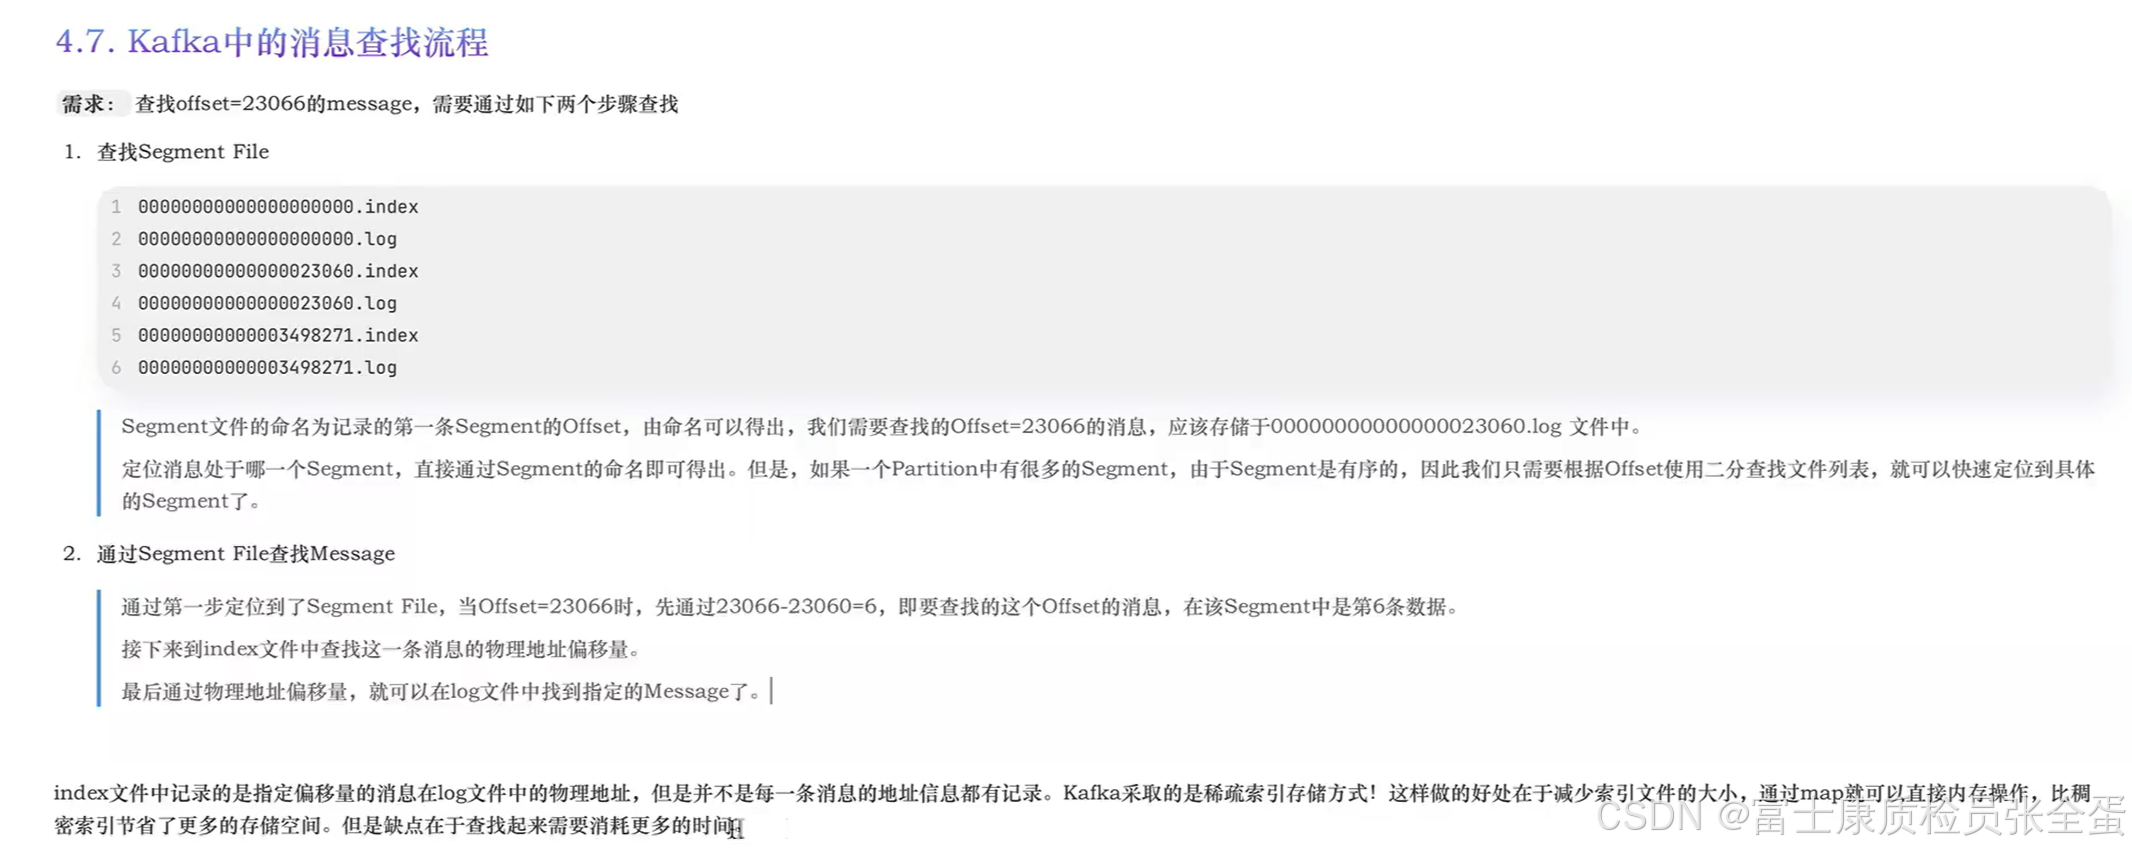
消息在kafka当中最终存放在一个一个的segment当中,而segment由两个部分组成,一个是log文件,一个是index文件。

如果消费者需要查找指定的指定的offset这样的消息,那么是怎么查找消息的?
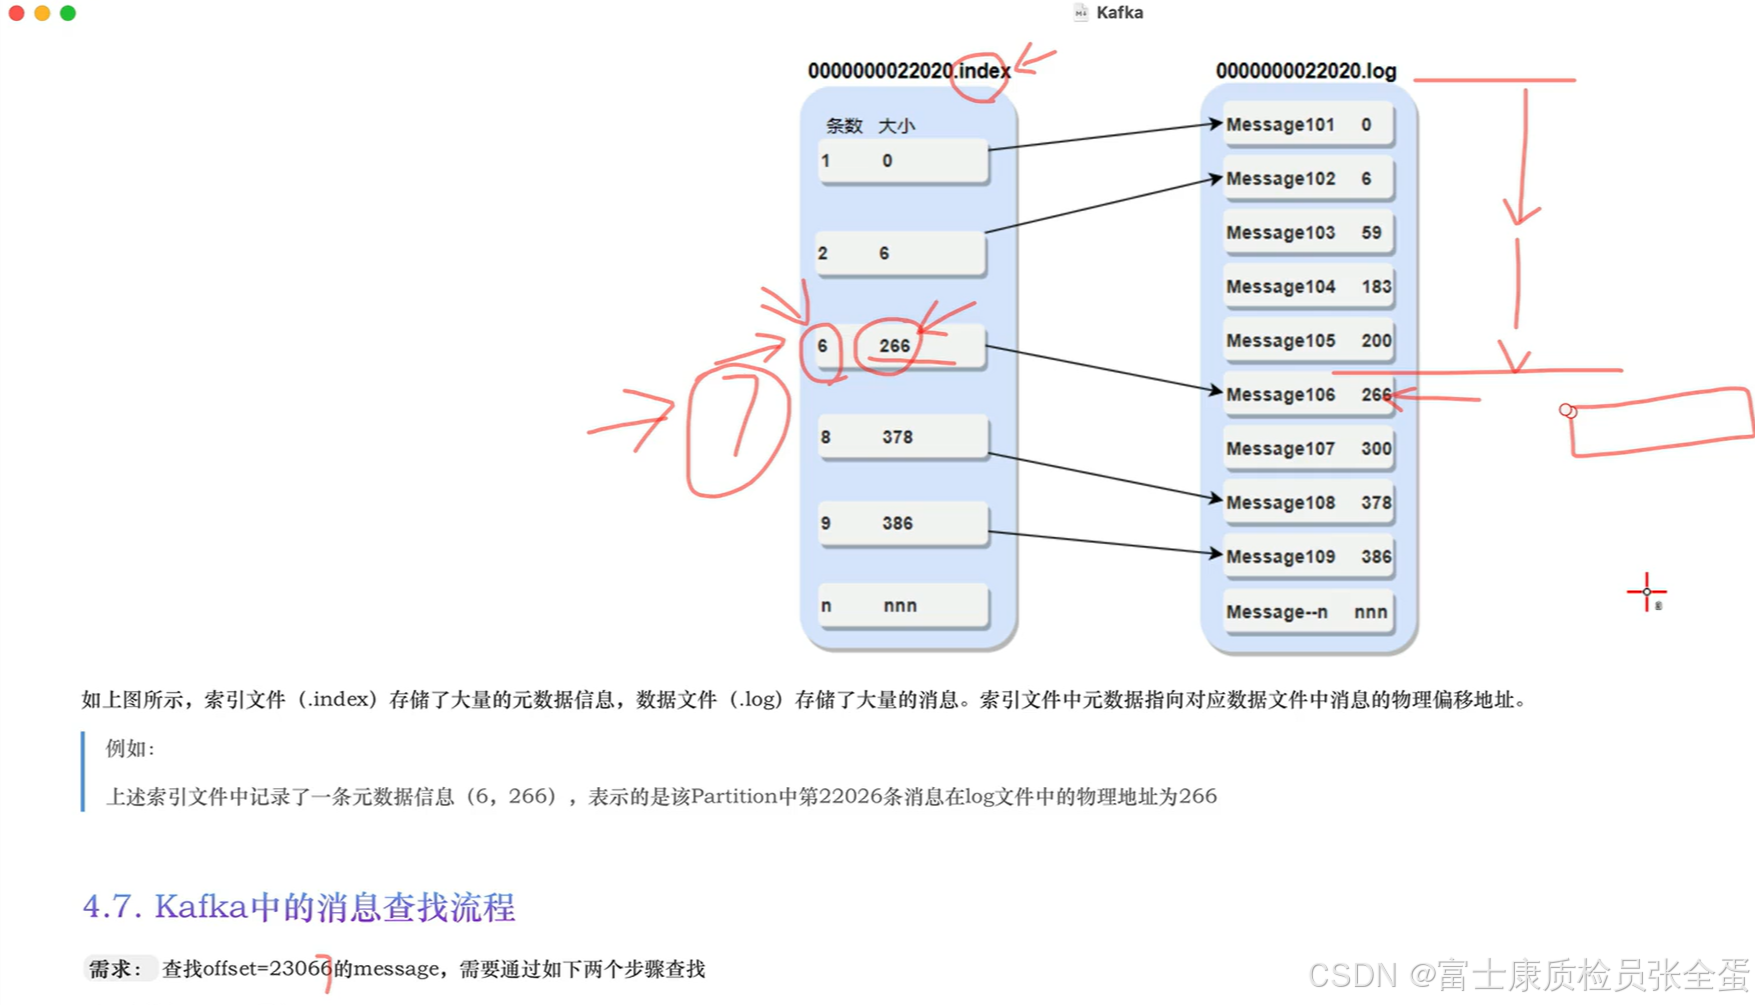
如果查找的消息是23067,那么偏移量出来得到7,很显然7不在index里面,那么找到比它小的,那就是6,那么就可以定位到第六条消息的位置,而每个消息的头部都是记录着大小,可以叠加大小就可以找到之后的信息。
如果在segment中快速定位到消息?先通过segment的名字定位segment file,在哪个文件当中。之后再去index文件当中找物理偏移量,物理地址,找到之后再往下顺序读取就行了。
相关推荐
RobinXYuan3 小时前
【Kafka 源码手记】04 客户端如何找到 Broker
kafka·源码阅读
爱吃火鸡面呀4 小时前
深入理解 Spark RDD:五大特性与实战解析
大数据·分布式·spark
Linux实战笔记6 小时前
记一次消息队列选型对比线上排查:Kafka/RabbitMQ/Pulsar 技术选型
kafka·rabbitmq·高并发·pulsar·消息队列选型
Norris Huang6 小时前
Kafka Connect 与 Flink CDC 写入 Iceberg:Upsert 的代价,以及 S3 Tables 的真正价值
分布式·flink·kafka
张彦峰ZYF7 小时前
一条消息的丢与重:Kafka 与 RabbitMQ 可靠投递的确认、位点、死信与幂等全链路
后端·kafka·消息队列·rabbitmq·isr·解耦与削峰·丢失与重复
我就是不信7 小时前
集群高并发环境下如何保证分布式唯一全局ID生成?
分布式
黄俊懿1 天前
【架构师从入门到进阶】第六章:服务集群优化——第八节:线程数公式
java·服务器·数据库·分布式·性能优化·架构·系统架构
大菠萝爱上小西瓜1 天前
基于 Spark + Iceberg 湖仓一体的 Netflix 流媒体用户行为全链路数仓与 ALS 智能推荐决策系统(含穿透下钻大屏)
大数据·分布式·spark
吴建旭 智宅焕1 天前
智能家居售后服务体系的架构设计:分布式售后风险的集中式兜底方案
分布式·智能家居
lisanmengmeng2 天前
Ganglia分布式集群监控系统安装手册
分布式