一、Linux
查看系统内核版本
统计当前目录下所有文件个数
后台运行并把日志输出到 run.log
bash
uname -r
ls -l | grep -v ^d | wc -l
nohup python task.py > run.log 2>&1 &
uname -r :查看 Linux 内核版本,适配软件兼容性、集群环境核对
grep -v ^d 排除文件夹,只统计普通文件
nohup + 2>&1 标准错误重定向到日志,线上脚本部署标配写法
uname 命令
全称:Unix name
作用:打印系统信息
-r:显示内核 release 版本号(release)
-a:显示所有信息(内核名、主机名、内核版本、硬件架构等)
-s:内核名称(默认)
-m:硬件架构(如 x86_64)
-n:主机名
-v:内核版本号(verbose)
bash
ls -l | grep -v ^d | wc -l

ls -l          → 列出详细信息
    ↓
grep -v ^d     → 过滤掉以 'd' 开头的行(即目录)
    ↓
wc -l          → 统计剩余行数
bash
nohup python task.py > run.log 2>&1 &

nohup        → 忽略挂断信号
    ↓
python task.py → 执行脚本
    ↓
> run.log    → 标准输出重定向到文件
    ↓
2>&1        → 错误输出也指向标准输出
    ↓
&           → 放入后台执行
二、SQL
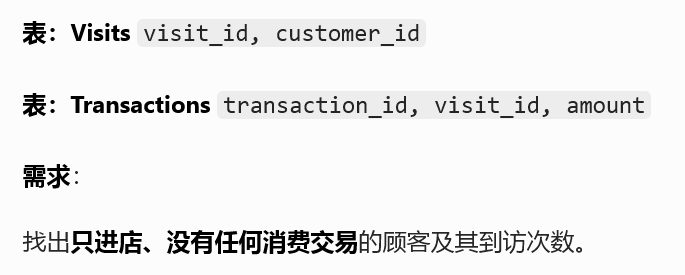
1581. 进店却未进行过交易的顾客
sql
SELECT
    v.customer_id,
    COUNT(v.visit_id) AS count_no_trans
FROM Visits v
LEFT JOIN Transactions t
ON v.visit_id = t.visit_id
WHERE t.transaction_id IS NULL
GROUP BY v.customer_id;
左连接 + 右表为空 → 筛选有行为无转化用户
电商访客未下单、曝光未点击、流量流失人群通用模板
分组统计频次,数仓转化分析高频
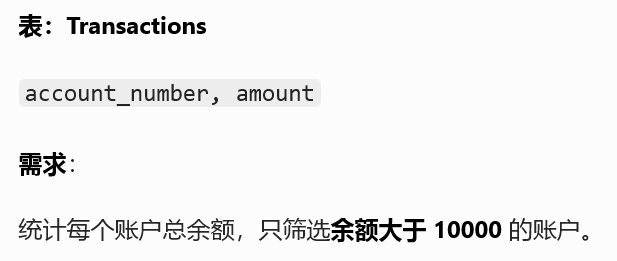
1587. 银行账户概要 II
sql
SELECT
    account_number,
    SUM(amount) AS balance
FROM Transactions
GROUP BY account_number
HAVING SUM(amount) > 10000;
GROUP BY + HAVING 聚合后过滤
账户流水累加、大额用户筛选、金融报表常用
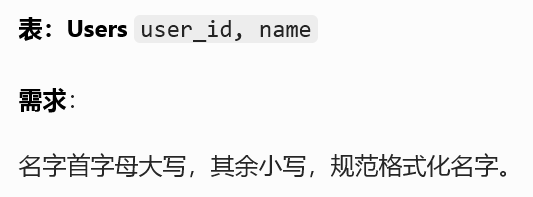
1667. 修复表中的名字
sql
SELECT
    user_id,
    CONCAT(
        UPPER(SUBSTRING(name,1,1)),
        LOWER(SUBSTRING(name,2))
    ) AS name
FROM Users
ORDER BY user_id;
SUBSTRING 截取字符串
UPPER/LOWER 大小写转换
CONCAT 拼接数据清洗、字符串规范化标准写法
三、Pyspark
python
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, count, sum, concat, upper, lower, substring

spark = SparkSession.builder.master("local[*]").appName("Day30").getOrCreate()

# 1. 有到访无交易用户
visits = spark.createDataFrame([(1,101),(2,102)],["visit_id","customer_id"])
trans = spark.createDataFrame([(1,1,200)],["transaction_id","visit_id","amount"])

visits.join(trans, on="visit_id", how="left")\
      .filter(col("transaction_id").isNull())\
      .groupBy("customer_id").count().show()

# 2. 账户余额大于10000
acc = spark.createDataFrame([
    (1001,5000),(1001,6000),(1002,3000)
], ["account_number","amount"])

acc.groupBy("account_number")\
   .agg(sum("amount").alias("balance"))\
   .filter(col("balance") > 10000).show()

spark.stop()
Spark 左外连接空值过滤,和 SQL 逻辑完全对齐
分组聚合后 filter 筛选大额账户
字符串截取、大小写函数可实现名字格式化清洗
四、算法
88. 合并两个有序数组
python
def merge(nums1, m, nums2, n):
    i, j, k = m-1, n-1, m+n-1
    while i >= 0 and j >= 0:
        if nums1[i] > nums2[j]:
            nums1[k] = nums1[i]
            i -= 1
        else:
            nums1[k] = nums2[j]
            j -= 1
        k -= 1
    while j >= 0:
        nums1[k] = nums2[j]
        j -= 1
        k -= 1
逆序双指针,不开新数组
原地合并,空间 O (1)