引言
2024 年 11 月 18 日,OWASP 发布了 2025 版 Top 10 LLM 安全风险清单,标志着AI安全从防漏洞向管生命周期的质变。。
LLM 安全风险是指在大语言模型在设计、训练、部署和交互过程中,可能被攻击者利用,或因系统设计缺陷而导致的安全威胁。
OWASP( Open Web Application Security Project,开放式 Web 应用程序安全项目)是一个社区驱动的非营利性基金会,致力于提升软件和应用程序的安全性。
十大风险
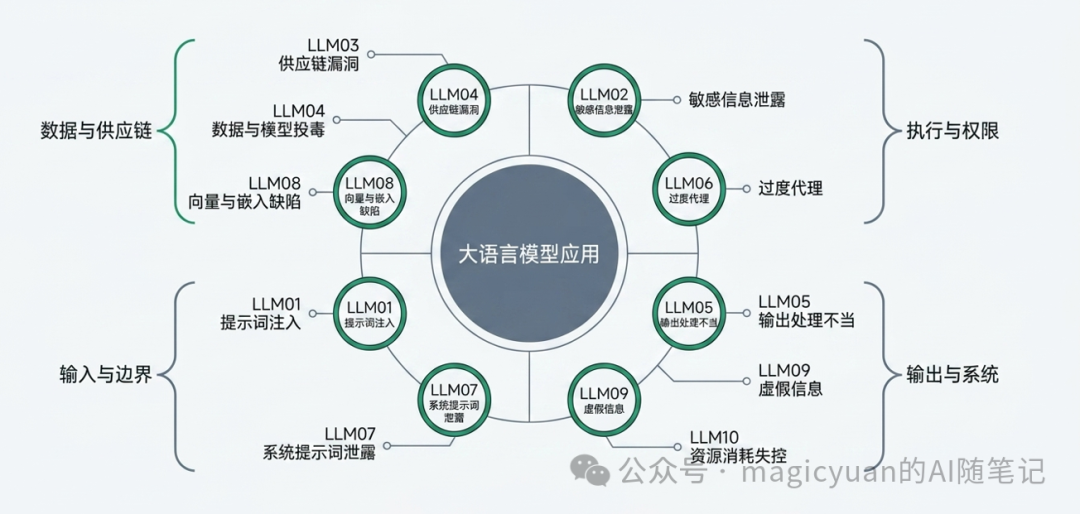
因为 LLM 在解析输入时,无法彻底分离控制指令与外部数据,模型将所有输入视为平等的文本流,导致了提示词注入 (LLM01)和系统提示词泄露 (LLM07)。
预训练模型、数据集、LoRA 适配器和RAG知识库都依赖于外部供应体系,因此引入了供应链漏洞 (LLM03)、数据与模型投毒 (LLM04) 和向量与嵌入缺陷 (LLM08)。
LLM 并不是程序,而是一个容易受环境干扰的概率模型,其输出具有不确定性。如果缺乏严密的物理与逻辑校验,会造成敏感信息泄露(LLM02)、虚假信息 (LLM09) 和资源消耗失控 (LLM09)。
如果开发者赋予 LLM 过高的权限,当 LLM 能够直接调用系统函数或外部 API,且其生成的输出未经验证就进入下游系统时,会引起输出处理不当 (LLM05)和过度代理 (LLM06)。
2025版的进化
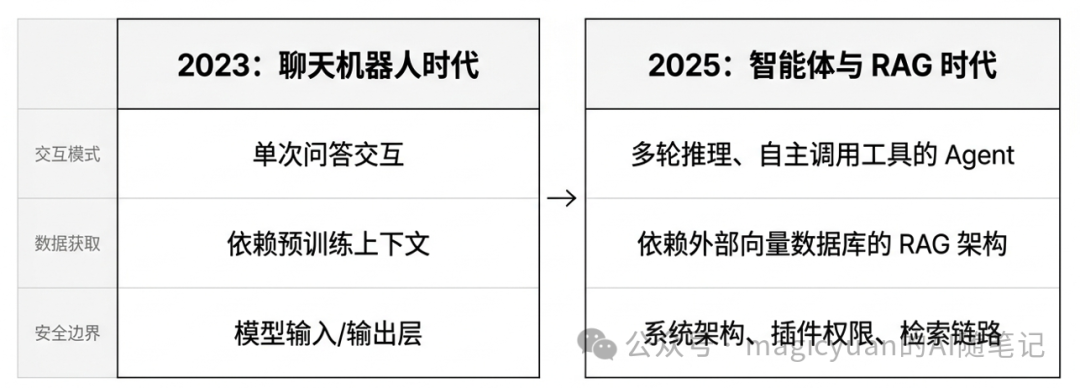
对比2023、2025两份清单,安全重点从单纯的内容过滤,转向了对权限、资源、知识检索和执行动作的严苛约束。
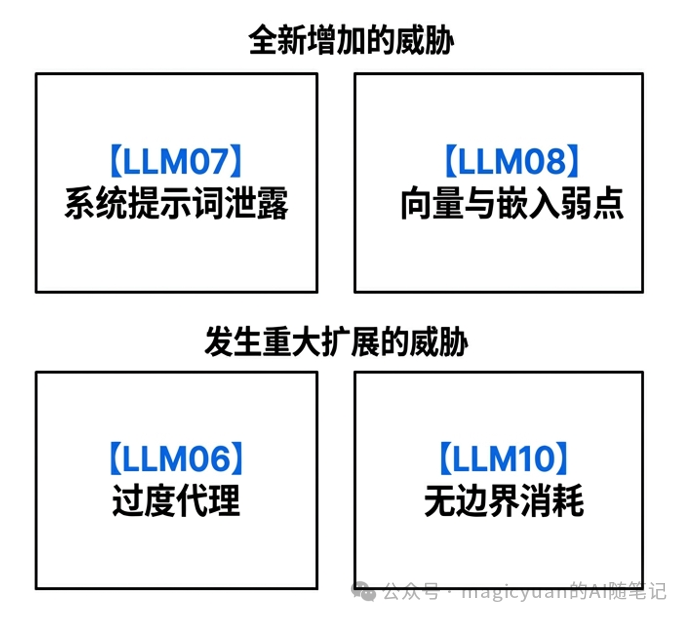
过去,开发者理所当然地认为系统提示词处于绝对隔离的黑盒中。然而,现实的越狱攻击证明,任何交由 LLM 处理的系统提示词,都有可能被逆向工程或通过巧妙的对话被完整套出。
现在 RAG 已成为企业 AI 应用的标配,向量数据库的污染直接导致模型输出错误。
随着 Agentic 架构的普及,LLM 不再只是对话,而是开始工作。未受约束的插件权限,成为了最致命的越权载体。
企业级 LLM 部署的计费模式,使得攻击者可以通过少量的高复杂度的请求,轻易耗尽受害者的资金池或 GPU 配额。
防御
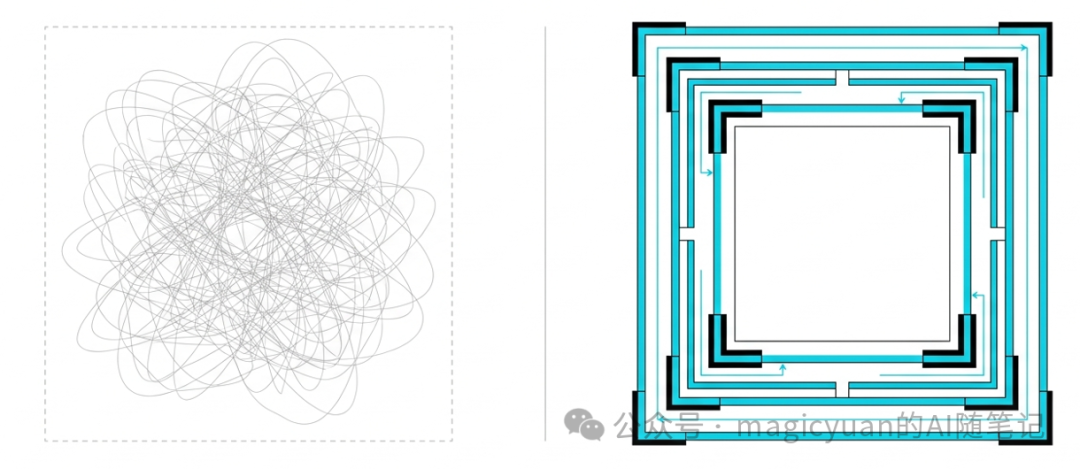
OWASP 核心防御理念是零信任,不假设模型本身是安全的。
不相信模型的自我约束能力,不相信模型的输出是安全的,也不相信模型能完美执行系统指令。
防御的目标是实现安全控制与模型能力的解耦。
因此,安全逻辑必须建立在模型之外,由确定的代码和规则来执行
无论模型变得多么强大或聪明,安全防线都不应依赖于模型的听话程度。
而是依靠一套可审计、可预测的自动化的多层防御体系。
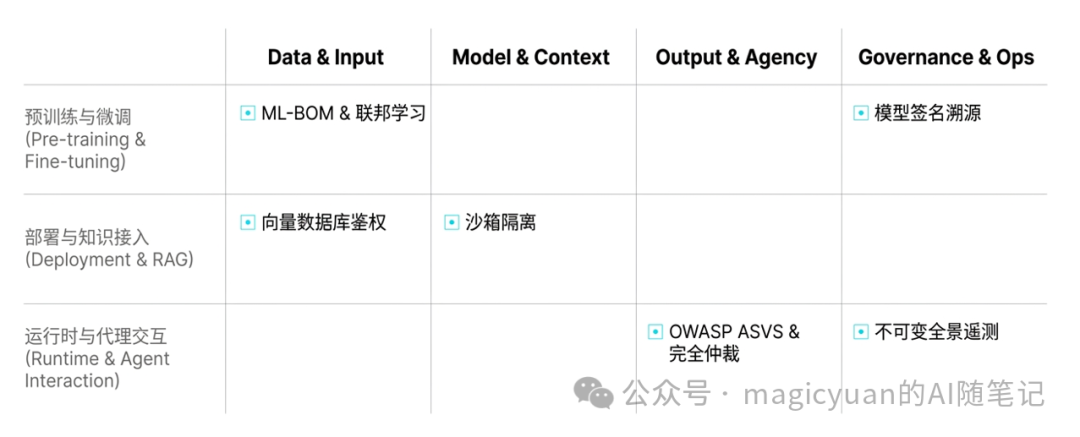
防御的本质不是让 AI 变好。
而是通过架构设计,让 AI 即使犯错也无法对核心系统和数据造成实质性伤害。
所以,真正的安全架构不是单点防御。
只有跨越数据、模型、输出与运营的立体网络,才能抵御 LLM 的系统性风险。