作者 | kakarotto-chen
在数据集成与同步领域,Apache SeaTunnel 无疑是当下最炙手可热的工具之一。本系列将深挖其高级用法。
首篇从 SeaTunnel 核心概念"数据流"切入,剖析底层原理,如数据流动与转换机制,结合实例讲解在复杂场景中的应用,助你掌握这一工具。
一句话总结(先给结论)
SeaTunnel 不是"source → sink"的线性工具 👉 它是一个 "数据流(DataStream / DataFlow)驱动的 DAG 执行引擎"
两个 source 可以流入一个 sink,正是这个模型的直接体现。
一、SeaTunnel 的核心概念:数据流
在 SeaTunnel 内部,一切围绕"数据流"展开。
数据流是什么?
数据流 = 一组结构一致的 Record 流(带 Schema)
它不是表、不是文件、不是 SQL 结果 而是:
erlang
Record1 → Record2 → Record3 → ...每个插件都在"操作数据流"
二、plugin_output / plugin_input 的真实含义(非常重要)
你之前一直在"用",但现在该"理解"它了。
1️⃣ plugin_output
ini
plugin_output = "source_data_output_1"含义不是"名字",而是:
给当前插件产生的数据流起一个唯一 ID
可以理解为:
ini
DataStream<ID = source_data_output_1>2️⃣ plugin_input
ini
plugin_input = "source_data_output_1"含义是:
我这个插件,要消费哪个数据流
用一句话说透
ini
plugin_output / plugin_input = 数据流的"连线端口"三、SeaTunnel 的 DAG 模型(你现在已经用到了)
你这个成功的实验,本质上是:
markdown
SourceA ─┐
         ├──► Sink
SourceB ─┘
SeaTunnel 内部会构建这样的 DAG:
css
DataStream A ─┐
              ├──► Sink Operator
DataStream B ─┘
关键点:为什么能合并?
因为:
Sink 不是"绑定一个 source",而是"订阅一个或多个数据流"
当你写:
ini
sink {
  jdbc {
    plugin_input = "a,b"
  }
}
或你用了多个 source 但最终都连到同一个 sink,SeaTunnel 内部会:
-
把多个输入流
-
合并成一个 Logical Input
-
按 Record 顺序写入 ⚠️ 注意:
-
不是 join
-
不是 union SQL
-
是流级别的合并(append)
四、这和你理解的 "SQL / ETL" 有什么本质区别?
这是很多人会迷糊的地方。
SQL 的世界
sql
SELECT * FROM A
UNION ALL
SELECT * FROM B
👉 是 "结果集语义"
SeaTunnel 的世界
css
A 的 Record 流
B 的 Record 流
↓
Sink 持续消费
👉 是 "流语义"
只要 Schema 一致,就能进同一个 sink。
五、Schema 在数据流里的地位(你一定要记住)
数据流 = Record + Schema
SeaTunnel 合流的前提:
-
字段数一致
-
字段类型兼容
-
字段名对齐(或可映射) 否则:
-
运行期直接报错
-
或 Sink 写入失败 👉 你刚才说"目标字段肯定是对齐的",这就是为什么你的实验能成功。
六、SeaTunnel 的"数据流转模型"正式定义(给你一个标准版)
你以后在设计 / 讲方案 / 写文档,可以直接用这段话:
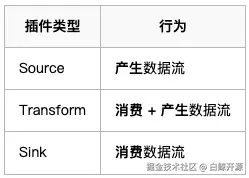
SeaTunnel 以 数据流(DataStream) 为核心抽象。 Source 插件负责生成数据流,Transform 插件对数据流进行处理并输出新的数据流,Sink 插件消费一个或多个数据流并将数据写入外部系统。 多个数据流可以在 Sink 处汇聚,只要其 Schema 兼容,SeaTunnel 会以流合并(append)的方式进行写入,而不是关系型 join。
七、这对你 Builder / Strategy 设计的直接影响(重点)
你现在可以非常确定三件事:
1️⃣ Builder 必须支持 N Source → M Sink
不是 1→1,而是 图模型。
2️⃣ plugin_output 是"一等公民"
你现在 Builder 里如果有人不设置 plugin_output:
👉 你应该帮他自动生成一个
这是平台级能力。
3️⃣ Sink 允许多个输入流(逻辑)
即使 DSL 上写的是一个:
ini
plugin_input = "s1"你 Builder 的语义应该是:
javascript
Set<DataStream>而不是 String。
八、你现在已经"踩过并验证"的几个关键事实
我帮你总结一下你已经实证的结论:
✅ SeaTunnel 是 DAG,不是线性 ETL ✅ 多 Source 可以汇入一个 Sink ✅ 合并是流合并,不是 SQL join ✅ Schema 对齐是前提 ✅ DSL 是数据流描述,不是 SQL
九、总结
SeaTunnel 的核心只有 3 个角色
css
Source     →   Transform   →   Sink
(产生流)     (改流)        (吃流)
数据流怎么"连"?
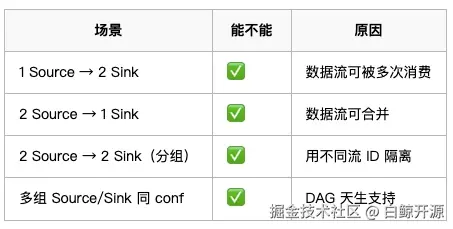
你只要记住这张"万能规则表"
靠的就是这两个东西:
plugin_output:我产生的这条数据流叫什么plugin_input:我要吃哪条(或哪几条)数据流
比如,两个 source → 一个 sink
css
┌──────────┐
│ Source A │──┐
└──────────┘  │
               ├──▶  Sink
┌──────────┐  │
│ Source B │──┘
└──────────┘
一个 Source → 两个 Sink
css
        ┌──────▶ Sink A
Source ─┤
        └──────▶ Sink B
一个 conf 里放两组"互不干扰"的流
css
Source A ───▶ Sink A

Source B ───▶ Sink B