带标注的跌倒检测数据集,识别率88.6%,10793张图,支持yolo,coco json,voc xml,文末有模型训练代码
可识别常见的跌倒或者摔倒姿势,场景较多,包含运动场,马路街道,医院,广场等场景下的跌倒摔倒图片。
模型训练指标参数:

模型训练图:

数据集拆分
总图数:10793 张图数
训练集
9444 张图
验证集
899 张图
测试集
450 张图
预处理
自动定向:应用
调整大小:拉伸到640x640
增强
单个训练样本输出份数:3 份
翻转方式:水平翻转
裁剪缩放:最小缩放比例 0%,最大缩放比例 20%
旋转变换:角度范围 -12° ~ +12°
剪切形变:水平方向 ±2°,垂直方向 ±2°
灰度化:随机对 10% 的图像启用该效果
色相调整:范围 -20° ~ +20°
饱和度调整:范围 -20% ~ +20%
亮度调整:范围 -20% ~ +20%
曝光度调整:范围 -20% ~ +20%
模糊处理:最大模糊程度 0.75 像素
随机遮挡(Cutout):生成 5 个遮挡块,单个遮挡块尺寸为原图的 3%
数据集图片和标注信息示例:
'Fall-Detected'
标签解释
摔倒

数据集图片和标注信息示例:


数据集下载:
yolo26:https://download.csdn.net/download/pbymw8iwm/92908375
yolo v12:https://download.csdn.net/download/pbymw8iwm/92908279
yolo v11:https://download.csdn.net/download/pbymw8iwm/92908282
yolo v9:https://download.csdn.net/download/pbymw8iwm/92908320
yolo v8:https://download.csdn.net/download/pbymw8iwm/92908368
yolo v7:https://download.csdn.net/download/pbymw8iwm/92908351
coco json:https://download.csdn.net/download/pbymw8iwm/92908396
pascal voc xml:https://download.csdn.net/download/pbymw8iwm/92908393
YOLO模型训练
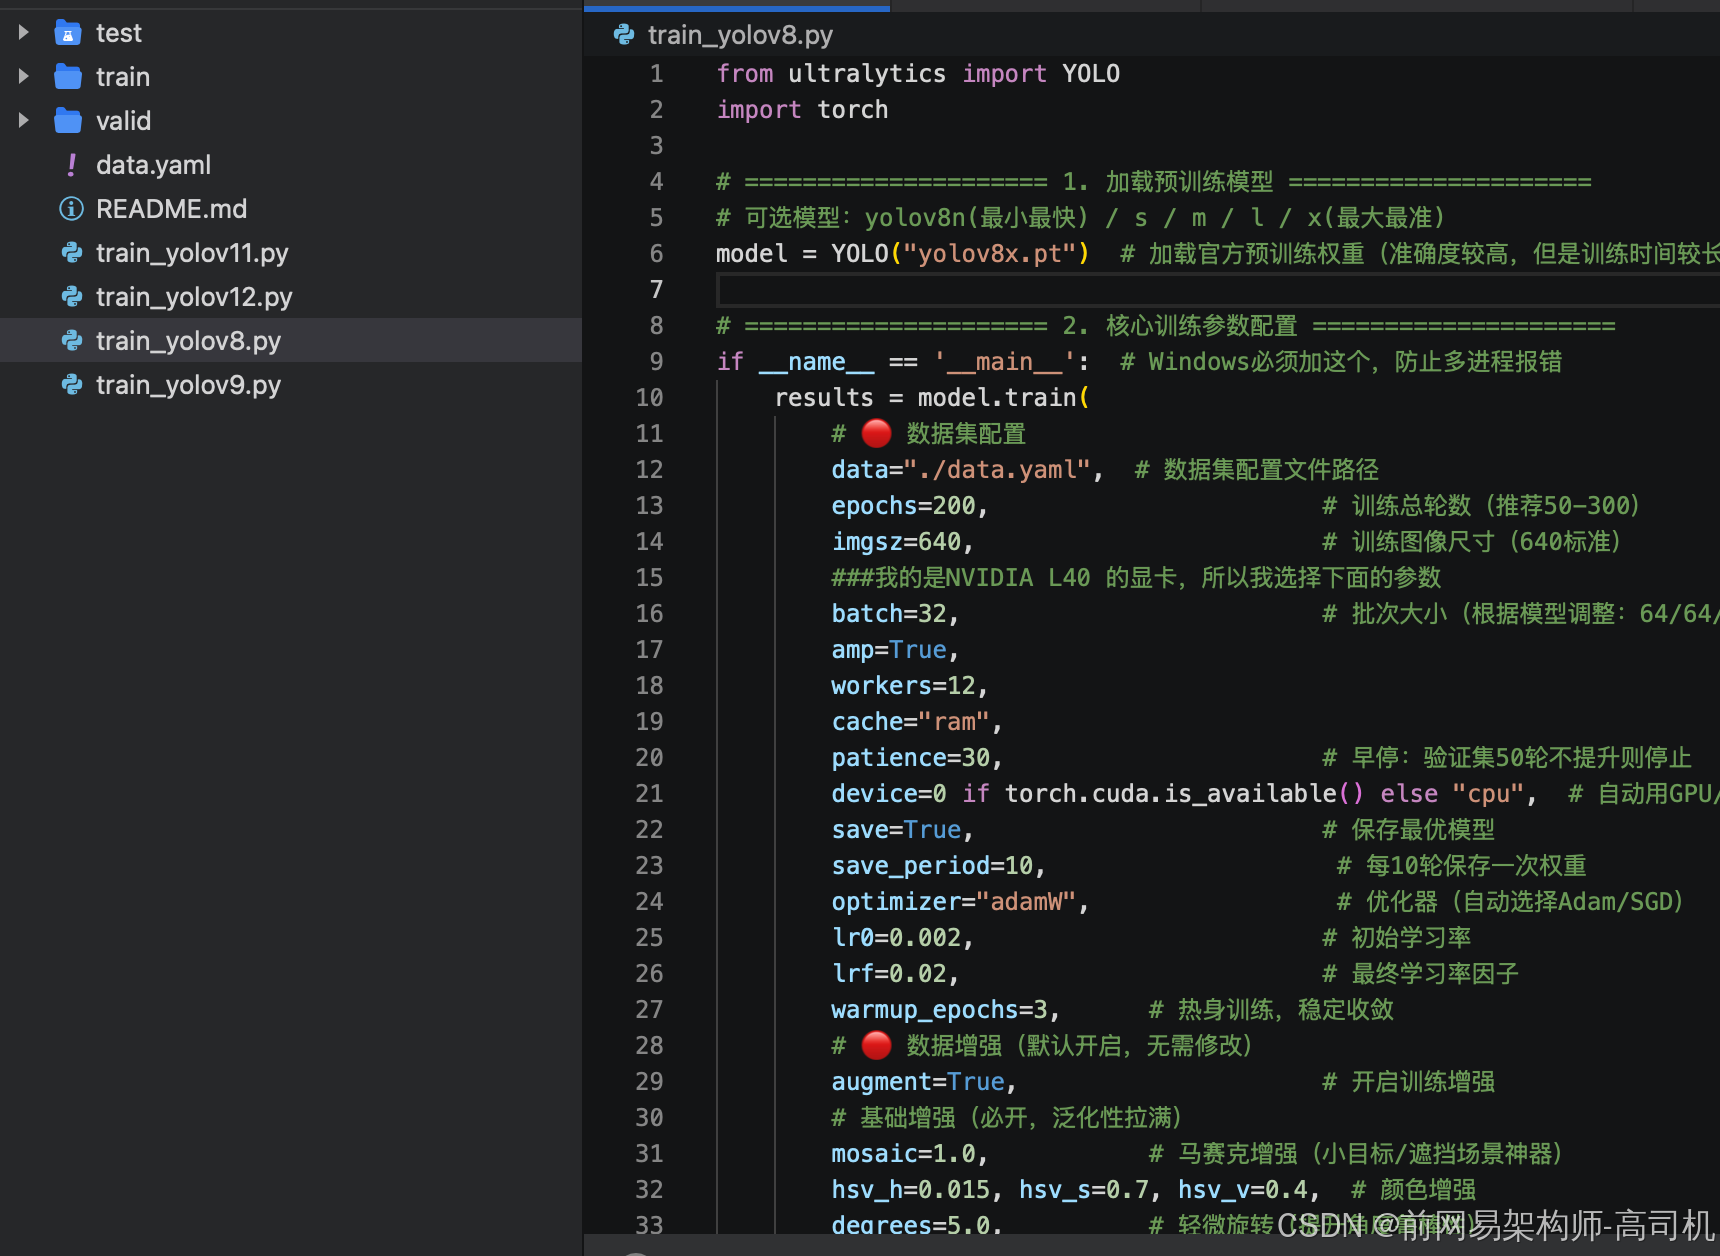
下载数据集之后解压到当前文件夹,然后将 我的仓库 https://gitcode.com/pbymw8iwm/YOLOProject里的训练模型脚本复制到文件夹下,假设你使用的是yolov8来训练你就用 python train_yolov8.py
模糊图片在模型训练中的优势分析
该数据集中包含了如果包含了一些模糊图片,这并非数据缺陷,而是一种精心设计的数据增强策略,能为模型训练带来以下显著优势:
- 提升模型鲁棒性:现实场景中,可能发生在运动模糊,对焦不准或光线不足的情况下。在训练集中引入模糊样本,可以迫使模型学习更本质的特征,而不是过度依赖清晰的边缘或纹理细节,从而提升模型在复杂、非理想成像条件下的识别能力。
- 模拟真实世界噪声:监控摄像头、手机等设备在低光照或快速移动时极易产生模糊。包含此类图片的数据集能让模型提前"见识"并适应这种噪声,减少在实际部署时因图像质量下降而导致的性能骤降。
- 防止模型过拟合 :如果训练集全是高清、摆拍的完美图片,模型容易记住这些特定场景下的"干净"特征,而对新的、稍有模糊的图片泛化能力差。模糊图片作为一种有效的正则化手段,可以增加数据分布的多样性,防止模型过拟合到有限的清晰样本上。
总结 :因此,数据集中包含的模糊图片,与你看到的"水平翻转"、"剪切形变"、"随机遮挡"等增强操作一样,都是为了构建一个更接近真实世界复杂分布的数据环境,从而训练出更健壮、更泛化、更实用的模型。
模型验证测试情况:
验证测试代码:
python
#需要安装pip install ultralytics
from ultralytics import YOLO
import cv2

# 加载训练好的 YOLO .pt 模型
model = YOLO('best.pt')  # 替换为你实际的 .pt 模型文件路径

# 定义要测试的图片路径
image_path = './image.jpg'  # 替换为你实际的图片文件路径

# 使用模型对图片进行预测
results = model(image_path)

# 获取预测结果
for result in results:
    # 获取绘制了检测框的图片
    annotated_image = result.plot()

    # 显示图片
    cv2.imshow("YOLOv Inference", annotated_image)

    # 等待按键退出
    cv2.waitKey(0)

    # 关闭所有 OpenCV 窗口
    cv2.destroyAllWindows()