1. Binary Cross Entropy (BCE, 二元交叉熵)
- 公式 :−ylog(y\^)+(1−y)log(1−y\^)-y\\log(\\hat{y}) + (1-y)\\log(1-\\hat{y})−ylog(y\^)+(1−y)log(1−y\^)
- 特点 :专门用于二分类任务。衡量预测概率分布与真实分布(0或1)之间的差异。
- 核心机制:当真实标签为1时,预测值越接近1,损失越小;当真实标签为0时,预测值越接近0,损失越小。对错误分类的惩罚呈指数级增长。
- 搭配 :通常与 Sigmoid 激活函数配合使用。
2. Cross Entropy Loss (Categorical Cross Entropy, 交叉熵损失)
- 公式 :−∑yilog(y^i)-\sum y_i \log(\hat{y}_i)−∑yilog(y^i)
- 特点 :BCE 在多分类任务上的推广。用于衡量两个概率分布的距离。
- 核心机制:希望预测概率集中在真实类别上。只要真实类别对应的预测概率高,损失就会很小。
- 搭配 :通常与 Softmax 激活函数配合使用,确保输出是一个概率分布(和为1)。
3. Hinge Loss (合页损失)
- 公式 :max(0,1−y⋅y^)\max(0, 1 - y \cdot \hat{y})max(0,1−y⋅y^)
- 特点 :主要用于支持向量机 (SVM)。
- 核心机制:它不仅要求分类正确,还要求分类确信度足够高(函数间隔大于1)。只有当样本被正确分类且距离决策边界超过一定范围时,损失才为0。
- 区别 :不像交叉熵那样关注概率,它更关注分类的边界。
4. KL Divergence (KL 散度 / 相对熵)
- 公式 :DKL(P∣∣Q)=∑P(x)logP(x)Q(x)D_{KL}(P || Q) = \sum P(x) \log \frac{P(x)}{Q(x)}DKL(P∣∣Q)=∑P(x)logQ(x)P(x)
- 特点 :衡量两个概率分布 PPP(真实分布)和 QQQ(预测分布)之间的"距离"。
- 与交叉熵的关系 :
交叉熵=熵+KL散度 \text{交叉熵} = \text{熵} + \text{KL散度} 交叉熵=熵+KL散度
在分类任务中,因为真实分布 PPP 的熵是常数,所以最小化交叉熵等价于最小化 KL 散度。 - 用途:更多用于生成模型(如 VAE、GAN)或知识蒸馏,而在普通分类任务中,直接使用 Cross Entropy 更为普遍和直接。
总结对比表
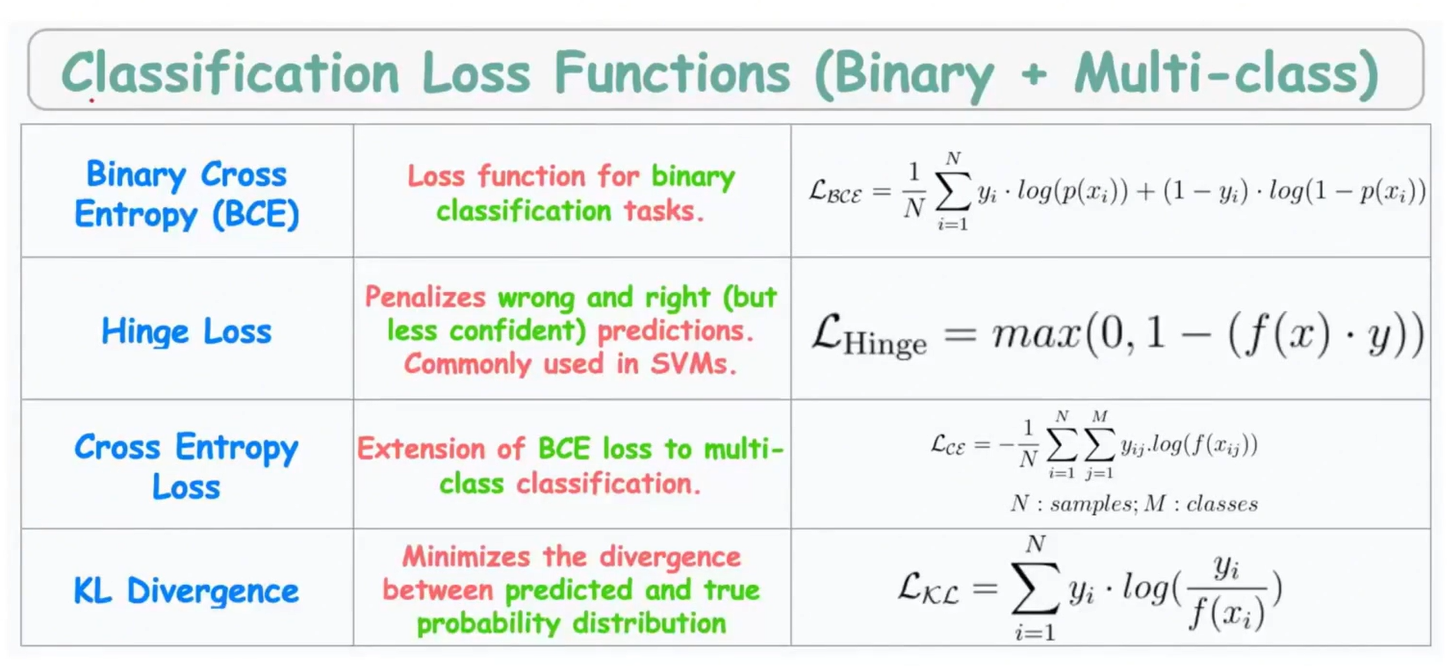
| 损失函数 | 适用任务 | 典型场景 | 核心特点 |
|---|---|---|---|
| Binary Cross Entropy | 二分类 | 逻辑回归、神经网络输出层 | 输出概率,配合 Sigmoid |
| Cross Entropy Loss | 多分类 | 图像分类、文本分类 | 输出概率分布,配合 Softmax |
| Hinge Loss | 二分类 | 支持向量机 (SVM) | 追求最大间隔,不输出概率 |
| KL Divergence | 分布匹配 | 生成模型、知识蒸馏 | 衡量分布相似度,非对称 |