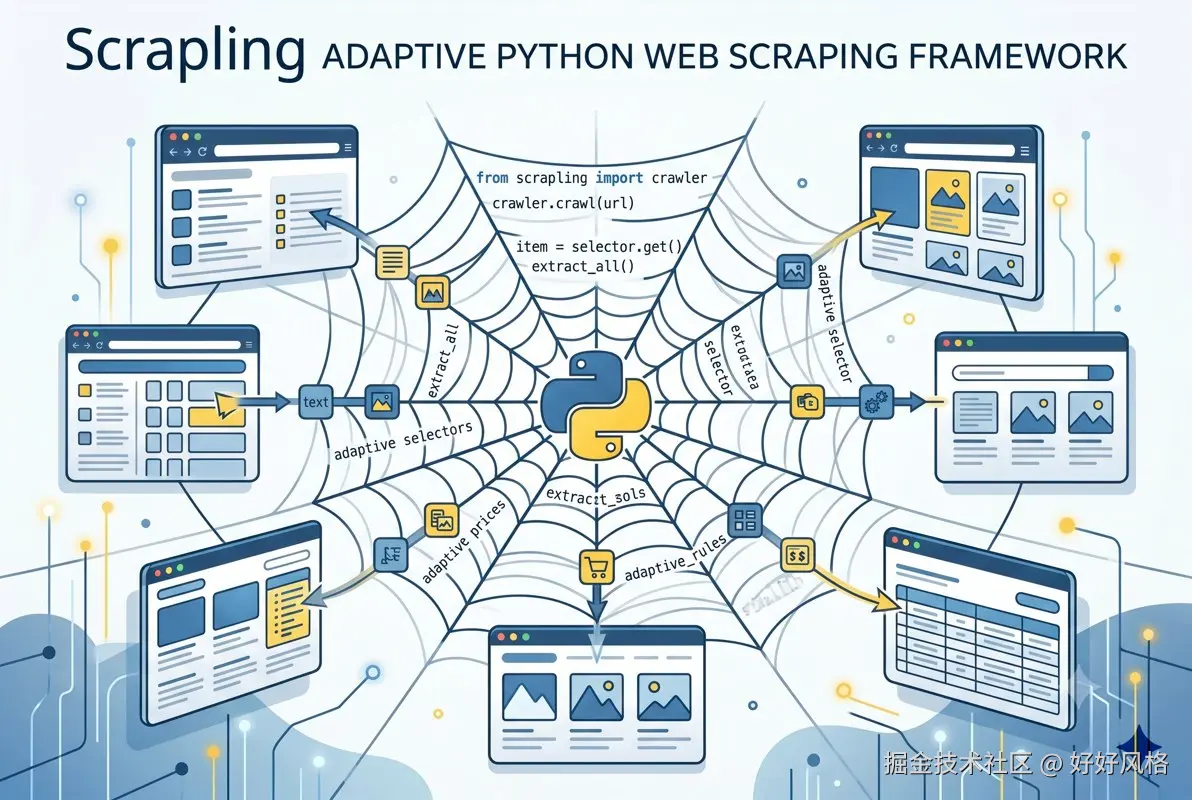
Scrapling 是一个 Python Web 抓取框架,把静态请求、动态页面、隐身抓取、自适应选择器和 MCP 能力放在同一套工具里,适合把网页数据采集做成更稳定的工程能力。
一、为什么值得看
如果你做过网页抓取,最烦的往往不是第一次把数据抓下来,而是页面改版、选择器失效、反爬升级、动态渲染、批量爬取和维护成本叠在一起之后,脚本开始变得脆弱。
Scrapling 的定位很直接:它不是只解决"发一个请求",而是从单次抓取到规模化 crawl 都覆盖,并且把现代网页抓取里常见的几类问题合在一套 Python API 里处理。
项目地址:github.com/D4Vinci/Scr...
二、它的核心思路:抓取结果要能活得久一点
Scrapling 最吸引人的点,是 README 里反复强调的 adaptive scraping:页面结构变了,代码不应该马上报废。它提供的选择器与 auto-save 机制,目标是让同一段抽取逻辑在网站小幅改版后仍尽量可用。
一个最小示例大概是这样:
python
from scrapling.fetchers import Fetcher, AsyncFetcher, StealthyFetcher, DynamicFetcher

StealthyFetcher.adaptive = True
p = StealthyFetcher.fetch('https://example.com', headless=True, network_idle=True)
products = p.css('.product', auto_save=True)
这里的重点不只是 css('.product'),而是 StealthyFetcher、adaptive 和 auto_save 组合在一起:既考虑页面获取方式,也考虑后续选择器维护。
三、四类 Fetcher 覆盖不同场景
Scrapling 把页面获取能力拆成四类入口,分别对应不同复杂度的抓取任务:
- Fetcher :适合普通静态页面,像
requests一样直接拿页面,但返回的是更适合抽取的对象。 - AsyncFetcher:适合需要并发抓取的任务,把网络等待时间摊开。
- DynamicFetcher:面向 JavaScript 渲染页面,底层结合浏览器自动化能力,处理传统 HTTP 请求拿不到内容的页面。
- StealthyFetcher:面向更复杂的现代站点,强调隐身、浏览器指纹、等待网络空闲等抓取工程中经常需要手动补的能力。
Scrapling 的价值在于:这些能力不是分散在一堆胶水脚本里,而是按抓取场景拆成清晰的入口。
四、它不只是"反爬",更像抓取工程框架
很多抓取工具会把卖点集中在 stealth 或 anti-bot 上,但 Scrapling 更值得注意的是工程化部分:
- 既支持 CSS,也支持 XPath 等常见抽取方式;
- 支持静态、异步、动态、隐身等不同获取路径;
- README 明确把 selectors、stealth、Playwright、MCP、AI scraping 都列为主题;
- 开源协议是 BSD-3-Clause,Python 生态接入成本低;
- 截至这次查看,GitHub 已有 6 万多 stars,说明它已经不是一个边缘小工具。
对于团队来说,这类框架的意义不是"今天能不能抓下来",而是能不能把抓取任务变成可复用、可维护、可监控的工程资产。
五、MCP 和 Agent Skill 是新信号
Scrapling README 里还能看到 MCP Server、AI Agent Skill directory、OpenClaw Skill 等入口。这说明它在尝试把网页抓取能力接到 AI Agent 工作流里。
这点很重要。以前抓取工具主要服务脚本和后端任务;现在越来越多数据获取会发生在 Agent 场景:模型需要读网页、比较页面、抽取结构化字段、持续监控变化。Scrapling 这类项目如果把抓取稳定性和 Agent 工具调用打通,会比单纯的浏览器自动化更适合长期使用。
六、适合谁用
如果你的需求只是偶尔抓一个公开页面,普通 requests 加 BeautifulSoup 仍然够用。
但如果你遇到下面这些情况,Scrapling 就值得单独评估:
- 页面经常小改版,选择器维护成本高;
- 需要同时处理静态页、动态页和并发抓取;
- 需要更稳的浏览器抓取和 stealth 能力;
- 想把抓取能力接入 Agent、MCP 或内部自动化平台;
- 希望从脚本堆叠升级到一套更统一的抓取框架。
七、我的判断
Scrapling 代表了 Web Scraping 的一个趋势:不是让开发者写更多一次性脚本,而是把"页面获取、元素定位、动态渲染、隐身、选择器耐久性、Agent 调用"统一成框架能力。
它未必适合所有简单任务,但如果你已经在维护一批网页数据采集任务,或者正在给 AI 应用做外部数据入口,它很可能是值得试用的一类基础设施。
更多内容欢迎关注公众号: