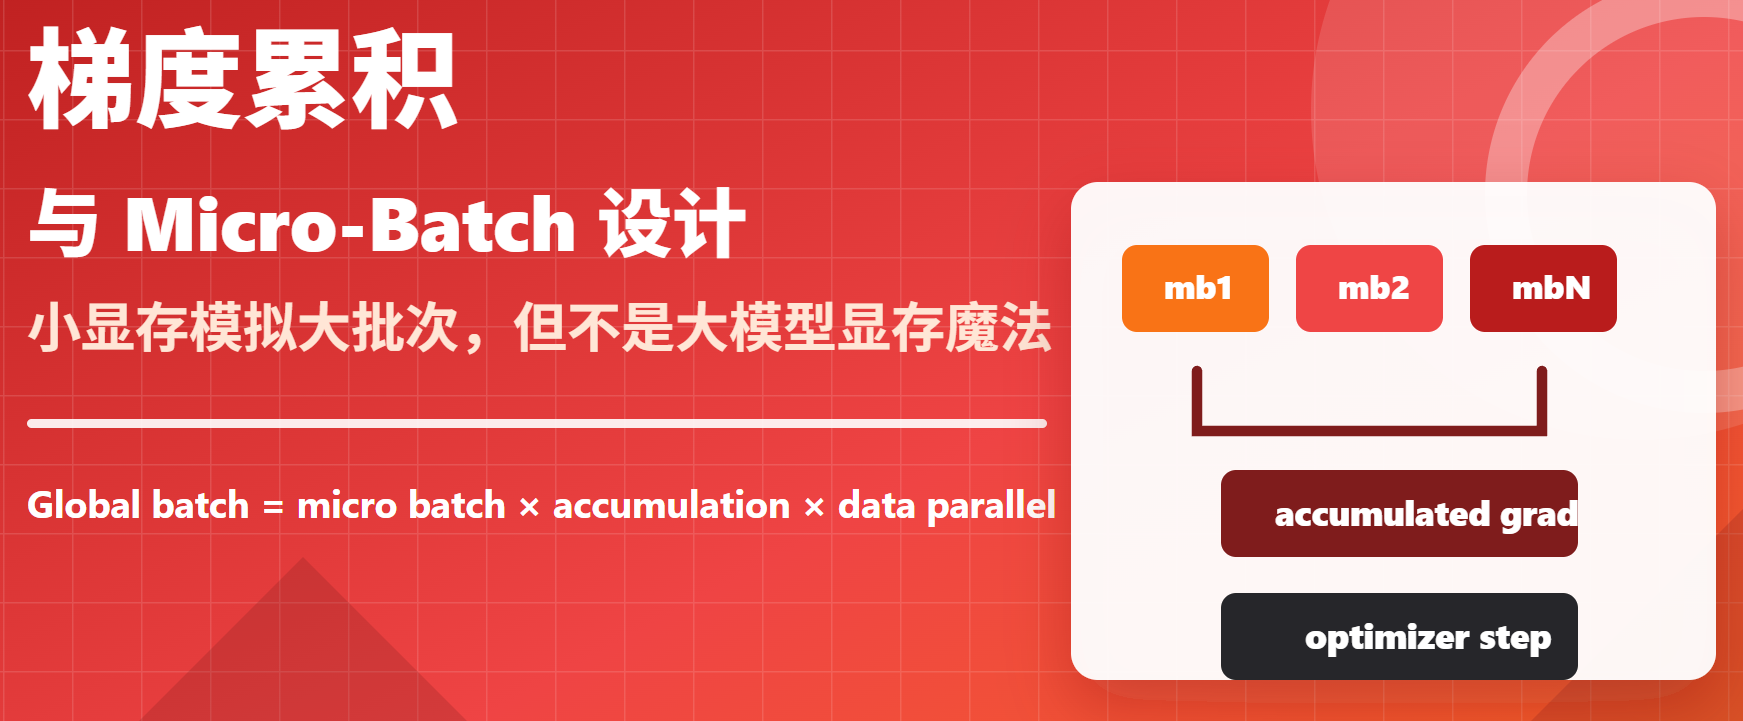
核心结论:梯度累积是"多次 backward 后再 optimizer step",用于在小 micro-batch 下模拟更大的有效 batch。它主要降低单次前向/反向的激活显存,不能降低模型参数、梯度和优化器状态本身。因此,梯度累积不能单独让 16GB 显存全参数训练 64B 模型;这类训练还需要 FSDP/ZeRO、量化/LoRA、offload、激活检查点和模型并行。
第 0 层:30 秒理解
梯度累积的正确公式:
text
global_batch_size
= micro_batch_per_device
  × gradient_accumulation_steps
  × data_parallel_world_size
语言模型更常用 token 口径:
text
tokens_per_update
= valid_tokens_per_micro_batch
  × gradient_accumulation_steps
  × data_parallel_world_size
需要记住三个边界:
text
梯度累积省激活显存,不省参数/梯度/优化器状态
optimizer.step 和 scheduler.step 只在累积窗口末尾发生
变长序列任务按有效 token 总数归一化 loss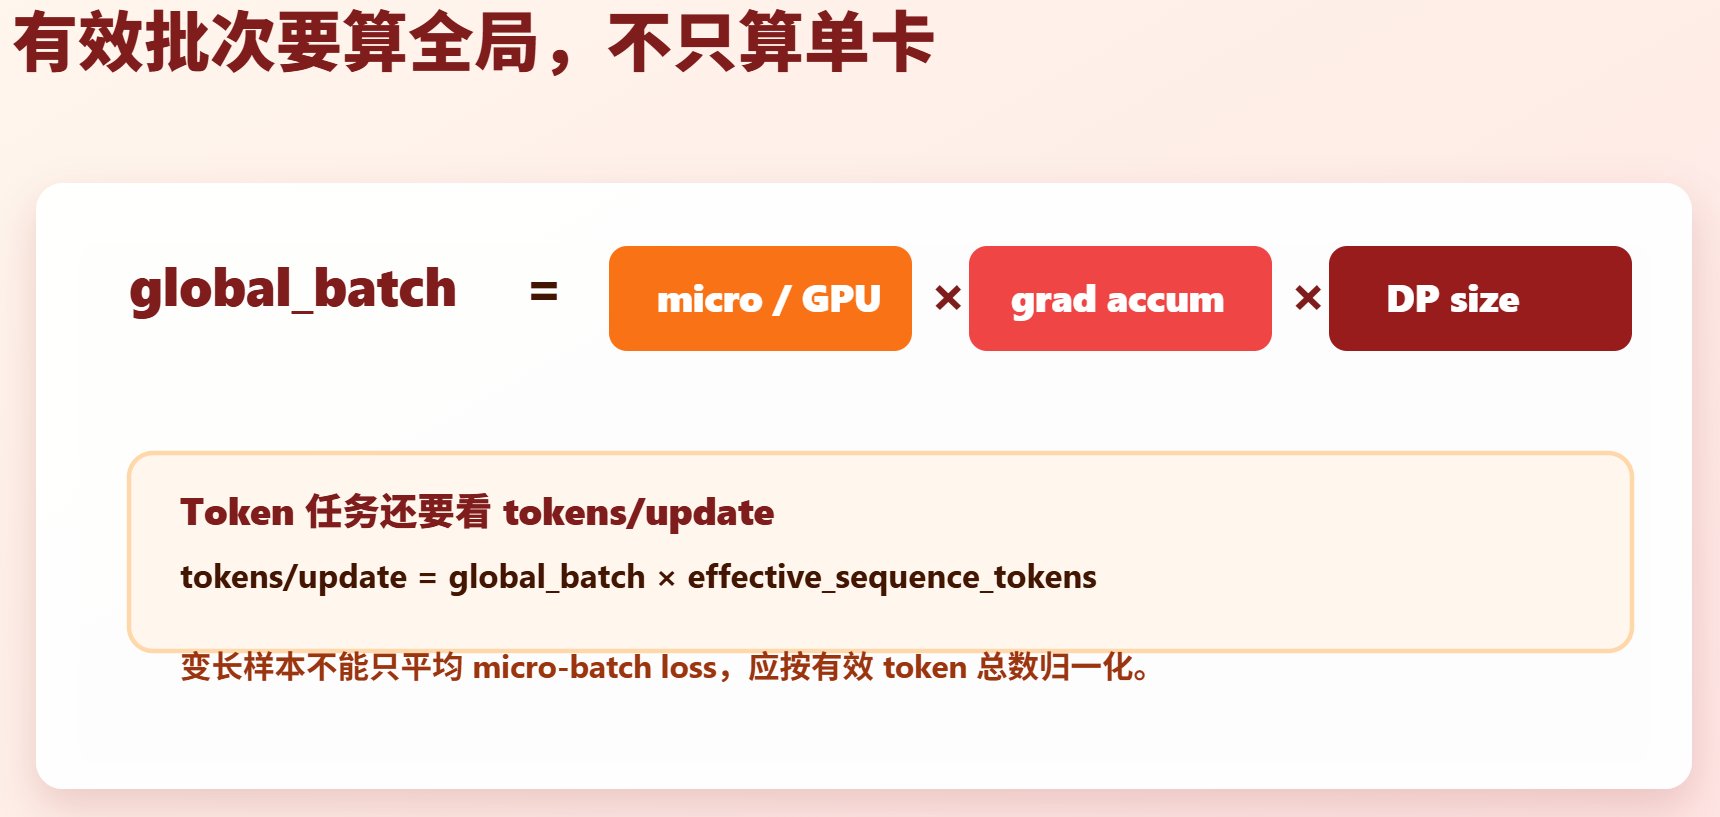
第 1 层:基础概念
1. Micro-Batch、Accumulation、Global Batch
| 名称 | 含义 |
|---|---|
| micro-batch | 一次 forward/backward 进入单张 GPU 的样本数或 token 数 |
| gradient accumulation steps | 累积多少个 micro-batch 后更新一次参数 |
| optimizer step | 真正更新权重的一步 |
| global batch | 一次 optimizer step 实际覆盖的全局样本数 |
| data parallel world size | 参与不同数据分片训练的 GPU / rank 数 |
示例:
text
micro_batch_per_gpu = 2
gradient_accumulation_steps = 8
data_parallel_world_size = 4

global_batch = 2 × 8 × 4 = 64 samples/update
如果用了 Tensor Parallel 或 Pipeline Parallel,要注意:
text
Tensor Parallel 切模型,不增加数据 batch
Pipeline Parallel 切层,pipeline micro-batch 是调度概念,不等于数据并行倍数
只有 Data Parallel / ZeRO / FSDP 的数据并行维度乘进 global batch
2. 梯度累积省了什么
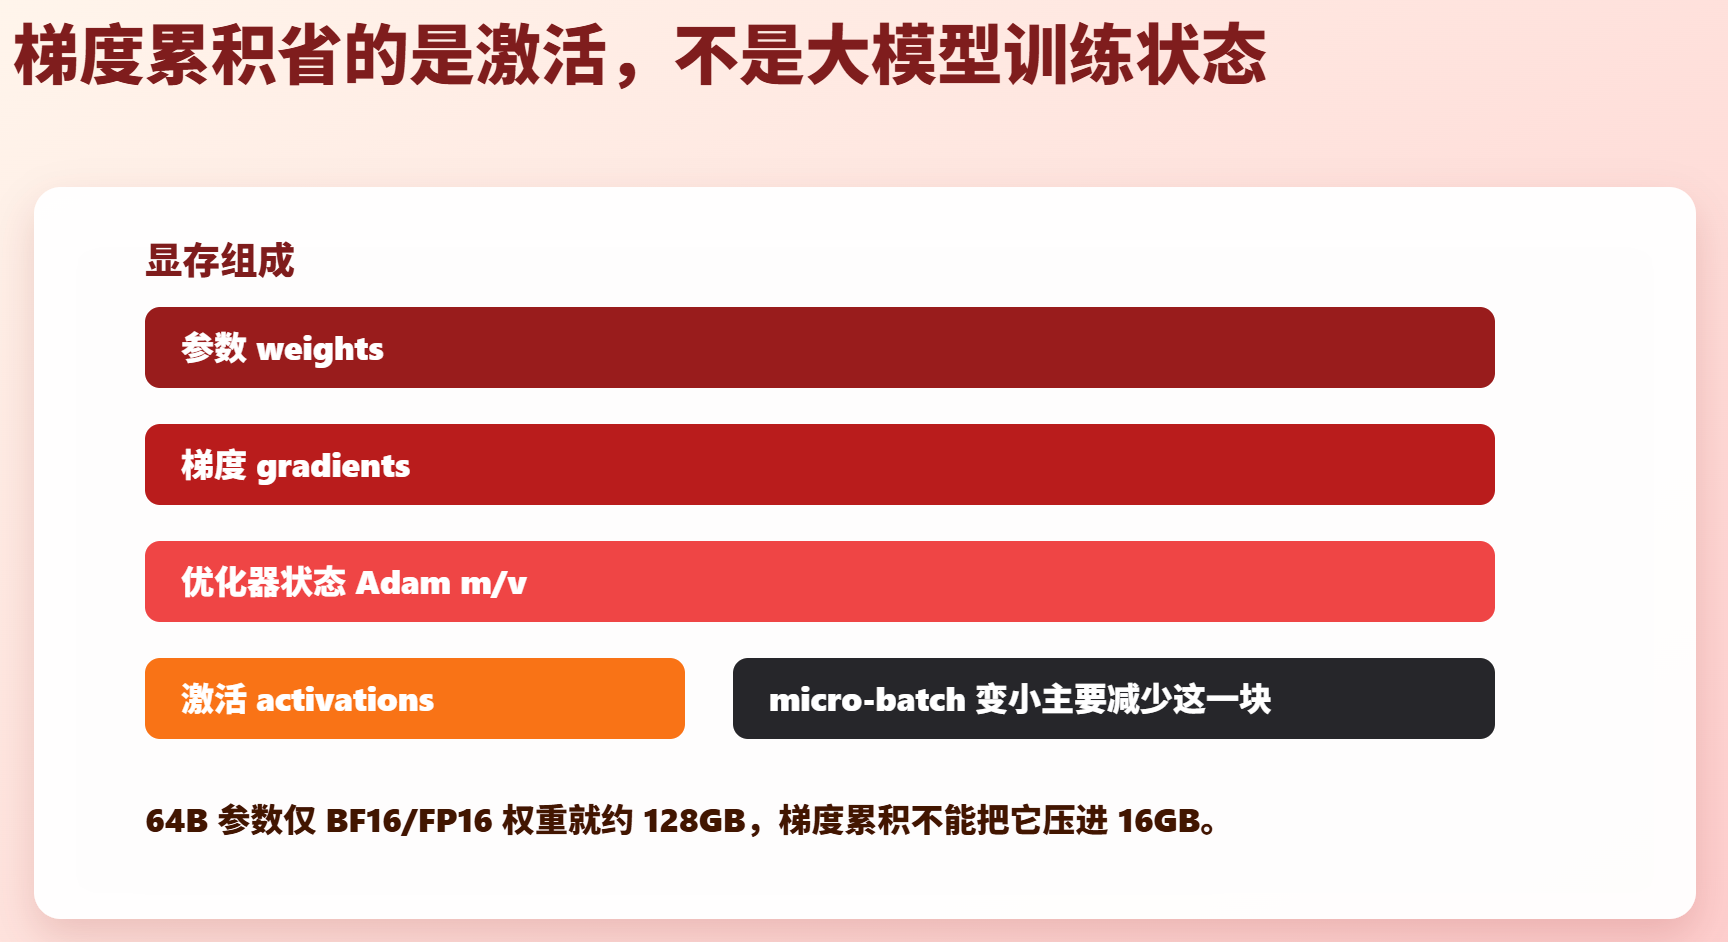
大模型训练显存主要由这些部分组成:
text
参数 weights
梯度 gradients
优化器状态 optimizer states
激活 activations
临时 buffer / 通信 bucket / KV 或 attention 临时张量
micro-batch 变小,主要减少的是:
text
激活 activations
attention 中与 batch/sequence 相关的临时张量
它不减少:
text
模型参数
完整梯度张量
Adam m/v 状态
FP32 master weights
所以更准确的说法是:
text
梯度累积让"激活放不下"的训练跑起来。
FSDP/ZeRO/量化/offload 让"模型状态放不下"的训练跑起来。
3. 和大 batch 的等价条件
梯度累积近似等价于大 batch,需要满足:
text
权重在累积窗口内不更新
每个 micro-batch 的 loss 缩放正确
梯度裁剪发生在累积完成后
optimizer.step、scheduler.step、scaler.update 只发生一次
分布式同步只在窗口末尾发生
随机层和归一化层不会引入显著差异
常见不等价来源:
| 来源 | 原因 |
|---|---|
| BatchNorm | 统计量按 micro-batch 计算,而不是 global batch |
| Dropout / 数据增强 | 随机性导致不完全 bitwise 等价 |
| 变长 token loss | 平均 micro-batch loss 会给短序列过高权重 |
| 梯度裁剪 | 每个 micro-step 裁剪和窗口末尾裁剪不同 |
| 学习率调度 | 按 micro-step 调度会导致 warmup/decay 加速 |
第 2 层:正确实现
1. 固定样本大小的基础写法
如果每个 micro-batch 样本数相同,且可以接受最后不足窗口被单独处理,可以用窗口化写法,避免"最后余数仍除以固定 accumulation_steps"的错误。
python
from itertools import islice


def chunked(iterator, size):
    iterator = iter(iterator)
    while True:
        window = list(islice(iterator, size))
        if not window:
            break
        yield window


def train_one_epoch(model, loader, optimizer, criterion, accumulation_steps, device):
    model.train()

    for window in chunked(loader, accumulation_steps):
        optimizer.zero_grad(set_to_none=True)
        scale = len(window)

        for inputs, labels in window:
            inputs = inputs.to(device, non_blocking=True)
            labels = labels.to(device, non_blocking=True)

            outputs = model(inputs)
            loss = criterion(outputs, labels)
            (loss / scale).backward()

        torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)
        optimizer.step()
如果你设置 drop_last=True,每个窗口都完整,则 loss / accumulation_steps 没问题;如果不丢最后余数,就要按实际窗口长度缩放。
2. AMP + 梯度累积
混合精度下,关键顺序是:
text
每个 micro-step:scaler.scale(loss / scale).backward()
窗口末尾:scaler.unscale_ -> clip -> scaler.step -> scaler.update
python
import torch
from torch.amp import GradScaler, autocast


def train_amp_accum(model, loader, optimizer, criterion, accumulation_steps, device):
    scaler = GradScaler("cuda")
    model.train()

    for window in chunked(loader, accumulation_steps):
        optimizer.zero_grad(set_to_none=True)
        scale = len(window)

        for inputs, labels in window:
            inputs = inputs.to(device, non_blocking=True)
            labels = labels.to(device, non_blocking=True)

            with autocast(device_type="cuda", dtype=torch.float16):
                outputs = model(inputs)
                loss = criterion(outputs, labels)

            scaler.scale(loss / scale).backward()

        scaler.unscale_(optimizer)
        torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)
        scaler.step(optimizer)
        scaler.update()
3. 变长 token 任务的正确 loss
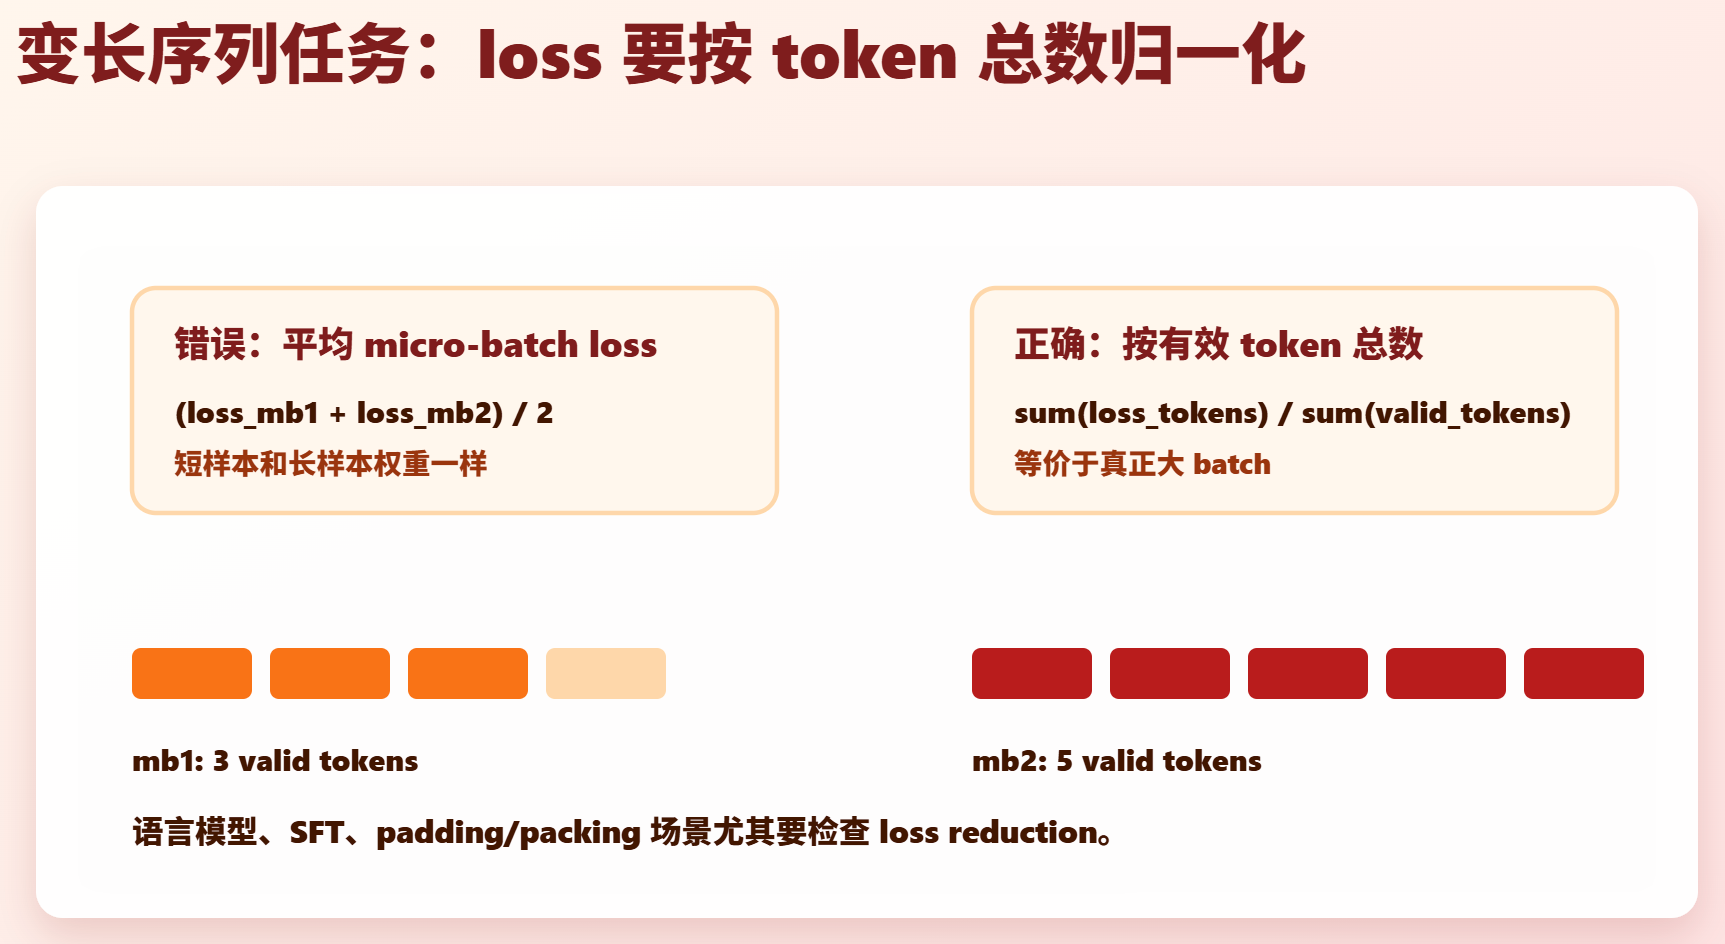
对语言模型、SFT、带 padding 的序列任务,不建议这样做:
text
(loss_mb1 + loss_mb2 + ... + loss_mbN) / N因为每个 micro-batch 的有效 token 数可能不同。正确做法是:
text
窗口 loss = sum(all token losses in window) / sum(valid tokens in window)实现时可先统计窗口内有效 token 总数,再逐个 micro-batch backward:
python
import torch.nn.functional as F


def train_token_accum(model, loader, optimizer, accumulation_steps, device, ignore_index=-100):
    model.train()

    for window in chunked(loader, accumulation_steps):
        optimizer.zero_grad(set_to_none=True)

        valid_tokens = 0
        for batch in window:
            labels = batch["labels"]
            valid_tokens += int((labels != ignore_index).sum())

        valid_tokens = max(valid_tokens, 1)

        for batch in window:
            input_ids = batch["input_ids"].to(device, non_blocking=True)
            labels = batch["labels"].to(device, non_blocking=True)

            logits = model(input_ids).logits
            loss_sum = F.cross_entropy(
                logits.view(-1, logits.size(-1)),
                labels.view(-1),
                ignore_index=ignore_index,
                reduction="sum",
            )
            (loss_sum / valid_tokens).backward()

        torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)
        optimizer.step()
这比简单 loss / accumulation_steps 更接近真正大 batch 的 token-level loss。
分布式训练时,valid_tokens 也应按数据并行组求和。注意 PyTorch DDP 默认会对各 rank 梯度取平均,因此本地 loss_sum 要乘以 data_parallel_world_size / global_valid_tokens,才等价于全局 token 平均:
python
count = torch.tensor([valid_tokens], device=device, dtype=torch.float32)
torch.distributed.all_reduce(count, op=torch.distributed.ReduceOp.SUM)

dp_size = torch.distributed.get_world_size()
global_valid_tokens = max(float(count.item()), 1.0)
loss_scale = dp_size / global_valid_tokens

(loss_sum * loss_scale).backward()
4. DDP 中的 no_sync
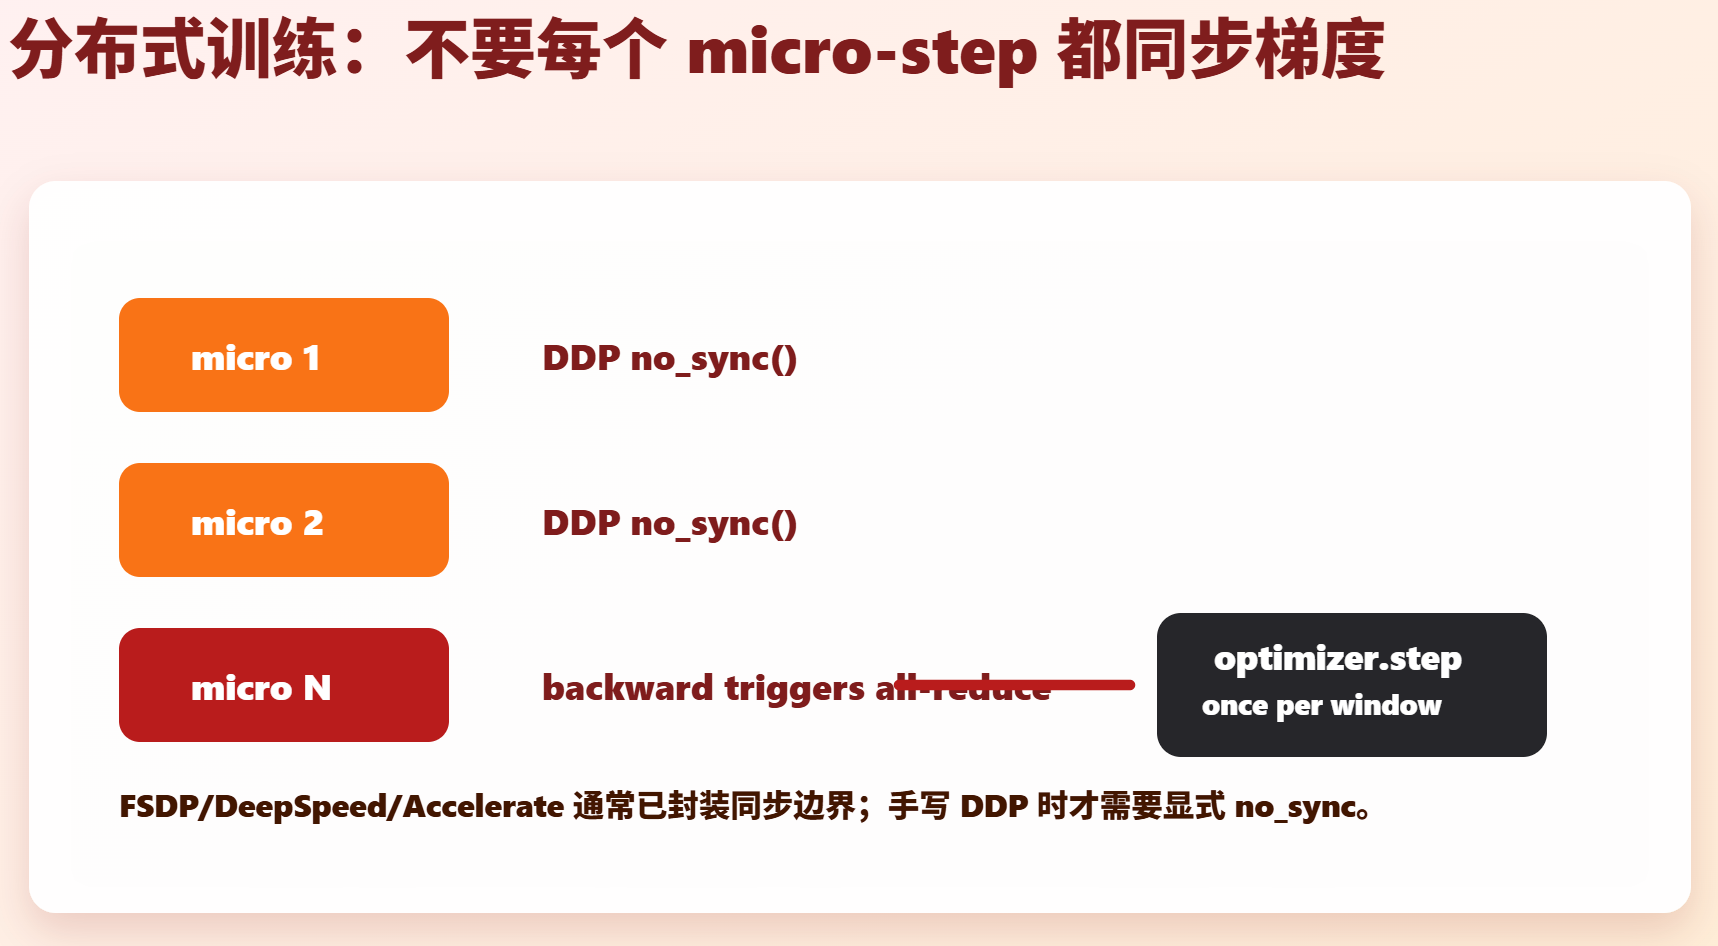
PyTorch DDP 默认每次 backward 都会触发梯度同步。做梯度累积时,非最后 micro-step 应避免同步:
python
from contextlib import nullcontext


def train_ddp_accum(ddp_model, loader, optimizer, criterion, accumulation_steps, device):
    ddp_model.train()

    for window in chunked(loader, accumulation_steps):
        optimizer.zero_grad(set_to_none=True)
        scale = len(window)

        for micro_idx, (inputs, labels) in enumerate(window):
            is_last_micro = micro_idx == scale - 1
            sync_context = nullcontext() if is_last_micro else ddp_model.no_sync()

            with sync_context:
                inputs = inputs.to(device, non_blocking=True)
                labels = labels.to(device, non_blocking=True)
                outputs = ddp_model(inputs)
                loss = criterion(outputs, labels)
                (loss / scale).backward()

        torch.nn.utils.clip_grad_norm_(ddp_model.parameters(), max_norm=1.0)
        optimizer.step()
Hugging Face Accelerate、DeepSpeed、FSDP 等框架通常已经封装了同步边界,优先用框架提供的 gradient_accumulation_steps,不要手写重复 all-reduce。
第 3 层:系统集成
1. DeepSpeed / ZeRO 的 batch 公式
DeepSpeed 常用配置之间满足:
text
train_batch_size
= train_micro_batch_size_per_gpu
  × gradient_accumulation_steps
  × number_of_data_parallel_workers
其中 ZeRO/FSDP 解决训练状态分片,梯度累积解决 micro-batch 太小导致 global batch 不够的问题。两者通常组合使用:
text
BF16/FP16 + ZeRO/FSDP + activation checkpointing + gradient accumulation不要把它们混成一种能力:
| 技术 | 主要减少 |
|---|---|
| 梯度累积 | 单次 micro-batch 激活峰值 |
| 激活检查点 | 激活保存量 |
| ZeRO/FSDP | 参数、梯度、优化器状态复制 |
| Tensor/Pipeline Parallel | 单卡模型计算/参数压力 |
| QLoRA | 微调时基座权重和优化器状态成本 |
2. Scheduler、logging、checkpoint 的计数
一个常见 bug 是把 micro-step 当 optimizer step。
正确计数:
text
micro_step:每个 micro-batch backward 一次
optimizer_step:每个 accumulation window 更新一次
global_step:通常等于 optimizer_step
这些应按 optimizer step 计:
text
learning rate scheduler
warmup steps
weight update count
checkpoint interval
evaluation interval
logging 的 global_step
吞吐则建议同时记录:
text
samples/sec
tokens/sec
optimizer_steps/sec
3. 梯度裁剪
不要在每个 micro-step 裁剪梯度。应该:
text
累积窗口内 backward
窗口末尾得到最终累计梯度
AMP 时先 unscale_
对最终梯度 clip_grad_norm_
optimizer.step
每个 micro-step 裁剪会改变梯度方向,和大 batch 不等价。
第 4 层:Micro-Batch 设计指南
1. Micro-Batch 越大通常越快
在显存允许下,优先选择能放下的最大 micro-batch:
text
micro-batch 太小:GPU 利用率差,kernel launch overhead 高,吞吐下降
micro-batch 太大:激活峰值高,容易 OOM
LLM 微调中 micro_batch=1 很常见,不是错误;只是吞吐可能较低,需要靠 packing、FlashAttention、gradient checkpointing、ZeRO/FSDP 等补救。
2. 长度分桶比内容排序更实用
原稿提到"基于内容相似度排序 micro-batch"。实际训练中更常见、也更安全的是:
text
按序列长度 bucketing,减少 padding 浪费
bucket 内仍随机打乱,保持样本随机性
packing 多个短样本,提高 token 利用率
不建议默认按语义相似度排序,因为这会改变数据随机性,可能引入课程学习或分布偏移。除非你明确在做 curriculum learning,否则先用随机采样 + length bucketing。
3. 有效 batch 不是越大越好
有效 batch 增大后,梯度噪声变小,训练更平稳,但也可能:
text
每个 epoch 的 optimizer step 变少
需要重新调学习率和 warmup
泛化变差或收敛到不同解
吞吐因 micro-batch 太小而下降
经验做法:
text
先确定目标 tokens/update 或 samples/update
在显存允许下最大化 micro-batch
用 accumulation 补齐 global batch
保持 scheduler 以 optimizer step 或 total tokens 为基准
第 5 层:常见问题排查
| 症状 | 可能原因 | 修正 |
|---|---|---|
| 16GB 仍 OOM | 参数/优化器状态放不下,不是激活问题 | 用 FSDP/ZeRO、QLoRA、offload、量化,不能只靠累积 |
| loss 与真正大 batch 不一致 | 变长 token loss 平均方式错误 | 使用 reduction="sum" 后按总有效 token 数归一化 |
| DDP 训练很慢 | 每个 micro-step 都 all-reduce | 非最后 micro-step 使用 no_sync() 或框架 accumulation |
| 学习率衰减太快 | scheduler 按 micro-step 调用 | 只在 optimizer step 后调用 scheduler |
| 梯度裁剪后收敛差 | 每个 micro-step 裁剪 | 累积完成后裁剪一次 |
| BatchNorm 模型效果变差 | BN 统计按 micro-batch 计算 | 增大 micro-batch、SyncBatchNorm、GroupNorm,或重新调 BN 策略 |
| 吞吐很低 | micro-batch 太小,GPU 利用率差 | 增大 micro-batch,开启 packing/checkpoint/FlashAttention,减少 accumulation |
| 日志 batch size 对不上 | 没乘 data_parallel_world_size | 使用 global batch 公式统一口径 |
参考资料
- Hugging Face Accelerate 梯度累积指南:https://huggingface.co/docs/accelerate/usage_guides/gradient_accumulation
- PyTorch DDP
no_sync文档:https://docs.pytorch.org/docs/stable/generated/torch.nn.parallel.DistributedDataParallel.html - DeepSpeed batch size 配置:https://www.deepspeed.ai/docs/config-json/#batch-size-related-parameters
- Hugging Face 关于梯度累积 loss 修复的说明:https://huggingface.co/blog/gradient_accumulation
- PyTorch AMP 文档:https://docs.pytorch.org/docs/stable/amp.html
- DeepSpeed ZeRO 文档:https://deepspeed.readthedocs.io/en/stable/zero3.html
- Goyal et al., Accurate, Large Minibatch SGD: Training ImageNet in 1 Hour:https://arxiv.org/abs/1706.02677