数据密集型应用系统设计--其一

提示:文章写完后,目录可以自动生成,如何生成可参考右边的帮助文档

文章目录


前言

作者水平有限,一切以作者的理解为主


一、twitter经典例子

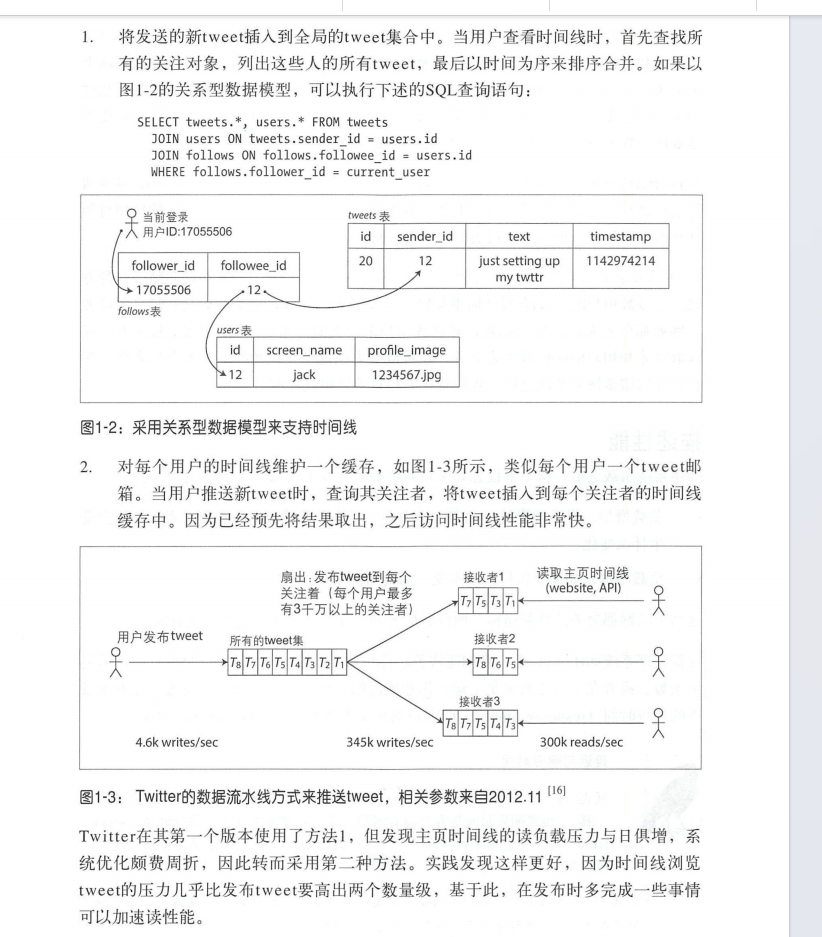
峰值是12K QPS,作者讲述了两种方式,第一种是关系型数据库,我们叫他web模式;第二种是数据流,我们叫他大数据模式。web模式的好处是在用户刷新时才加载新的帖子,如果用户不访问就可以省下一次资源,大数据模式是实时推送缓存,不管用户刷新不刷新都是一次或多次缓存写入,也不太能保证顺序性。作者引出,如果粉丝量大或者只是达到平均75,写入压力都会比较大,不能解决大量粉丝的问题,对于这个twitter的办法是退回方法一,可能是加载一个窗口的排序好的数据。我其实有一个疑问,作者感觉一直在介绍大数据系统的好处,我不太了解其用意,后来我猜测,猜错了,想了一些没用的。
示例:pandas 是基于NumPy 的一种工具,该工具是为了解决数据分析任务而创建的。

二、使用步骤


总结

相关推荐
方方洛7 小时前
ray教程-00-前言与导读
人工智能·分布式·机器学习
方方洛7 小时前
ray教程-01-认识Ray
人工智能·分布式·机器学习
yexianglunbai12 小时前
RabbitMQ 详解:从入门到实战
分布式·rabbitmq
此时不提桶,更待何时13 小时前
06-16-B-Kafka面试与生产事故实战
分布式·面试·kafka
mesyinjinghan14 小时前
半导体 MES 与 ERP 的接口边界:六类单据该留在哪一层
分布式·eap·半导体mes
codigger14 小时前
Redis 正式接入 AI:当"最懂速度的数据库"开始解决"记忆问题"
redis·分布式·后端·ai·向量检索
樱花落木兰15 小时前
Redisson 可重入分布式锁底层原理详解
分布式
此时不提桶,更待何时1 天前
06-12-A-Kafka存储深水区与源码解析详解
分布式·kafka·linq
此时不提桶,更待何时1 天前
06-15-A-Kafka生态集成与流处理详解
分布式·kafka
此时不提桶,更待何时2 天前
06-13-A-Kafka客户端与协议深入详解
分布式·kafka