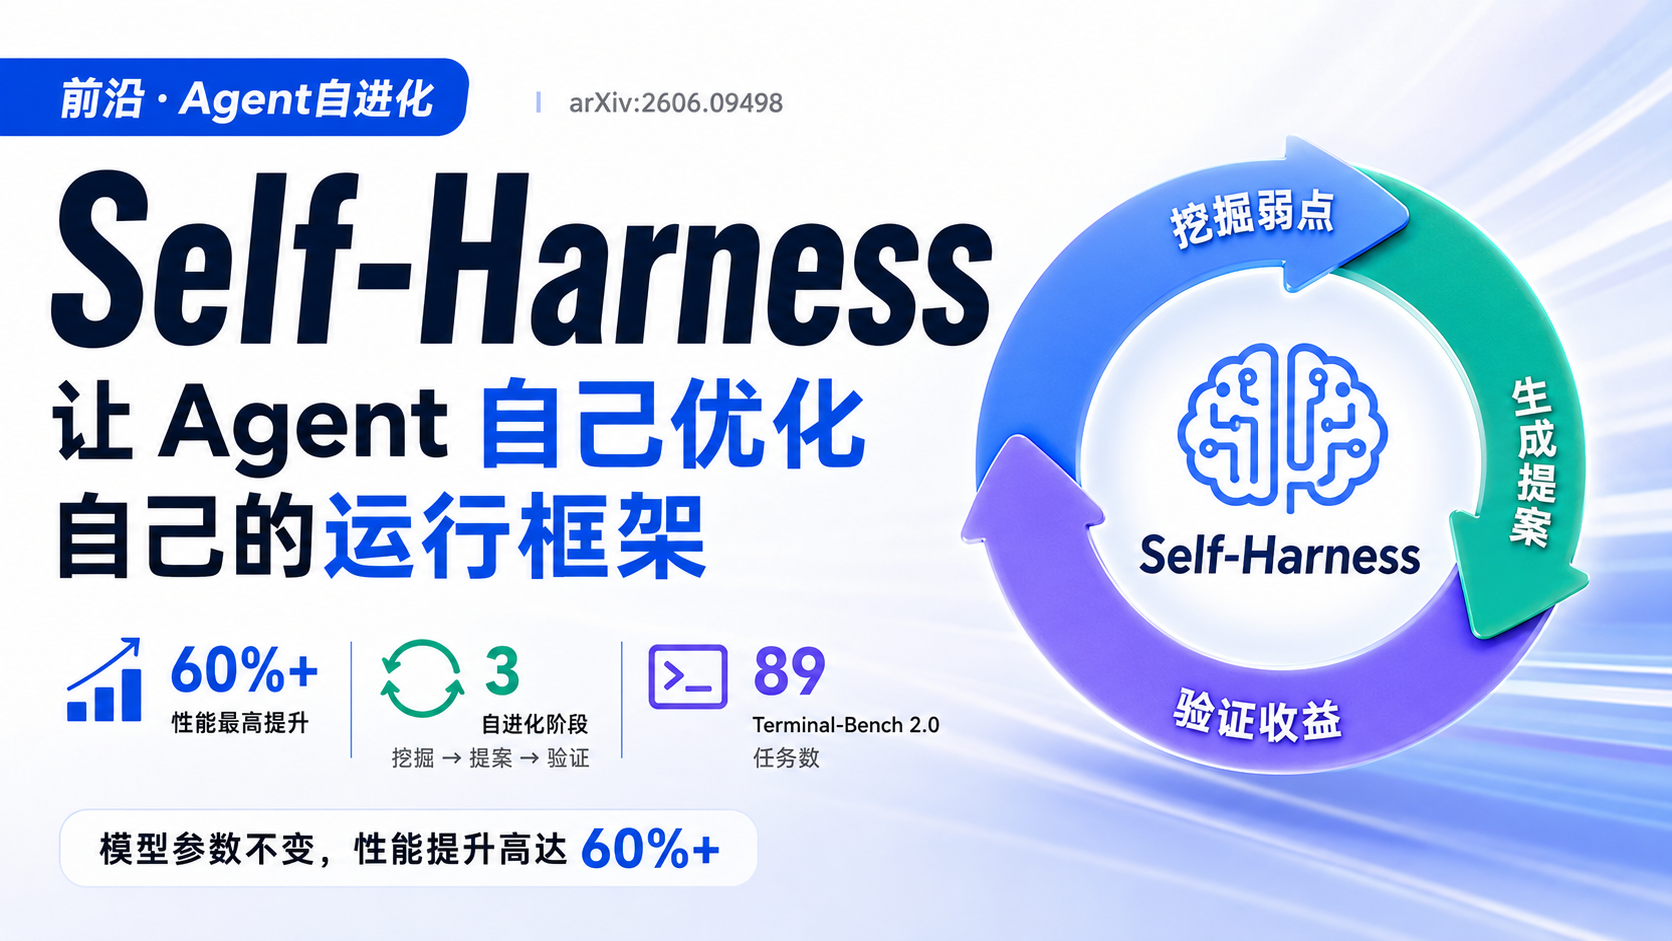
论文 :Self-Harness: Harnesses That Improve Themselves
作者 :Hangfan Zhang, Shao Zhang, Kangcong Li, Chen Zhang, Yang Chen, Yiqun Zhang, Lei Bai, Shuyue Hu
机构 :上海人工智能实验室 (Shanghai AI Lab)
arXiv :2606.09498 · 2026-06-08
关键词:LLM Agent / 自进化 / Harness优化 / 固定参数模型 / Terminal-Bench
写在前面(5 行读懂)
- 核心命题:不改变 LLM 任何参数,让 Agent 自己优化自己的运行框架(Harness)
- 三阶段循环:Weakness Mining(弱点挖掘)→ Harness Proposal(修补提议)→ Proposal Validation(回归验证)
- 实验数据:MiniMax M2.5 在 Terminal-Bench 2.0 上从 40.5% 跑到 61.9%(+52.8% 相对提升),Qwen3.5-35B-A3B 从 23.8% 到 38.1%(+60.1%),GLM-5 从 42.9% 到 57.1%(+33.1%)
- 核心发现 :同一套框架在三个不同模型上挖出三种完全不同的弱点 ------ Harness 设计本质上是模型相关的
- 工程价值:Harness 优化的 ROI 远高于模型升级;50-100 跑一轮 Self-Harness \> 5000 换更大模型
目录
- 一、为什么这篇论文值得读
- 二、核心方法:三阶段自进化循环
- [三、实验数据:三个模型 × 三种弱点 × 三种修补](#三、实验数据:三个模型 × 三种弱点 × 三种修补)
- [四、关键概念辨析:Harness-Updating vs Harness-Benefit](#四、关键概念辨析:Harness-Updating vs Harness-Benefit)
- [五、与 AgeMem 的互补关系](#五、与 AgeMem 的互补关系)
- [六、So What:三类人的行动清单](#六、So What:三类人的行动清单)
- 七、方法论局限
- 八、复现指南
- 九、总结与延伸阅读
一、为什么这篇论文值得读
大多数人聊 Agent 能力提升时,眼睛只盯一件事:换更大的模型。GPT-5、Claude Opus、Gemini Ultra ------ 仿佛性能瓶颈就在参数量上。
这篇论文换了个角度,提出了一个反直觉的命题:
LLM Agent 的性能由两部分共同决定------基座模型(Base Model)+ Harness(介于模型和环境之间的工程层)。今天我们只关心前者,但后者其实有着 30%-60% 的优化空间。
什么是 Harness?论文给出的定义是:所有"如何使用模型"的工程要素,包括:
- 📝 系统提示词(System Prompt)
- 🔧 工具包装器(Tool Wrappers)
- 📐 规划模板(Planning Templates)
- ✅ 验证逻辑(Verification Steps)
不同模型表现出不同的失败模式,所以 Harness 设计本质上是模型相关的。但今天的 Harness 还是靠人类工程师手写------这种范式在 LLM 快速迭代的当下完全不可扩展。
Self-Harness 解决的问题:能不能把"调 Harness"这件事也变成 Agent 自己做的工作?
答案:能。而且效果惊人。
三个反直觉发现
发现①:模型参数没动,性能却涨了 60%
| 模型 | 初始通过率 | 优化后通过率 | 绝对增益 | 相对提升 |
|---|---|---|---|---|
| MiniMax M2.5 | 40.5% | 61.9% | +21.4pp | +52.8% |
| Qwen3.5-35B-A3B | 23.8% | 38.1% | +14.3pp | +60.1% |
| GLM-5 | 42.9% | 57.1% | +14.2pp | +33.1% |
模型完全没换,改的只是 Harness。
发现②:能进化的不只有模型,还有"使用模型的方式"
传统范式下,Harness 由人类工程师手写------慢、贵、不可扩展。Self-Harness 让 LLM 自己诊断弱点、生成修补、用回归测试验证后采纳。三阶段全自动闭环,不需要更聪明的外部模型。
发现③:能写好 Harness ≠ 能用好 Harness
姊妹论文 arXiv:2605.30621 证明:弱模型也能生成高质量 Harness 更新(与 Claude Opus 4.6 相当),但能否从更新中受益呈倒 U 型------中等能力模型获益最大。更新是手段,收益才是目的。
二、核心方法:三阶段自进化循环
Self-Harness 的核心是一个三阶段的迭代循环:
┌──────────────────────────────────────────────────┐
│           Self-Harness 自进化循环                 │
├──────────────────────────────────────────────────┤
│                                                  │
│   执行轨迹 (Execution Traces)                    │
│        ↓                                         │
│   ┌──────────────────────────┐                   │
│   │ Stage 1: Weakness Mining │                   │
│   │ 从执行轨迹挖掘失败模式    │                   │
│   └────────────┬─────────────┘                   │
│                ↓                                 │
│   ┌──────────────────────────┐                   │
│   │ Stage 2: Harness Proposal│                   │
│   │ 生成多样且最小化的修补    │                   │
│   └────────────┬─────────────┘                   │
│                ↓                                 │
│   ┌──────────────────────────┐                   │
│   │ Stage 3: Proposal        │                   │
│   │ Validation 回归测试门控   │                   │
│   └────────────┬─────────────┘                   │
│                ↓                                 │
│        通过 → 更新 Harness → 回到起点              │
│        不通过 → 返回 Stage 2 重新提案             │
│                                                  │
└──────────────────────────────────────────────────┘
Stage 1:Weakness Mining(弱点挖掘)
输入:Agent 在任务上的执行轨迹(工具调用、响应内容、推理步骤、终端输出、错误消息、成功/失败状态)
输出:按"频率 × 影响度"排序的弱点模式列表
五维归类:
| 维度 | 描述 | 示例 |
|---|---|---|
| Tool Selection Errors | 工具选择错误 | 用 cat 而不是 head 读大文件导致超时 |
| Context Errors | 上下文管理错误 | 长任务中丢失中间状态 |
| Planning Errors | 规划错误 | 跳步、漏步、循环重试 |
| Error Handling | 错误处理缺失 | 失败后不重试不报错 |
| Verification Gaps | 验证缺失 | 文件操作后不校验结果 |
算法核心:
python
def weakness_mining(execution_traces):
    # 1. 提取失败案例
    failures = [t for t in execution_traces if not t.success]

    # 2. 用 embedding 聚类相似失败
    failure_clusters = embedding_cluster(failures)

    # 3. LLM 分析共同失败模式并追溯根本原因
    patterns = []
    for cluster in failure_clusters:
        pattern = llm_analyze_root_cause(cluster)
        patterns.append(pattern)

    # 4. 按"频率 × 影响度"排序
    return sorted(patterns,
                  key=lambda p: p.frequency * p.impact,
                  reverse=True)
关键原则 :找到模式 而不是偶发。一次 git config 缺失是偶然,八次都因为同样原因失败就是模式。
Stage 2:Harness Proposal(修补提议)
针对挖掘出的每个弱点模式,生成 3-5 个候选修改方案。
设计原则四条:
| 原则 | 说明 |
|---|---|
| 针对性 | 每个提案解决特定弱点 |
| 最小化 | 小改动而非大重写 |
| 多样性 | 同一弱点多角度提案 |
| 可测试 | 必须能通过基准任务验证 |
四类提案类型:
python
# 类型1:系统提示词修改
proposal_1 = {
    "type": "system_prompt_modification",
    "change": "Before any git operation, verify git config is set: "
              "run `git config --get user.name && git config --get user.email`. "
              "If unset, set them first."
}

# 类型2:工具包装器添加
def create_file_wrapped(path, content):
    """新增存在性和内容校验"""
    result = create_file(path, content)
    assert os.path.exists(path), f"File creation failed: {path}"
    with open(path) as f:
        actual = f.read()
    assert actual == content, f"Content mismatch in {path}"
    return result

# 类型3:验证步骤注入
proposal_3 = {
    "type": "verification_injection",
    "after": "file_operation",
    "verify": "check_file_exists_and_content_match"
}

# 类型4:规划模板更新
planning_template_v2 = """
Task: {task_description}

State Tracking (NEW):
- Step {n}: {action} → Expected: {expected} → Actual: {actual}
- Precondition checks before each step
- Post-step verification

Plan:
1. ...
"""
Stage 3:Proposal Validation(提案验证)
四条严格接受标准:
python
def validate_proposal(proposal, train_tasks, val_tasks):
    """提案必须同时满足四个条件才被接受"""

    # 1. 无回归破坏 - 之前通过的任务仍必须通过
    baseline_passing = run_baseline(val_tasks)
    new_passing = run_with_proposal(val_tasks, proposal)
    regressions = baseline_passing - new_passing
    if len(regressions) > 0:
        return REJECT, "Regression detected"

    # 2. 净正向收益 - 整体通过率提升
    if len(new_passing) <= len(baseline_passing):
        return REJECT, "No net improvement"

    # 3. 弱点被修复 - 至少一个目标失败转为通过
    target_failures = proposal.target_failures
    fixed = target_failures & new_passing
    if len(fixed) == 0:
        return REJECT, "Target weakness not fixed"

    # 4. 无新故障 - 不引入无关任务的新失败
    new_failures = new_passing.complement() - baseline_passing.complement()
    if len(new_failures) > 0:
        return REJECT, "New unrelated failures"

return ACCEPT数据划分:训练集 70%(62 任务),验证集 30%(27 任务)。
三、实验数据:三个模型 × 三种弱点 × 三种修补
Self-Harness 最有意思的地方不是平均提升数字,而是同一套框架在三个不同模型上挖出了完全不同的弱点。
案例 1:MiniMax M2.5 的 Git 配置缺陷
发现问题:8 个任务因 git user.name / user.email 未配置而失败
失败模式分类:Error Handling Errors
生成提案:系统提示词添加 git 操作前预检规则
验证结果:8 个失败任务全部转通过,零回归
最终影响:+9.0% git 相关任务通过率
修补 Prompt 片段:
text
Before executing any git command, perform the following pre-check:
1. Run: git config --get user.name
2. Run: git config --get user.email
3. If either is empty, set them with:
   - git config user.name "AI Agent"
   - git config user.email "agent@example.com"
4. Only then proceed with the requested git operation.
案例 2:Qwen3.5 的文件验证缺口
发现问题:12 个任务假设文件操作必然成功,未做后置校验
失败模式分类:Verification Gaps
生成提案:为 create_file() 包装器增加存在性 + 内容校验
验证结果:10/12 任务修复,2 个因无关原因仍失败,零回归
最终影响:+11.2% 文件操作任务通过率包装器代码:
python
def create_file_with_verification(path: str, content: str) -> bool:
    """带验证的文件创建包装器"""
    try:
        original_create_file(path, content)
    except Exception as e:
        return False, f"Create failed: {e}"

    # 存在性校验
    if not os.path.exists(path):
        return False, f"File not exist: {path}"

    # 内容校验
    with open(path, 'r') as f:
        actual = f.read()
    if actual != content:
        return False, f"Content mismatch"

    return True, "OK"
案例 3:GLM-5 的多步上下文丢失
发现问题:7 个长任务中段丢失中间状态
失败模式分类:Context Errors
生成提案:规划模板增加显式状态跟踪结构
验证结果:6/7 任务修复,1 个超时无关,零回归
最终影响:+6.7% 多步任务通过率新规划模板:
text
Task: {task_description}

State Snapshot (mandatory, update after each step):
- Current Step: {n}
- Completed Steps: [list with brief results]
- Pending Steps: [list]
- Key Variables: {dict of important state}
- Last Verification: {pass/fail with details}

Action: {next_action}

Pre-condition Check: {what must be true before action}
Post-condition Check: {what must be true after action}
迭代收敛动态
以 MiniMax M2.5 为例的收敛曲线:
迭代0 (基线):  40.5%
迭代1:        45.2%  (+4.7%)
迭代2:        51.8%  (+6.6%)
迭代3:        56.3%  (+4.5%)
迭代4:        59.1%  (+2.8%)
迭代5:        61.2%  (+2.1%)  ← 收益递减开始
迭代6:        61.9%  (+0.7%)
迭代7: 61.9% (+0.0%) ← 完全收敛关键发现:
- 前 3-4 轮贡献了 80% 的增益
- 第 5 轮后进入平台期
- 第 7 轮完全收敛
- 这意味着 5 轮够了,再多花钱没价值
四、关键概念辨析:Harness-Updating vs Harness-Benefit
姊妹论文 arXiv:2605.30621 提出了一个非常重要的概念区分:
| 维度 | Harness-Updating | Harness-Benefit |
|---|---|---|
| 角色定位 | 进化者 (Evolver) | 任务执行者 (Agent) |
| 核心动作 | 生成/更新 harness | 消费/使用已更新 harness |
| 能力曲线 | ⚡ 平坦性 (Flat) ------ 弱模型也能产出优质更新 | 📈 倒 U 型 ------ 中等模型获益最大 |
| 关键发现 | Qwen3.5-9B ≈ Claude Opus 4.6 的更新效果 | 弱 < 中 > 强 |
平坦性的工程含义
更新质量
    ↑
    │  ───────────────────────  ← 几乎所有层级都能做好
    │
    └────────────────────────→ 模型基础能力
       弱      中等      强
💡 含义 :用小/弱模型做进化者即可,不需要昂贵的大模型!
倒 U 型的工程含义
收益程度
    ↑
    │        ╭──────╮
    │       /        \     ← 中等模型获益最大
    │      /          \
    │  ___/            \___
    │ /
    └──────────────────────→ 模型基础能力
弱 中等 强弱模型获益小的两大失败模式:
| 失败模式 | 描述 |
|---|---|
| 无法激活 | 模型未能检索/激活相关 harness 工件 |
| 无法遵循 | 激活了 harness 但未忠实执行指令 |
实践建议(预算分配)
python
# 错误做法:用强模型做进化者
class WrongSetup:
    evolver = ClaudeOpus46()  # $$$ 浪费
    agent = ClaudeOpus46()    # $$$

# 正确做法:进化者用便宜模型
class RightSetup:
    evolver = Qwen35_9B()      # $ 便宜但同样有效
    agent = ClaudeOpus46()      # $$$ 投在执行端

    # 同等预算下,agent 能跑更多任务和迭代
五、与 AgeMem 的互补关系
AgeMem(武汉大学×阿里)和 Self-Harness 都属于"固定参数 LLM 自进化"赛道,但优化层次不同:
| 维度 | AgeMem | Self-Harness |
|---|---|---|
| 优化目标 | 记忆策略(何时写/读/忘) | 整个 Harness 层 |
| 方法 | 三阶段渐进 RL | 三阶段自进化循环 |
| 核心工具 | 6 个记忆工具(Add/Update/Delete/Retrieve/Summary/Filter) | 4 类修补(Prompt/Wrapper/Verify/Plan) |
| 训练 | 需要 RL 训练(GRPO) | 无需训练,纯推理时优化 |
| 数据集 | ALFWorld/SciWorld/HotpotQA 等 5 个 | Terminal-Bench 2.0 |
| 典型提升 | +49.59% (Qwen2.5-7B) | +33%-60% (三个模型) |
双层自进化架构
┌─────────────────────────────────────────┐
│   Layer 1: Self-Harness                 │
│   优化"如何使用模型"                     │
│   - 系统提示词                          │
│   - 工具包装器                          │
│   - 规划模板                            │
│   - 验证逻辑                            │
└────────────────┬────────────────────────┘
                 │
┌────────────────▼────────────────────────┐
│   Layer 2: AgeMem                       │
│   优化"模型记什么、怎么用"               │
│   - LTM (Add/Update/Delete)             │
│   - STM (Retrieve/Summary/Filter)       │
└────────────────┬────────────────────────┘
                 │
┌────────────────▼────────────────────────┐
│   Layer 3: Fixed LLM                    │
│   参数完全冻结                          │
└─────────────────────────────────────────┘核心哲学:智能不完全在模型权重里,也在"使用模型的方式"和"记忆管理的策略"里。
六、So What:三类人的行动清单
🔧 如果你是工程师
1. Harness 优化的 ROI 远高于模型升级
Self-Harness 在三个不同家族模型上都拿到 33%-60% 相对提升。花 50-100 跑一轮 Self-Harness \> 花 5000 换更大模型。
2. 建立"执行轨迹 → 弱点挖掘 → 提案 → 回归测试"的工程化流程
不要再靠手写 Prompt 调优。轨迹日志要结构化采集,回归测试集要早期建立。
python
# 推荐的轨迹日志结构
@dataclass
class ExecutionTrace:
    task_id: str
    timestamp: datetime
    steps: List[Step]
    tool_calls: List[ToolCall]
    errors: List[Error]
    success: bool
    metadata: Dict

@dataclass
class Step:
    step_id: int
    action: str
    expected: Any
    actual: Any
    duration_ms: int
3. 明天就能做 :把 Agent 最近 100 次失败的执行轨迹拉出来,按"工具选择错误/上下文错误/规划错误/错误处理/验证缺失"五个维度归类。出现频率 ≥ 5 次的就是值得修补的弱点。
📊 如果你是技术管理者
1. 建立模型上线时的 Harness 自动适配流程
每接入一个新模型,自动跑一轮 Self-Harness 生成模型专属 Harness。手写 Prompt 不可扩展,自动化自进化可以。
2. 进化者和执行者的预算可以分开
姊妹论文证明弱模型也能产出优质 Harness 更新(与 Claude Opus 4.6 相当),所以进化器用便宜模型,执行器投入大模型,预算花在刀刃上。
3. 明天就能做 :拉一份当前生产 Agent 的 Prompt 库,按模型分桶。同一份 Prompt 跑多个模型?这是反模式------每个模型应该有自己的 Harness。
🚀 如果你是创业者/产品经理
1. Self-Harness 开辟了"模型无关的差异化赛道"
大家都在卷参数量时,你在卷 Harness 质量。同样的开源模型,你的 Agent 就是比竞品更好用、成本还更低。这是真实的产品差异化。
2. 长期运行 Agent 是杀手场景
执行轨迹越多,弱点挖掘越准,Harness 进化越快。一次性任务用不上 Self-Harness,每天跑 1000 次的客服/编程助手才是真正受益者。
3. 明天就能做:选一个高频场景,对比"无 Self-Harness vs 跑过 5 轮 Self-Harness"两个版本的用户成功率。算一下 ROI:如果用户满意度提升 10pp,CAC 能省多少?
七、方法论局限
⚠️ 读者必须知道的方法论缺陷
1. 计算成本高
89 任务 × 2 轮(基线+优化)× 5 迭代 ≈ 890 次运行
按 GPT-4 级别模型估算:单次优化成本 $50-100不是所有团队都付得起这个开销。建议先从高频小任务集开始试水。
2. 初始 Harness 起点低
论文从"极简 Harness"出发:
python
minimal_harness = MinimalHarness(
    model="minimax-m2.5",
    system_prompt="You are an AI agent with access to terminal commands."
)
# 仅包含:
# - 基本角色描述的系统提示
# - 标准工具访问(bash、文件操作、网页搜索)
# - 无模型特定优化
# - 无领域特定指导对已经精调过的生产级 Harness 的叠加效果未验证。
3. 基准过拟合风险
所有实验仅在 Terminal-Bench 2.0 上做,跨任务域(如代码生成、多模态、对话)的泛化能力存疑。
4. 能力天花板
只能修补 Harness 层缺陷,无法突破基座模型的固有能力上限。
                Self-Harness 优化范围
                ←────────────────→
基础能力 ━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━ 顶尖 Agent (ForgeCode/TongAgents)
    ↑                ↑                ↑
   23.8%           38-62%           ~80%
   (基线)        (Self-Harness)    (顶尖手工调优)
                                    ↑
                                与顶尖仍有 18-40pp 差距
5. 贪心策略风险
每次只接受一个最小提案,可能错过"两个改动同时做才有效"的组合优化。
八、复现指南
环境准备
bash
# 1. 克隆代码(论文未明确开源,参考 A-EVO 实验室)
git clone https://github.com/A-EVO-Lab/a-evolve.git
cd a-evolve/harness-evolution

# 2. 安装依赖
pip install -r requirements.txt

# 3. 下载 Terminal-Bench 2.0
git clone https://github.com/laude-institute/terminal-bench
cd terminal-bench && pip install -e .
核心代码框架
python
from self_harness import SelfHarnessOptimizer
from terminal_bench import load_benchmark

# 1. 加载基准任务
tasks = load_benchmark("terminal-bench-2.0")
train_tasks, val_tasks = split_tasks(tasks, ratio=0.7)

# 2. 定义初始极简 Harness
minimal_harness = Harness(
    model="minimax-m2.5",
    system_prompt="You are an AI agent with terminal access.",
    tools=[bash_tool, file_tool, web_search_tool]
)

# 3. 配置 Self-Harness 优化器
optimizer = SelfHarnessOptimizer(
    base_harness=minimal_harness,
    max_iterations=10,
    validation_tasks=val_tasks,
    accept_threshold={
        "no_regression": True,
        "net_positive": True,
        "target_fix": True,
        "no_new_failures": True
    }
)

# 4. 运行自进化
optimized_harness = optimizer.optimize(train_tasks)

# 5. 评估
final_score = evaluate(optimized_harness, val_tasks)
print(f"Baseline: {minimal_harness.score}")
print(f"Optimized: {final_score}")
print(f"Improvement: {(final_score - minimal_harness.score) / minimal_harness.score * 100:.1f}%")
预期复现结果(MiniMax M2.5)
Baseline:  40.5%
Iter 1:    45.2% (+4.7%)
Iter 2:    51.8% (+6.6%)
Iter 3:    56.3% (+4.5%)
Iter 4:    59.1% (+2.8%)
Iter 5:    61.2% (+2.1%)
Iter 6:    61.9% (+0.7%)
Iter 7:    61.9% (+0.0%)  ← 收敛

Final Gain: +21.4pp (+52.8% relative)
九、总结与延伸阅读
核心结论
Self-Harness 证明了:固定能力的 LLM 可以通过系统性自我诊断和 Harness 层优化获得 33%-60% 的相对性能提升。
这为"Agent 差异化来自 Harness 而非仅模型本身"这一新兴范式提供了实证支持。
三个反直觉认知
- 智能不完全在权重里 ------ 模型参数完全冻结,性能仍能持续提升
- 进化者不需要比执行者聪明 ------ 弱模型也能产出优质 Harness 更新
- 更新 ≠ 受益 ------ 能写好 Harness 不等于能用好 Harness
适用场景
✅ 推荐使用:
- 频繁部署新模型的团队
- 大规模运营,手动调优无法扩展
- 多样化任务类型需要差异化优化
- 需要系统化、可复现的改进流程
⚠️ 建议慎用:
- 小规模部署且模型稳定
- 高度领域特定任务
- 严格安全/合规审查需求
- 计算预算有限
延伸阅读
| 类型 | 论文 | 链接 |
|---|---|---|
| 姊妹论文 | Lin et al. (2026) "Harness Updating Is Not Harness Benefit" | arXiv:2605.30621 |
| 互补研究 | AgeMem (武汉大学×阿里) | arXiv:2601.01885 |
| 背景综述 | A Survey on Self-Evolution of LLMs | arXiv:2404.14387 |
| 原文 | Self-Harness: Harnesses That Improve Themselves | arXiv:2606.09498 |
| alphaXiv 解读 | Self-Harness | alphaxiv.org/abs/2606.09498 |
一句话记住
Self-Harness 的核心价值不是"替代人类工程师",而是让 Agent 具备元认知能力------知道自己的弱点在哪里并自行修复。这不是魔法,是工程化了的自我反思。
关于作者
路易乔布斯,AI 战略咨询师 & OpenClaw 创始人,专注 LLM Agent 工程化落地。已发表 30+ 篇 AI 实战文章,覆盖 Agent 架构、Skills 体系、自进化框架等主题。
关注:一深思AI · 每周深度论文精读
版权声明:本文为博主原创文章,基于 arXiv 开放获取论文研读整理。论文引用: