GitHub 项目:github.com/Mininglamp-... ⭐ 欢迎 Star
大语言模型能回答的问题越来越多,但只要你追问一句"这个信息的来源是什么",很多回答就开始经不起推敲了。模型会编造一个看上去合理的引用,或者给出一个早已过时的结论,而它自己对此毫无察觉。这个问题在业界有一个共识性的名字,叫做幻觉(Hallucination);而解决幻觉最主流的工程方案,就是 RAG。
RAG 的基本概念
RAG 全称 Retrieval-Augmented Generation,直译就是"检索增强生成"。它的核心思路并不复杂,可以用一句话概括,即在大模型生成回答之前,先从外部知识库中检索出与当前问题最相关的文档片段,然后将这些片段作为上下文一起喂给模型,让模型基于真实材料来组织答案。
这和人类写论文的过程其实很像,你不会凭记忆把所有参考文献的数据都默写出来,而是先去数据库里查到原文,然后再基于原文来组织你的论述。RAG 让大模型也具备了这种"先查后写"的能力。
大模型的三个结构性短板
要理解 RAG 为什么必要,我们需要先看清楚大模型本身的三个结构性限制。
第一个是知识截止日期。 所有大模型的训练数据都有一个时间终点,模型对训练截止日期之后发生的事情一无所知。GPT-4 的训练数据截止到 2023 年底,Claude 截止到 2025 年初;如果你问它们 2026 年 6 月的事情,它们要么坦白说不知道,要么就开始编造。
第二个是参数容量有限。 即使是千亿参数的大模型,它能"记住"的知识总量也是有限的。训练过程中见过但出现频率很低的信息,模型往往只能模糊记忆;而企业内部的私有数据、最新的行业报告、个人笔记等内容,模型从未见过,自然无法回答。
第三个是缺乏可验证性。 大模型生成答案的过程本质上是概率采样,它输出的每个 token 都是基于概率分布选出来的,没有内置的"事实核查"机制。这意味着模型无法区分自己是在复述训练数据中的事实,还是在基于模式匹配进行推测。
RAG 正是针对这三个短板设计的,它让模型在回答之前先获得最新的、可溯源的外部证据。
RAG 的技术架构
一个标准的 RAG 系统包含三个阶段,分别是索引(Indexing)、检索(Retrieval)和生成(Generation)。
索引阶段负责将原始知识库转化为可高效检索的形式。首先需要对文档进行分块(Chunking),也就是把长文档切分成适合模型上下文窗口的短片段;然后用 Embedding 模型把每个片段转化为高维向量表示;最后将这些向量存入向量数据库(如 FAISS、Milvus、Pinecone 等),建好索引供后续查询。
检索阶段负责根据用户的提问找到最相关的文档片段。用户的问题同样会被 Embedding 模型转化为向量,然后在向量数据库中进行相似度搜索(通常用余弦相似度或内积),返回 Top-K 个最相关的片段。一些高级实现还会加入重排序(Reranking)步骤,用交叉编码器对初步检索结果做精细排序,进一步提升相关性。
生成阶段是将检索到的文档片段和用户的原始问题一起拼接成 prompt,送入大模型生成最终回答。模型此时的任务从"凭记忆回答"变成了"基于给定材料回答",类似一场开卷考试。
Embedding 是怎么工作的
RAG 系统的检索质量很大程度上取决于 Embedding 模型的好坏。Embedding 的作用是把一段文本压缩为一个固定长度的数值向量(通常是 768 维或 1024 维),使得语义相近的文本在向量空间中的距离也相近。
举一个直观的例子,"如何提升代码质量"和"代码怎么写得更好"这两句话虽然字面不同,但一个好的 Embedding 模型会把它们映射到向量空间中非常接近的位置。而"今天天气不错"这句话就会被映射到一个完全不同的区域。
目前常用的 Embedding 模型包括 OpenAI 的 text-embedding-3、BGE 系列、E5 系列等;选择时需要关注的核心指标是模型在 MTEB 榜单上的检索任务得分,而不是简单看参数量。
向量数据库的选型逻辑
向量数据库是 RAG 的存储层。它和传统关系型数据库的区别在于,关系型数据库擅长精确匹配("找出 id=123 的记录"),而向量数据库擅长近似搜索("找出和这段话语义最像的 10 条内容")。
目前主流的向量数据库有几个方向可以选择,FAISS 适合单机高性能场景,Milvus 适合分布式大规模部署,Chroma 适合轻量级原型开发,Pinecone 则是全托管的云服务。选型时需要考虑的因素包括数据规模、查询延迟要求、是否需要持久化、以及团队的运维能力。
Chunking 策略对效果的影响
文档分块看似简单,但分块策略的好坏直接影响检索质量。分块太大会导致引入过多无关信息,稀释了相关内容;分块太小又会丢失上下文,让检索到的片段缺乏可理解性。
常见的分块策略包括固定长度分块(按 token 数切分)、基于语义的分块(在段落或小节边界切分)、以及递归分块(先按大结构切分,再对大块做二次细分)。实际工程中,512 到 1024 个 token 的块大小通常是一个不错的起点,但最终需要根据具体文档类型和下游任务来调整。
RAG vs 微调,什么场景用什么方案
RAG 和微调(Fine-tuning)经常被拿来比较,因为它们都试图让模型"掌握新知识"。但两者的适用场景有明显差异。
RAG 适合知识库内容频繁更新的场景,因为你只需要更新向量数据库中的文档,不需要重新训练模型;RAG 也适合需要提供引用来源的场景,因为检索到的每个片段都可以追溯到原始文档。而微调更适合需要改变模型行为风格或让模型掌握特定领域推理模式的场景,比如让模型学会以特定格式输出结果,或者学会某个专业领域的推理链条。
在实际生产中,两种方法并不互斥;很多团队会先用 RAG 快速上线,积累用户反馈后再考虑是否需要微调来进一步提升特定任务的表现。
本地部署场景下的 RAG
RAG 在云端大模型上的应用已经非常成熟,但对于在边缘设备上运行的本地模型来说,RAG 的价值更加突出。本地模型通常参数量较小(4B 到 8B 是常见区间),它们的"记忆容量"天然有限;同时本地部署的核心诉求往往是数据隐私,即不希望把敏感信息发送到云端。
在这种场景下,RAG 让本地小模型也能借助外部知识库给出高质量的回答,同时所有数据(包括知识库文档和用户查询)都留在本机。这种"本地模型 + 本地 RAG"的组合,是目前兼顾隐私和能力的最佳实践之一。
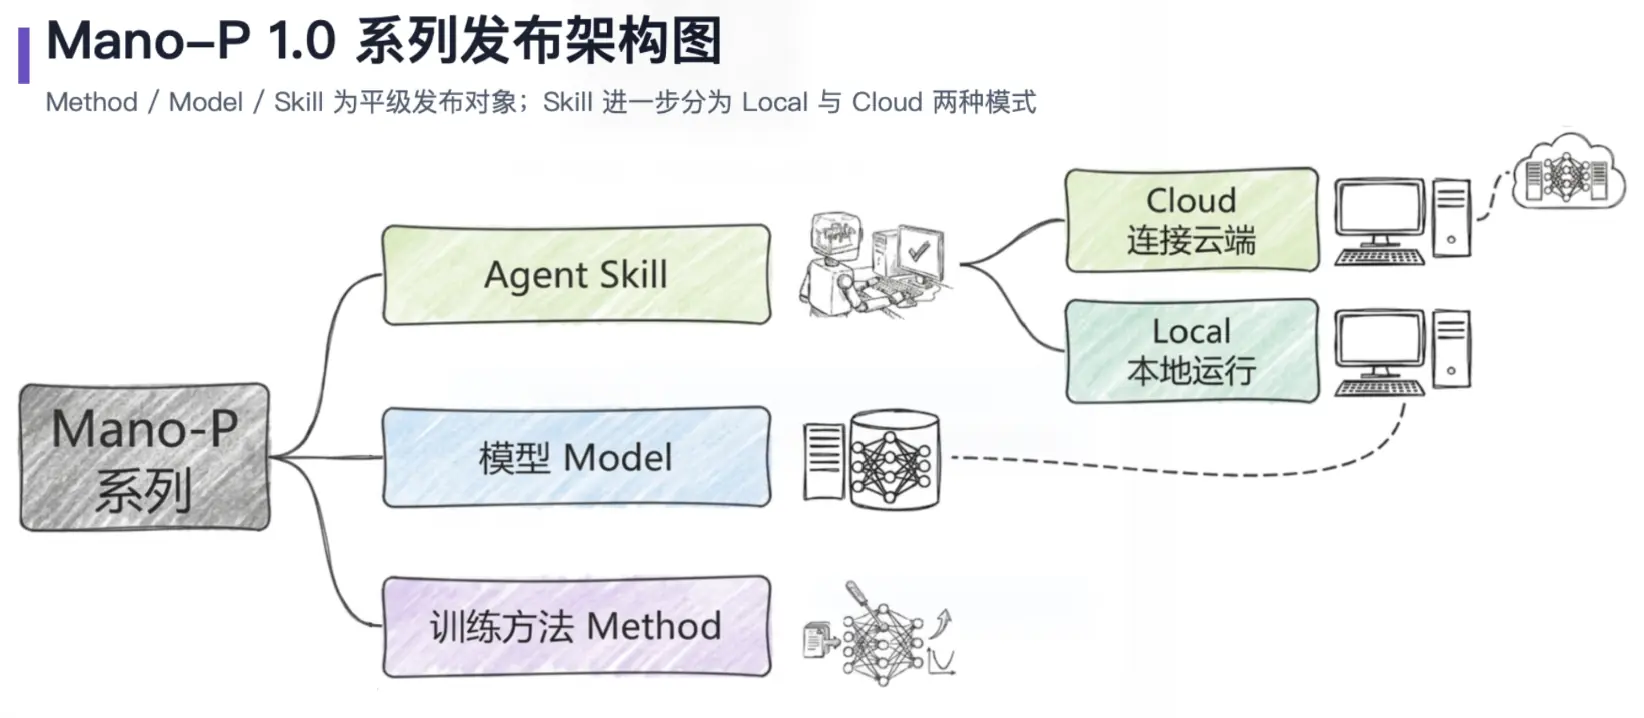
我们团队在边缘端 AI 方向有长期投入,开源项目 Mano-P 是一个面向 Apple Silicon 设备的 GUI 智能体模型,它的 4B 量化版本可以在 Mac mini(M4 芯片 + 32GB 内存)上以约 80 tokens/s 的解码速度本地运行,配合 Cider 推理加速 SDK 的 INT8 激活量化还能获得额外的 1.4x-2.2x prefill 加速。Mano-P 目前在 OSWorld 专项模型评测中以 58.2% 的成功率排名第一,所有推理过程完全在本机执行,截图和任务数据不出设备。如果你在探索本地 AI Agent 的技术路线,这个项目值得关注。
写在最后
RAG 的工程复杂度不高,但做好并不容易。Embedding 模型的选择、分块策略的调优、检索结果的排序和过滤、以及 prompt 模板的设计,每一个环节都会影响最终效果。好消息是这些环节都是可度量的,你可以通过构建评测集来系统性地迭代每个组件。
对于想要动手尝试的开发者,一个快速的起步路径是,用 LangChain 或 LlamaIndex 搭建一个最小可用的 RAG pipeline,先跑通"文档导入→向量化→检索→生成"这条链路,然后在实际使用中逐步优化各个环节。
🔗 本文提及的开源项目
- Mano-P(端侧 GUI 智能体):github.com/Mininglamp-...
- Cider(推理加速 SDK):github.com/Mininglamp-...
如果觉得有帮助,欢迎去 GitHub 点个 Star ⭐