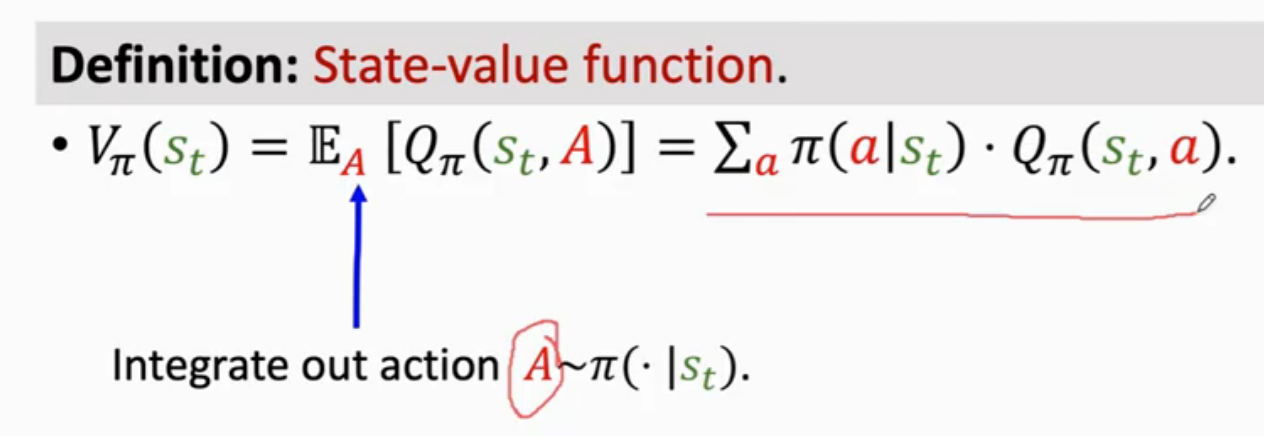
Vπ是Qπ关于动作a的期望。状态价值函数是动作价值函数的期望,评价当前状态和策略网络的好坏,给定状态S,策略网络越好V就越大。
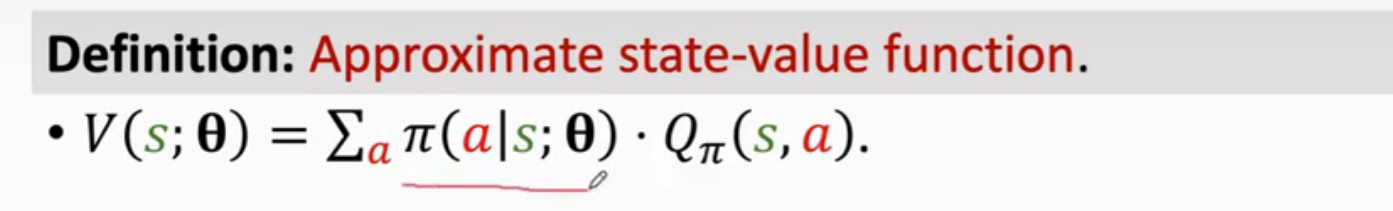
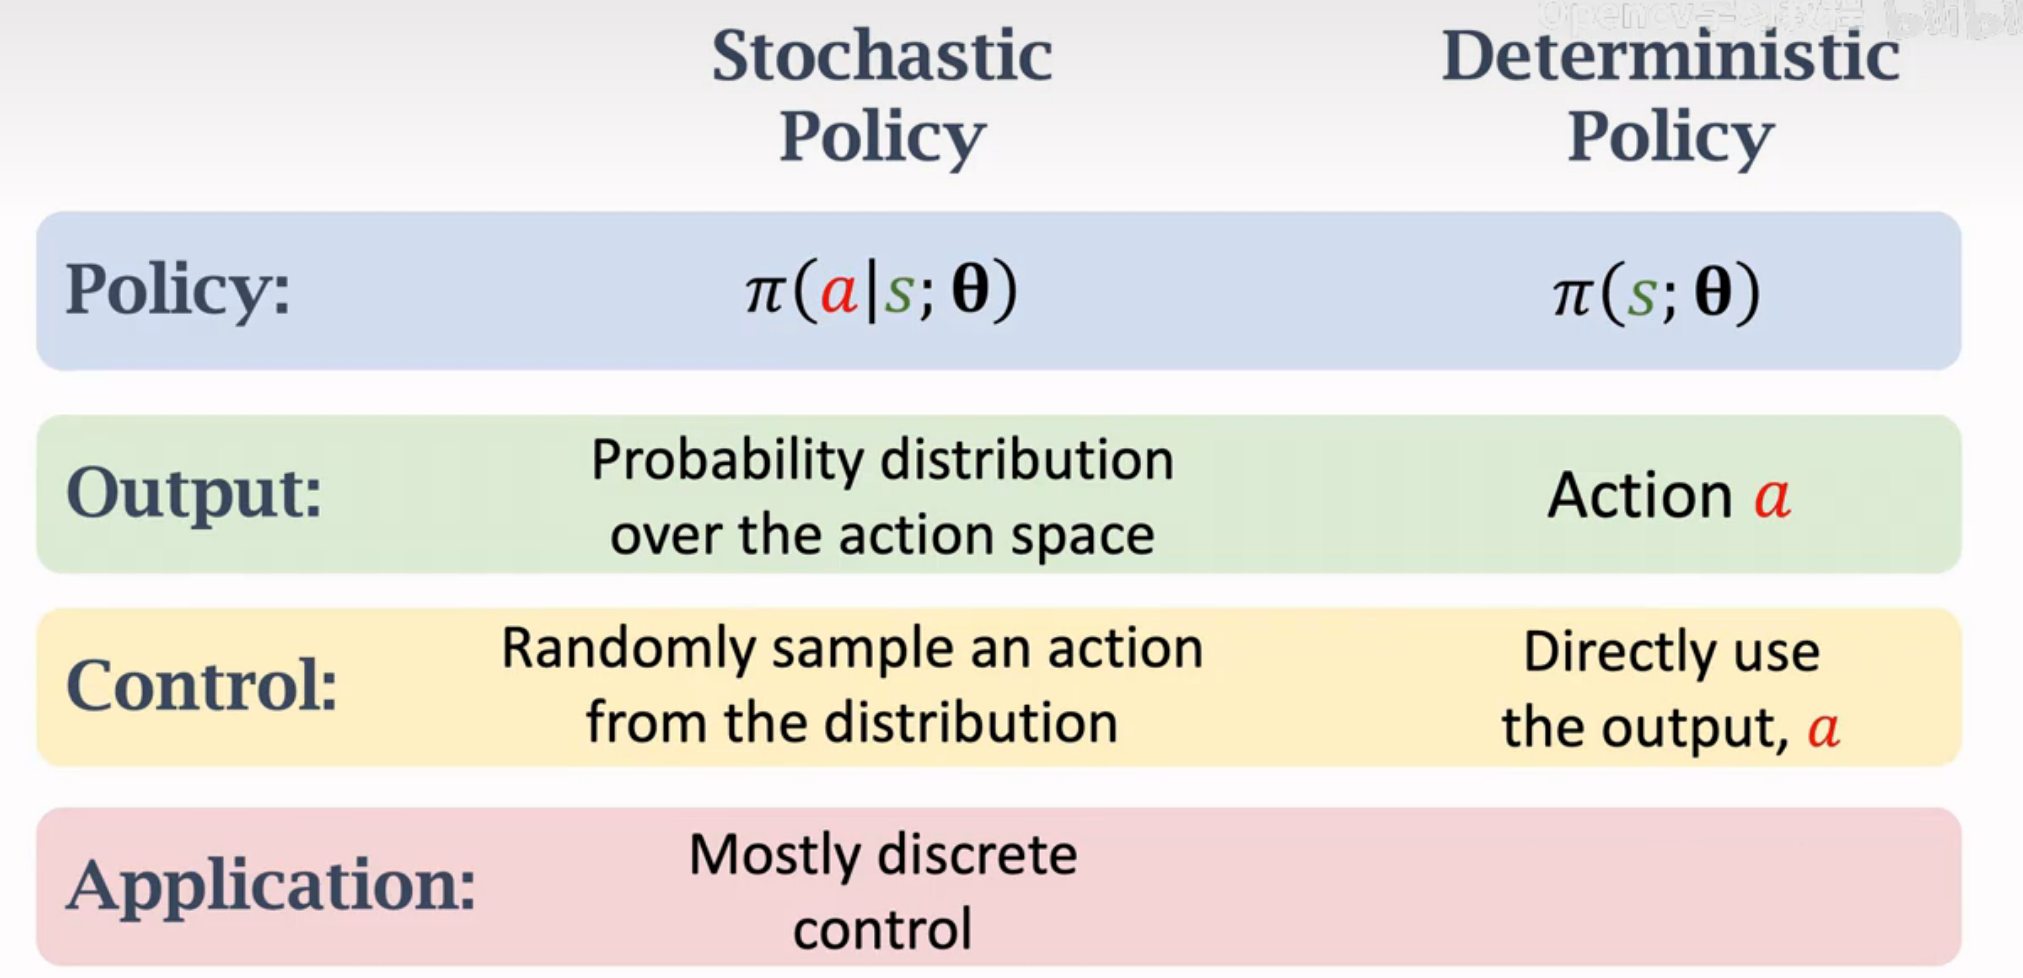
用策略网络来近似策略函数。
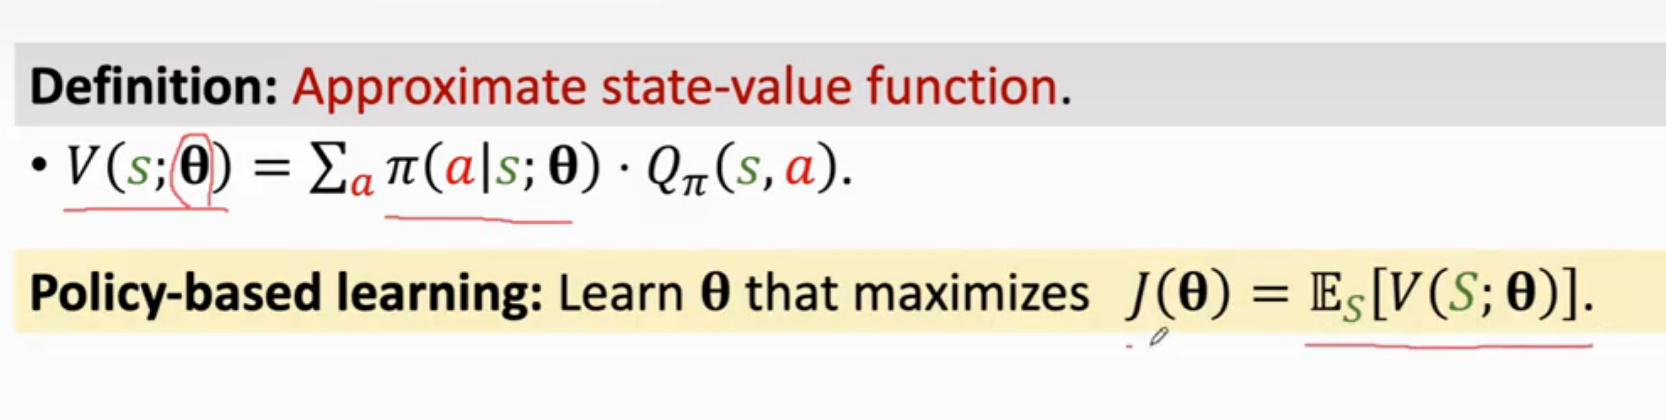
关于状态S求期望,相当于对策略网络做评价。策略梯度就是价值数V关于 的导数
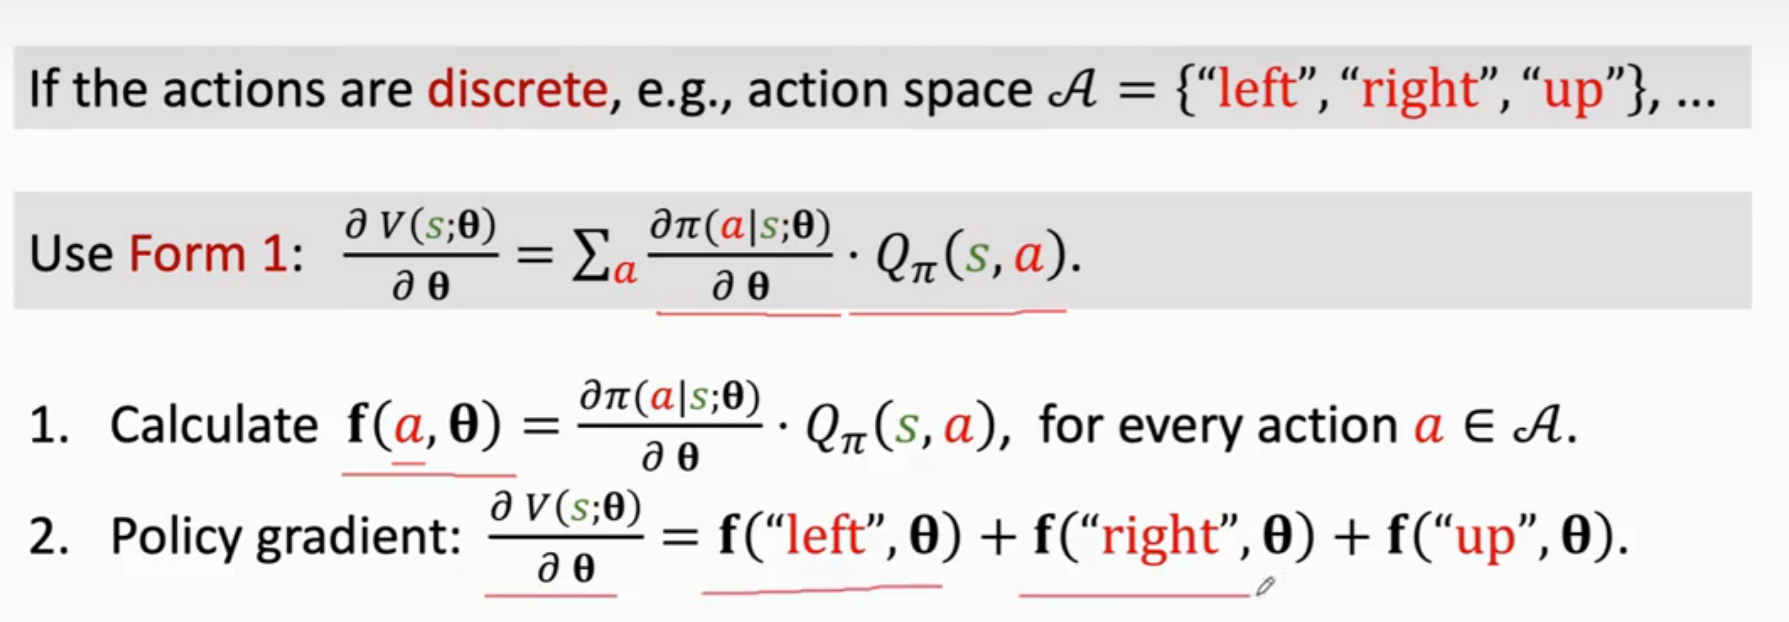
离散情况:
连续情况:
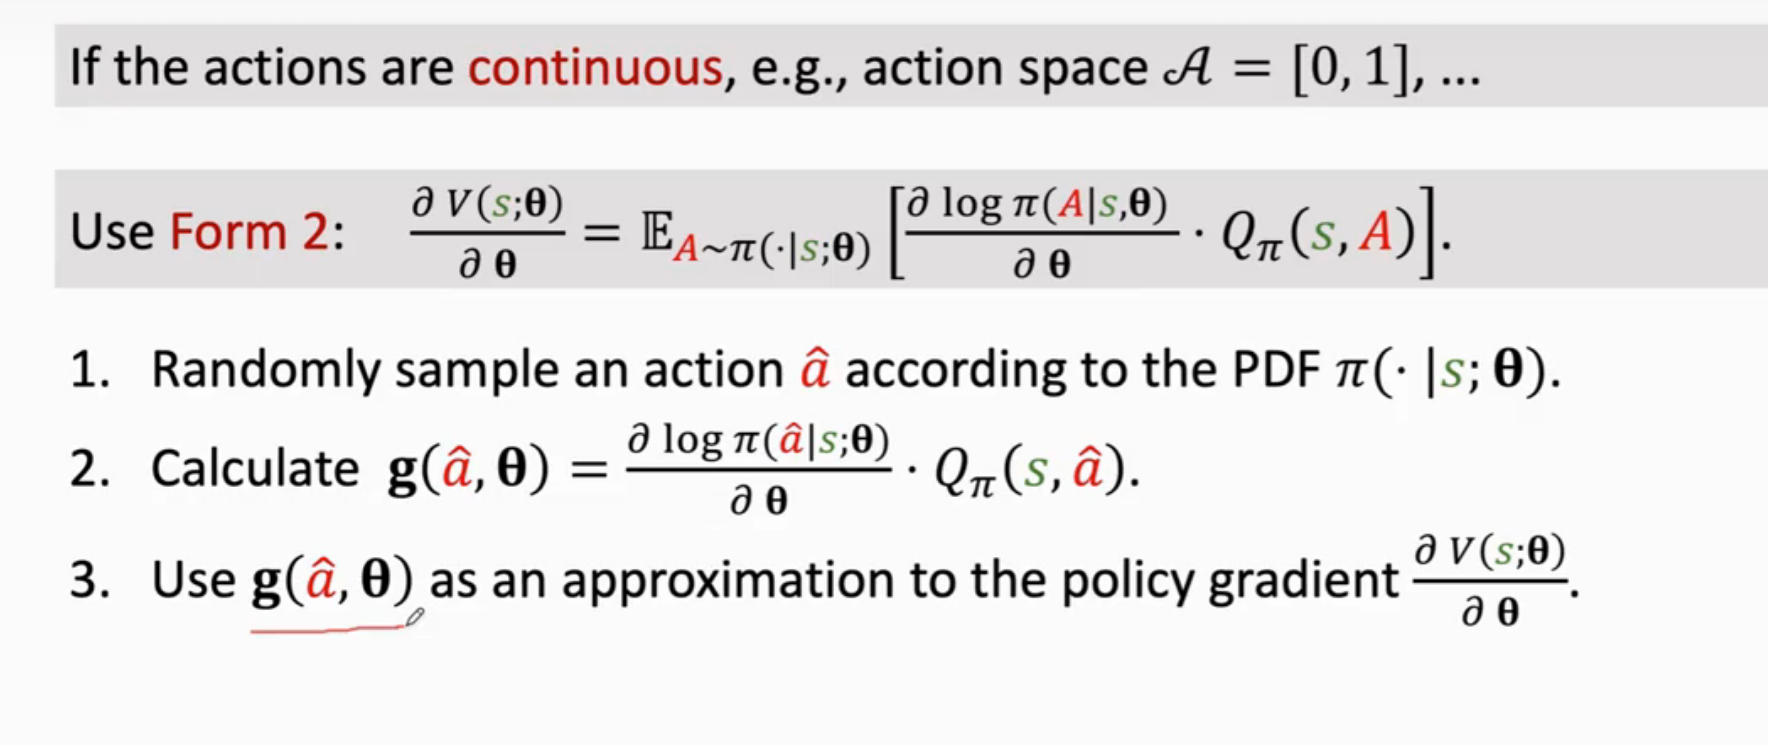
估算目标价值函数:
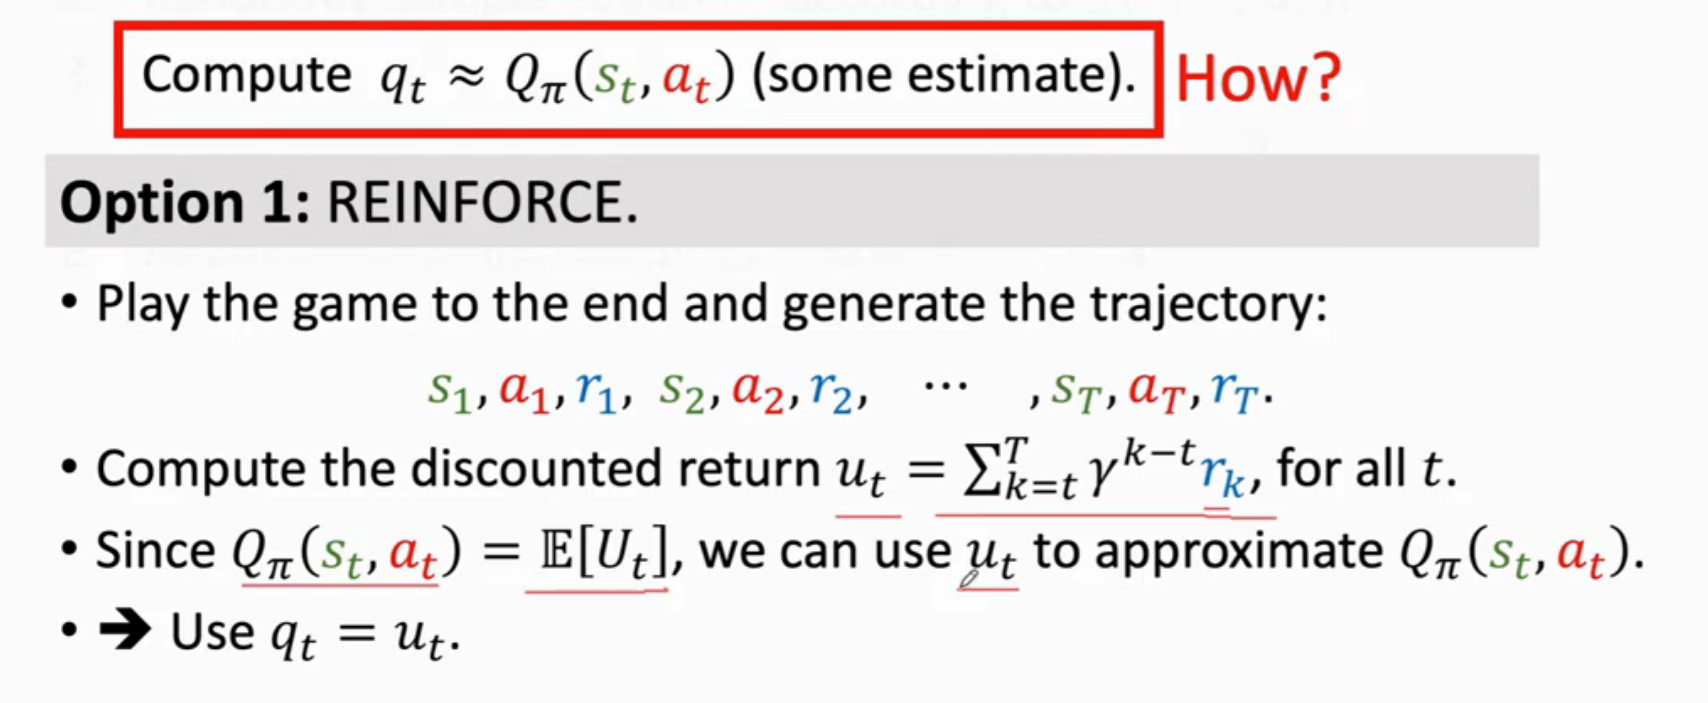
用Ut的观测值ut来近似Qπ,REINFORCE算法就是用观测到的ut来代替动作价值函数,需要玩完整局游戏观测到所有奖励才能更新策略网络
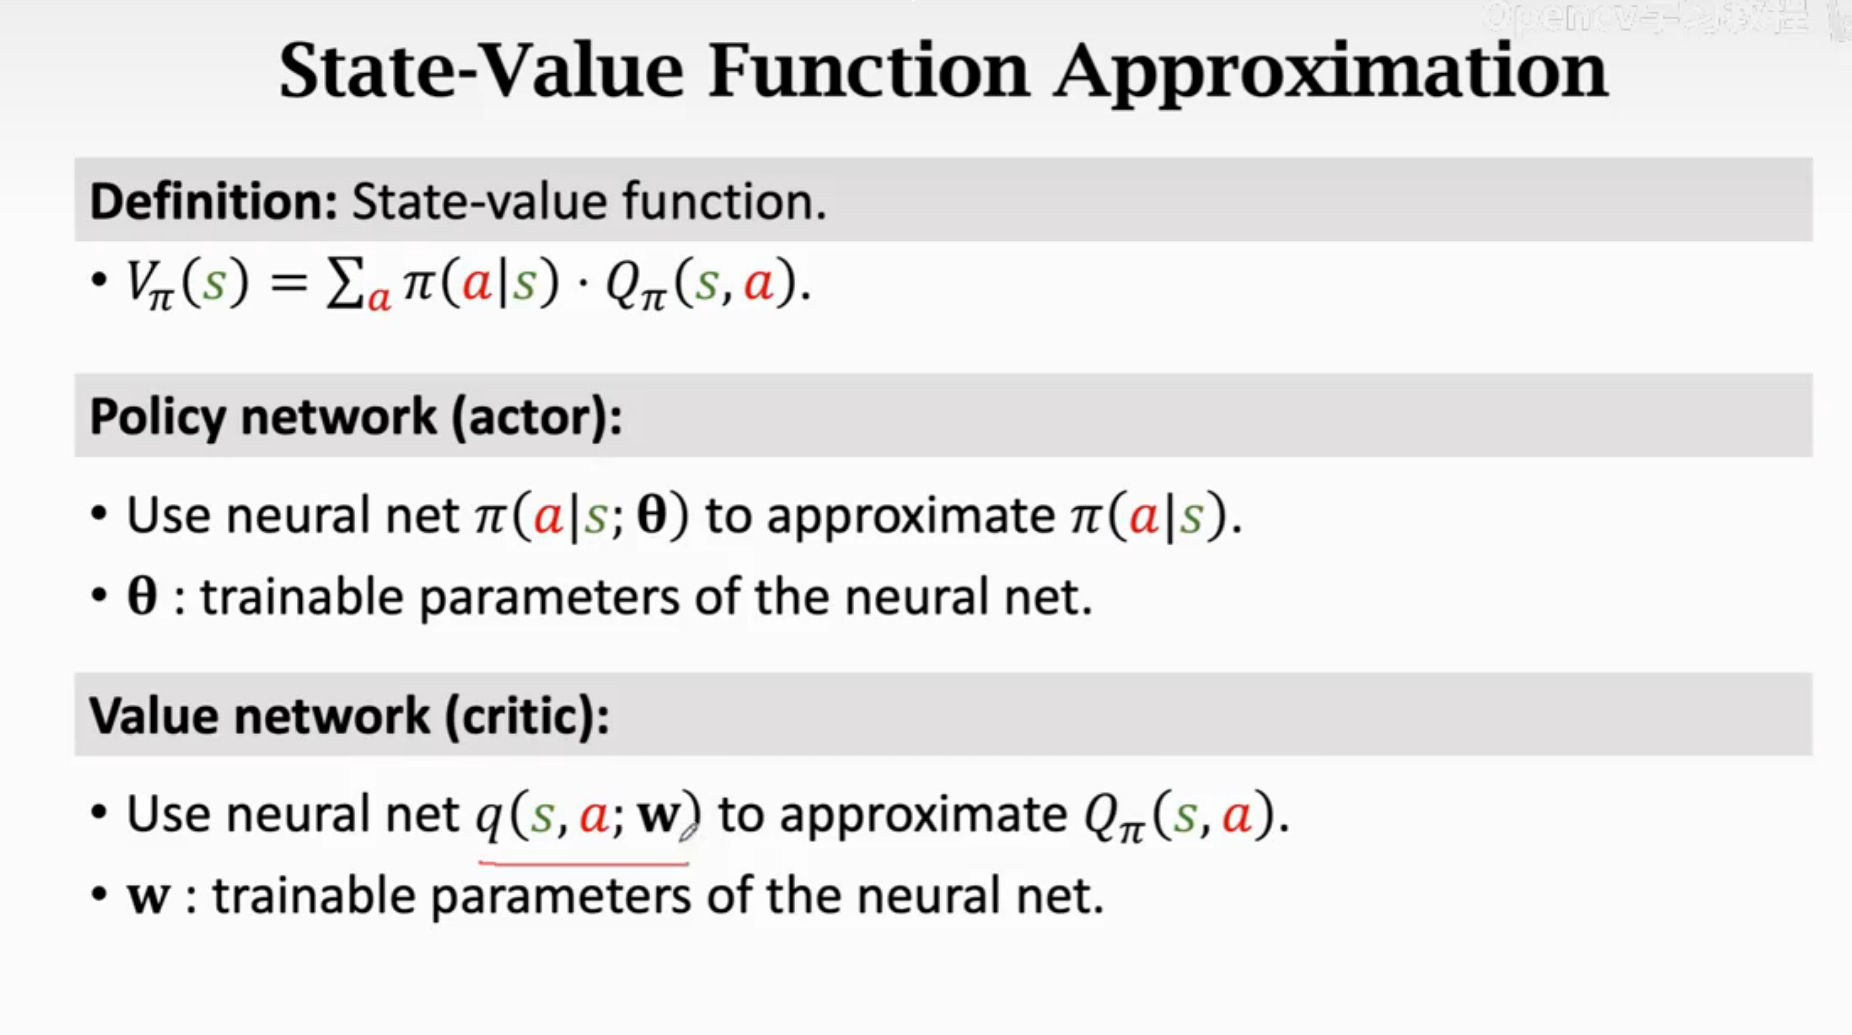
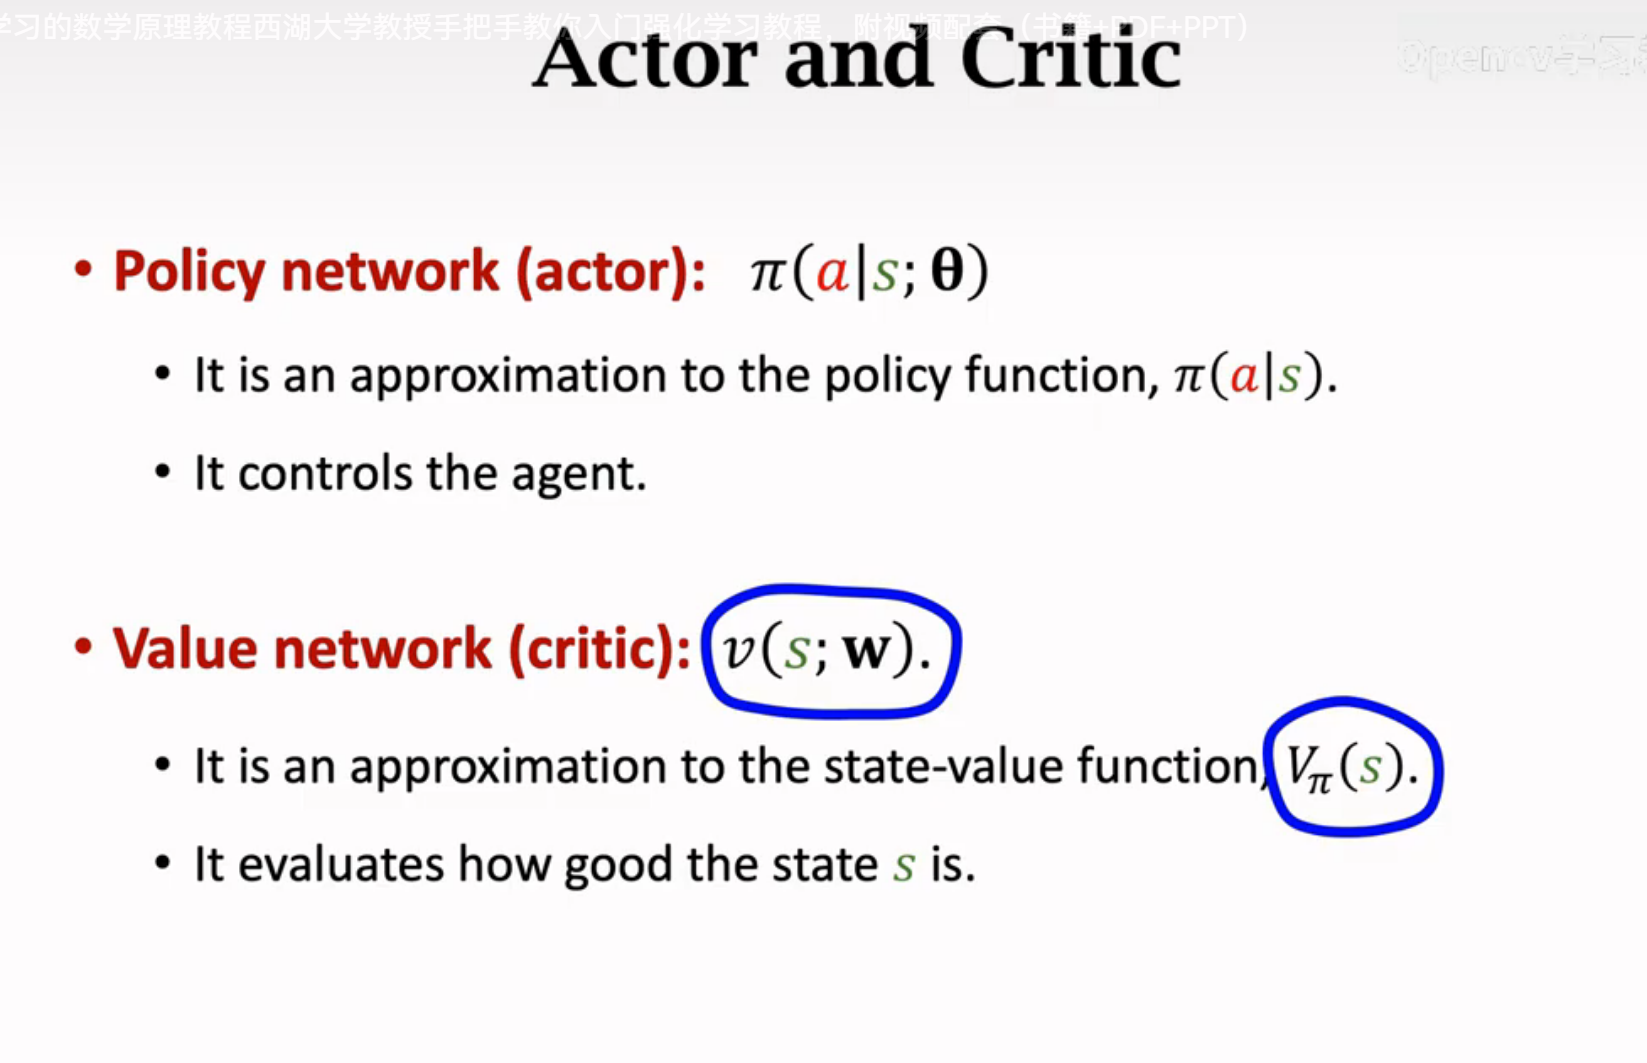
Vπ是Qπ关于动作a的期望。状态价值函数是动作价值函数的期望,评价当前状态和策略网络的好坏,给定状态S,策略网络越好V就越大。
用策略网络来近似策略函数。
关于状态S求期望,相当于对策略网络做评价。策略梯度就是价值数V关于 的导数
估算目标价值函数:
用Ut的观测值ut来近似Qπ,REINFORCE算法就是用观测到的ut来代替动作价值函数,需要玩完整局游戏观测到所有奖励才能更新策略网络