6月10日,韩国科学技术院(KAIST)宣布了一项将深刻影响机器人产业的技术突破。由电气工程系Chang D. Yoo教授领导的研究团队,全球首次开发出名为"VOTP(Video-based Optimal Transport Preference)"的创新技术------仅需数段人类偏好视频,AI即可自主学习人类的判断标准与行为意图,而无需传统方法所需的数千乃至上万条人工标注数据。该研究论文已被机器学习领域顶级会议录用为Oral Presentation,在23,918篇投稿中脱颖而出(前0.7%),标志着国际学术界对这项技术的高度认可。
当前,人工智能正经历从"生成式AI"向"Physical AI"的范式跃迁。所谓Physical AI,是指能够操控实体机械、在物理世界中自主决策与执行任务的智能系统------工业机器人替代人类完成高危作业、自动驾驶汽车自主判断路况、医疗机器人实施精准外科手术,皆属此列。
然而,Physical AI的大规模商业化面临一道核心壁垒:如何让机器理解"什么样的行为更符合人类期望"? 这涉及构建精确的"Reward Function"(奖励函数)------一种能够量化评估AI行为优劣、引导其向正确方向优化的数学模型。传统方法要求人类专家对数千甚至数万条机器人行为数据进行逐一标注与评分,不仅耗费巨大的人力与时间成本,更难以保证标注的一致性与客观性。
KAIST研究团队敏锐地捕捉到这一痛点,提出一个根本性问题:人类是否真的需要逐条标注每一种行为? 事实上,人类在日常生活中往往通过"看视频做选择"的隐式方式表达偏好------我们天然知道哪种烹饪手法更优雅、哪条驾驶路线更安全。这一观察成为VOTP算法的灵感来源。
从"逐条标注"到"偏好视频"的范式转变
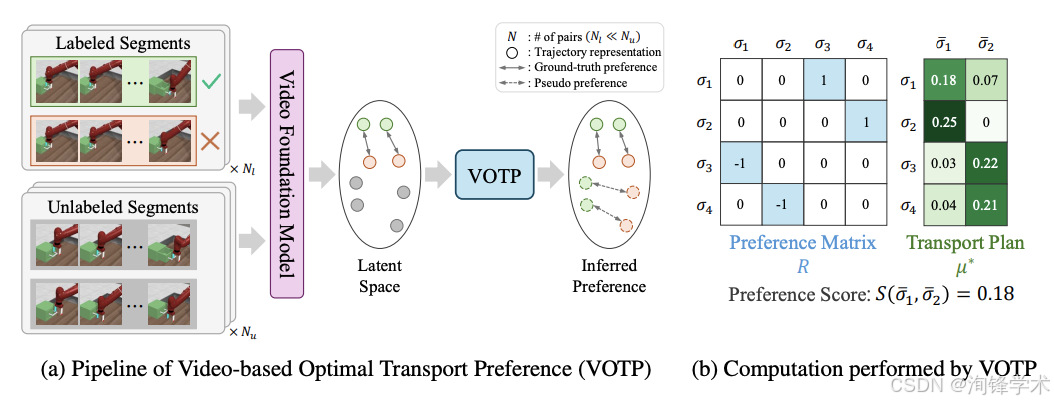
VOTP的核心创新在于其独特的视频偏好学习框架。传统方法中,人类需要观看机器人的每一种可能行为并给出评分;而在VOTP范式下,人类仅需提供少量"我更喜欢这个"的视频示例。算法会自动推断这些视频背后蕴含的隐式偏好标准,并将其迁移到全新的、未见过的任务场景中。
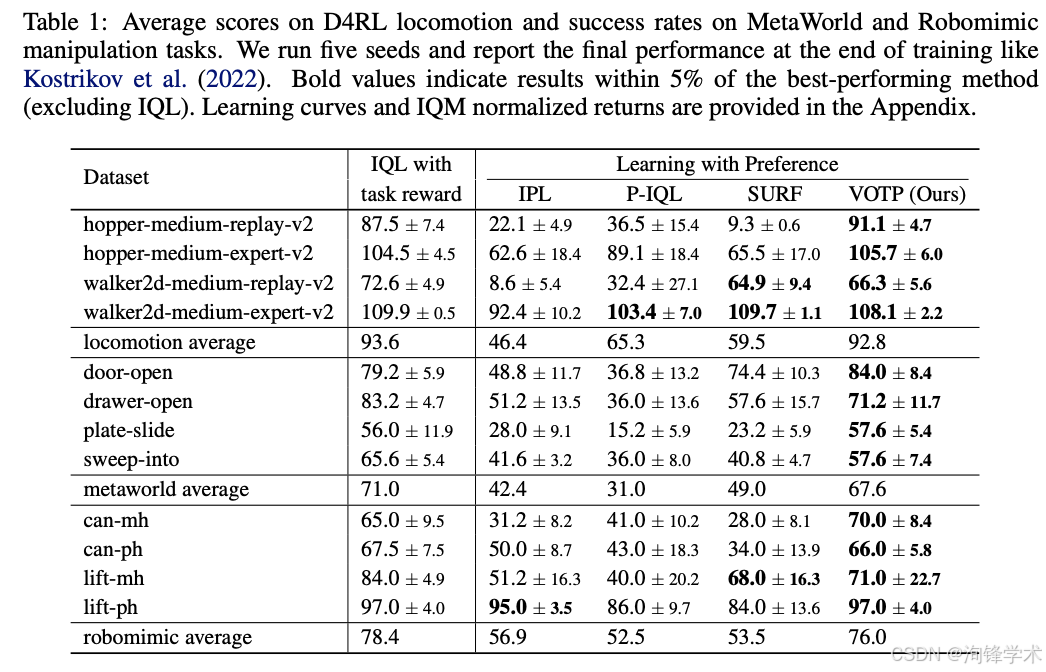
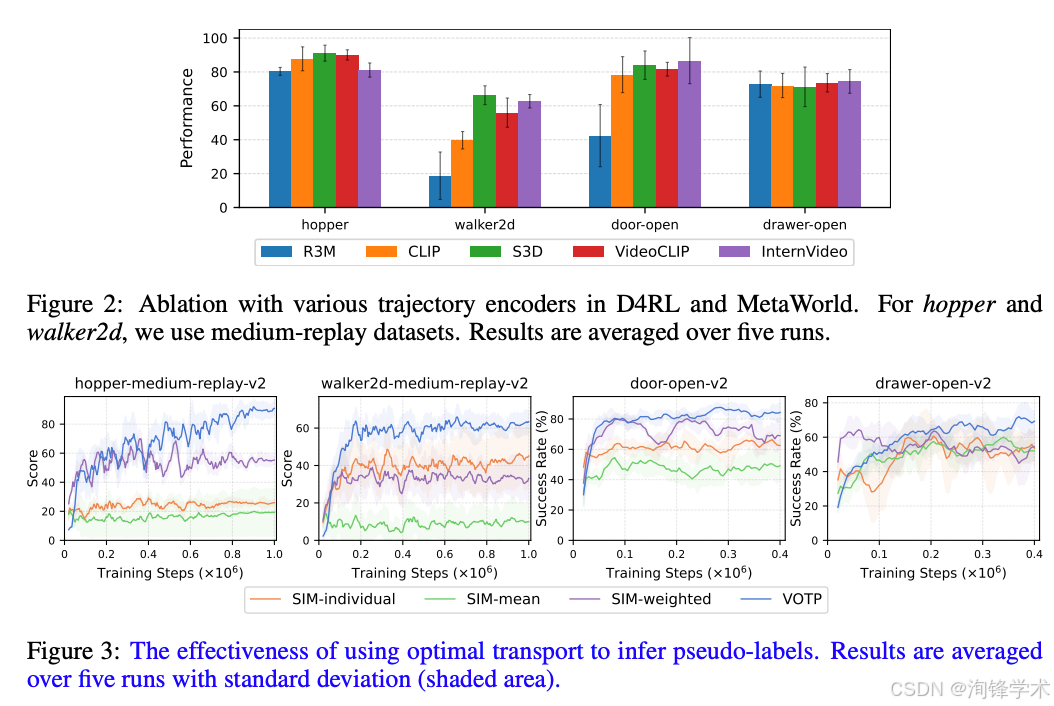
具体而言,VOTP引入最优传输理论(Optimal Transport Theory) 作为数学骨架。最优传输是概率论与微分几何交叉领域的经典工具,其核心思想是衡量两个概率分布之间的"最小搬运成本"。在VOTP中,研究者将人类的偏好视频建模为概率分布,算法通过计算候选行为与偏好视频之间的最优传输距离,量化评估该行为与人类意图的契合程度。
少样本学习:数据效率的质的飞跃
这项技术的另一关键优势在于其卓越的少样本学习能力。据团队披露,VOTP仅需3-5段偏好视频即可完成有效学习,而传统方法通常需要10,000+条标注数据。这意味着:
- 数据采集成本降低99%以上
- 人类专家从繁重的标注工作中解放
- 训练周期从数周缩短至数小时
架构设计:三阶段协同框架
VOTP采用"感知-推理-决策"三阶段架构:
第一阶段:视频编码器
基于对比学习预训练的视觉编码器将偏好视频与候选行为视频映射到统一的语义空间,提取动作特征与运动模式。
第二阶段:传输距离计算
通过可微分的最优传输模块,计算候选行为与人类偏好之间的传输距离。该距离同时考虑动作的内容相似性与风格一致性。
第三阶段:奖励函数生成
将传输距离转化为连续的奖励信号,可无缝对接标准强化学习算法(如PPO、SAC),实现策略优化。
跨任务泛化能力
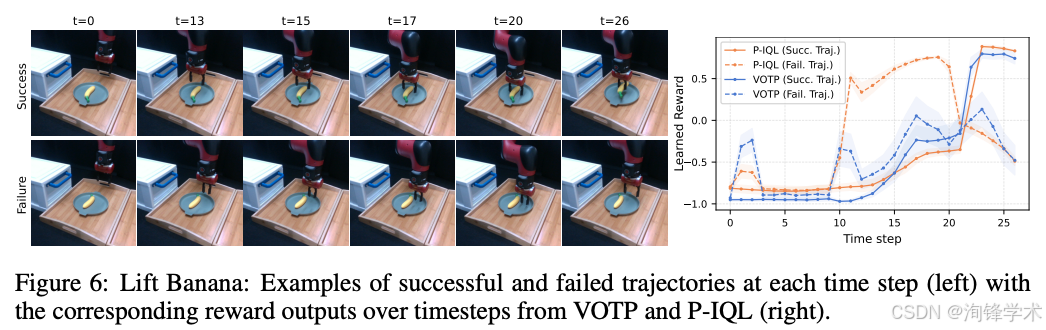
实验表明,VOTP学到的偏好表征具有强大的跨任务迁移能力。在模拟环境中训练得到的偏好模型,可直接应用于物理机器人控制,且无需额外微调。这一特性对于多任务机器人与通用人工智能的发展具有重要意义。
对学术界的启示
VOTP的提出标志着**"人类-in-the-loop"强化学习**研究进入新阶段。它重新定义了人与AI的协作方式------从"人类作为标注者"转变为"人类作为偏好源",大幅降低了人类与机器之间的沟通成本。这一范式与近期Science Robotics发表的"联盟感知机器人基础模型"(Alliances-aware Robotic Foundation Models)遥相呼应,后者同样强调机器人应"与人类共同学习,而非仅为人类服务"。
对产业界的冲击
对于机器人厂商而言,VOTP意味着定制化成本的革命性下降。以手术机器人为例,传统开发流程需要临床专家耗时数月完成偏好标注;而借助VOTP,医生仅需提供数段"理想手术风格"的视频,AI即可快速习得其操作偏好。这将加速个性化医疗机器人的普及。
对于自动驾驶行业,VOTP为人机协同决策提供了新思路。乘客的驾驶风格偏好(如激进/保守)可通过少量视频表达,系统据此动态调整行驶策略,提升乘坐体验与信任感。
生态位与局限
当然,VOTP并非万能。当前研究主要验证于模拟环境与结构化任务,在开放世界、非结构化场景中的表现尚待检验。此外,人类偏好的主观性与多样性意味着算法可能无法处理跨文化、跨个体的显著差异。未来的研究方向可能包括:多模态偏好融合、偏好不确定性建模、以及对抗鲁棒性增强。
KAIST团队的这项工作,不仅是一项技术创新,更是对Physical AI发展路径的深刻反思。当我们谈论"让机器人像人一样思考"时,往往忽视了最关键的一环:机器人能否像人一样理解"什么是好的"? VOTP从人类偏好的本质出发,用最优传输的数学语言重新诠释了这一问题,展现出简洁而深刻的学术品位。
值得关注的是,VOTP与近期Science Robotics刊载的机器人基础模型研究形成了学术共振------无论是"联盟感知"还是"视频偏好",都指向同一个核心命题:下一代机器人必须具备理解、适应并响应人类意图的能力,而非仅仅执行预设指令。 我们有理由期待,随着这类技术的成熟,"懂你"的机器人将从实验室走进千家万户。
版权说明:本文由洵锋学术(SUNFER Academic)编辑团队撰写,数据来源于网络用于学术专业交流