Ultralytics:解读SpatialAttention模块
前言
- 由于本人水平有限,难免出现错漏,敬请批评改正。
- 更多精彩内容,可点击进入Python日常小操作专栏、OpenCV-Python小应用专栏、YOLO系列专栏、自然语言处理专栏、人工智能混合编程实践专栏或我的个人主页查看
- YOLOs-CPP:一个免费开源的YOLO全系列C++推理库(以YOLO26为例)
- PaddleOCR:Win10上安装使用PPOCRLabel标注工具
- 目标检测:使用自己的数据集微调DEIMv2进行物体检测
- 图像分割:PyTorch从零开始实现SegFormer语义分割
- 图像超分:使用自己的数据集微调Real-ESRGAN-x4plus进行超分重建
- 图像生成:PyTorch从零开始实现一个简单的扩散模型
- Stable Diffusion:使用自己的数据集微调 Stable Diffusion 3.5 LoRA 文生图模型
- 图像超分:使用自己的数据集微调Real-ESRGAN-x2plus进行超分重建
- Anomalib:使用Anomalib 2.1.0训练自己的数据集进行异常检测
- Anomalib:在Linux服务器上安装使用Anomalib 2.1.0
- 人工智能混合编程实践:C++调用封装好的DLL进行异常检测推理
- 人工智能混合编程实践:C++调用封装好的DLL进行FP16图像超分重建(v3.0)
- 隔离系统Python:源码编译3.11.8到自定义目录(含PGO性能优化)
- 在线机的Python环境迁移到离线机上
- Nuitka 将 Python 脚本封装为 .pyd 或 .so 文件
- Ultralytics:使用 YOLO11 进行速度估计
- Ultralytics:使用 YOLO11 进行物体追踪
- Ultralytics:使用 YOLO11 进行物体计数
- Ultralytics:使用 YOLO11 进行目标打码
- 人工智能混合编程实践:C++调用Python ONNX进行YOLOv8推理
- 人工智能混合编程实践:C++调用封装好的DLL进行YOLOv8实例分割
- 人工智能混合编程实践:C++调用Python ONNX进行图像超分重建
- 人工智能混合编程实践:C++调用Python AgentOCR进行文本识别
- 通过计算实例简单地理解PatchCore异常检测
- Python将YOLO格式实例分割数据集转换为COCO格式实例分割数据集
- YOLOv8 Ultralytics:使用Ultralytics框架训练RT-DETR实时目标检测模型
- 基于DETR的人脸伪装检测
- YOLOv7训练自己的数据集(口罩检测)
- YOLOv8训练自己的数据集(足球检测)
- YOLOv5:TensorRT加速YOLOv5模型推理
- YOLOv5:IoU、GIoU、DIoU、CIoU、EIoU
- 玩转Jetson Nano(五):TensorRT加速YOLOv5目标检测
- YOLOv5:添加SE、CBAM、CoordAtt、ECA注意力机制
- YOLOv5:yolov5s.yaml配置文件解读、增加小目标检测层
- Python将COCO格式实例分割数据集转换为YOLO格式实例分割数据集
- YOLOv5:使用7.0版本训练自己的实例分割模型(车辆、行人、路标、车道线等实例分割)
- 使用Kaggle GPU资源免费体验Stable Diffusion开源项目
- Stable Diffusion:在服务器上部署使用Stable Diffusion WebUI进行AI绘图(v2.0)
- Stable Diffusion:使用自己的数据集微调训练LoRA模型(v2.0)
相关介绍
Ultralytics 简介
Ultralytics 基于多年的计算机视觉和人工智能基础研究,创建了最先进的 (SOTA) YOLO 模型。我们的模型不断更新性能和灵活性,快速、准确且易于使用。他们擅长对象检测、跟踪、实例分割、语义分割、图像分类和姿势估计任务。
前提条件
- 熟悉Python、Pytorch
实验环境
bash
Package                  Version
------------------------ ------------
Python                   3.11.8
absl-py                  2.4.0
accelerate               1.13.0
annotated-doc            0.0.4
anyio                    4.13.0
calflops                 0.3.2
certifi                  2026.4.22
charset-normalizer       3.4.7
click                    8.3.3
colorama                 0.4.6
contourpy                1.3.3
cycler                   0.12.1
filelock                 3.29.0
flatbuffers              25.12.19
fonttools                4.62.1
fsspec                   2026.4.0
grpcio                   1.80.0
h11                      0.16.0
hf-xet                   1.5.0
httpcore                 1.0.9
httpx                    0.28.1
huggingface_hub          1.14.0
idna                     3.15
Jinja2                   3.1.6
kiwisolver               1.5.0
Markdown                 3.10.2
markdown-it-py           4.2.0
MarkupSafe               3.0.3
matplotlib               3.10.9
mdurl                    0.1.2
ml_dtypes                0.5.0
mpmath                   1.3.0
networkx                 3.6.1
numpy                    1.26.4
nvidia-cublas-cu12       12.8.3.14
nvidia-cuda-cupti-cu12   12.8.57
nvidia-cuda-nvrtc-cu12   12.8.61
nvidia-cuda-runtime-cu12 12.8.57
nvidia-cudnn-cu12        9.7.1.26
nvidia-cufft-cu12        11.3.3.41
nvidia-cufile-cu12       1.13.0.11
nvidia-curand-cu12       10.3.9.55
nvidia-cusolver-cu12     11.7.2.55
nvidia-cusparse-cu12     12.5.7.53
nvidia-cusparselt-cu12   0.6.3
nvidia-nccl-cu12         2.26.2
nvidia-nvjitlink-cu12    12.8.61
nvidia-nvtx-cu12         12.8.55
onnx                     1.19.0
onnxruntime-gpu          1.26.0
onnxslim                 0.1.94
opencv-python            4.6.0.66
packaging                26.2
pillow                   12.2.0
pip                      24.0
polars                   1.40.1
polars-runtime-32        1.40.1
protobuf                 7.34.1
psutil                   7.2.2
pycocotools              2.0.11
Pygments                 2.20.0
pyparsing                3.3.2
python-dateutil          2.9.0.post0
PyYAML                   6.0.3
regex                    2026.5.9
requests                 2.34.1
rich                     15.0.0
safetensors              0.7.0
scipy                    1.16.0
setuptools               65.5.0
shellingham              1.5.4
six                      1.17.0
sympy                    1.14.0
tabulate                 0.10.0
tensorboard              2.20.0
tensorboard-data-server  0.7.2
tokenizers               0.22.2
torch                    2.7.1+cu128
torchaudio               2.7.1+cu128
torchvision              0.22.1+cu128
tqdm                     4.67.3
transformers             5.8.1
triton                   3.3.1
typer                    0.25.1
typing_extensions        4.15.0
ultralytics              8.4.58
ultralytics-thop         2.0.19
urllib3                  2.7.0
Werkzeug                 3.1.8
SpatialAttention(空间注意力模块)
SpatialAttention 是一种轻量级的空间注意力机制,它通过聚合通道维度的统计信息(均值 和 最大值 )生成空间注意力图,从而对特征图的不同空间位置进行加权。该模块源自 CBAM(Convolutional Block Attention Module)中的空间注意力子模块,旨在突出对当前任务重要的空间区域,抑制无关背景。
代码实现
python
import cv2
import math
import torch
import numpy as np
import matplotlib.pyplot as plt
from torch import nn

class SpatialAttention(nn.Module):
    """Spatial-attention module for feature recalibration.

    Applies attention weights to spatial dimensions based on channel statistics.

    Attributes:
        cv1 (nn.Conv2d): Convolution layer for spatial attention.
        act (nn.Sigmoid): Sigmoid activation for attention weights.
    """

    def __init__(self, kernel_size=7):
        """Initialize Spatial-attention module.

        Args:
            kernel_size (int): Size of the convolutional kernel (3 or 7).
        """
        super().__init__()
        assert kernel_size in {3, 7}, "kernel size must be 3 or 7"
        padding = 3 if kernel_size == 7 else 1
        self.cv1 = nn.Conv2d(2, 1, kernel_size, padding=padding, bias=False)
        self.act = nn.Sigmoid()

    def forward(self, x):
        """Apply spatial attention to input tensor.

        Args:
            x (torch.Tensor): Input tensor.

        Returns:
            (torch.Tensor): Spatial-attended output tensor.
        """
        return x * self.act(self.cv1(torch.cat([torch.mean(x, 1, keepdim=True), torch.max(x, 1, keepdim=True)[0]], 1)))
功能
- 空间信息聚合 :对输入特征图
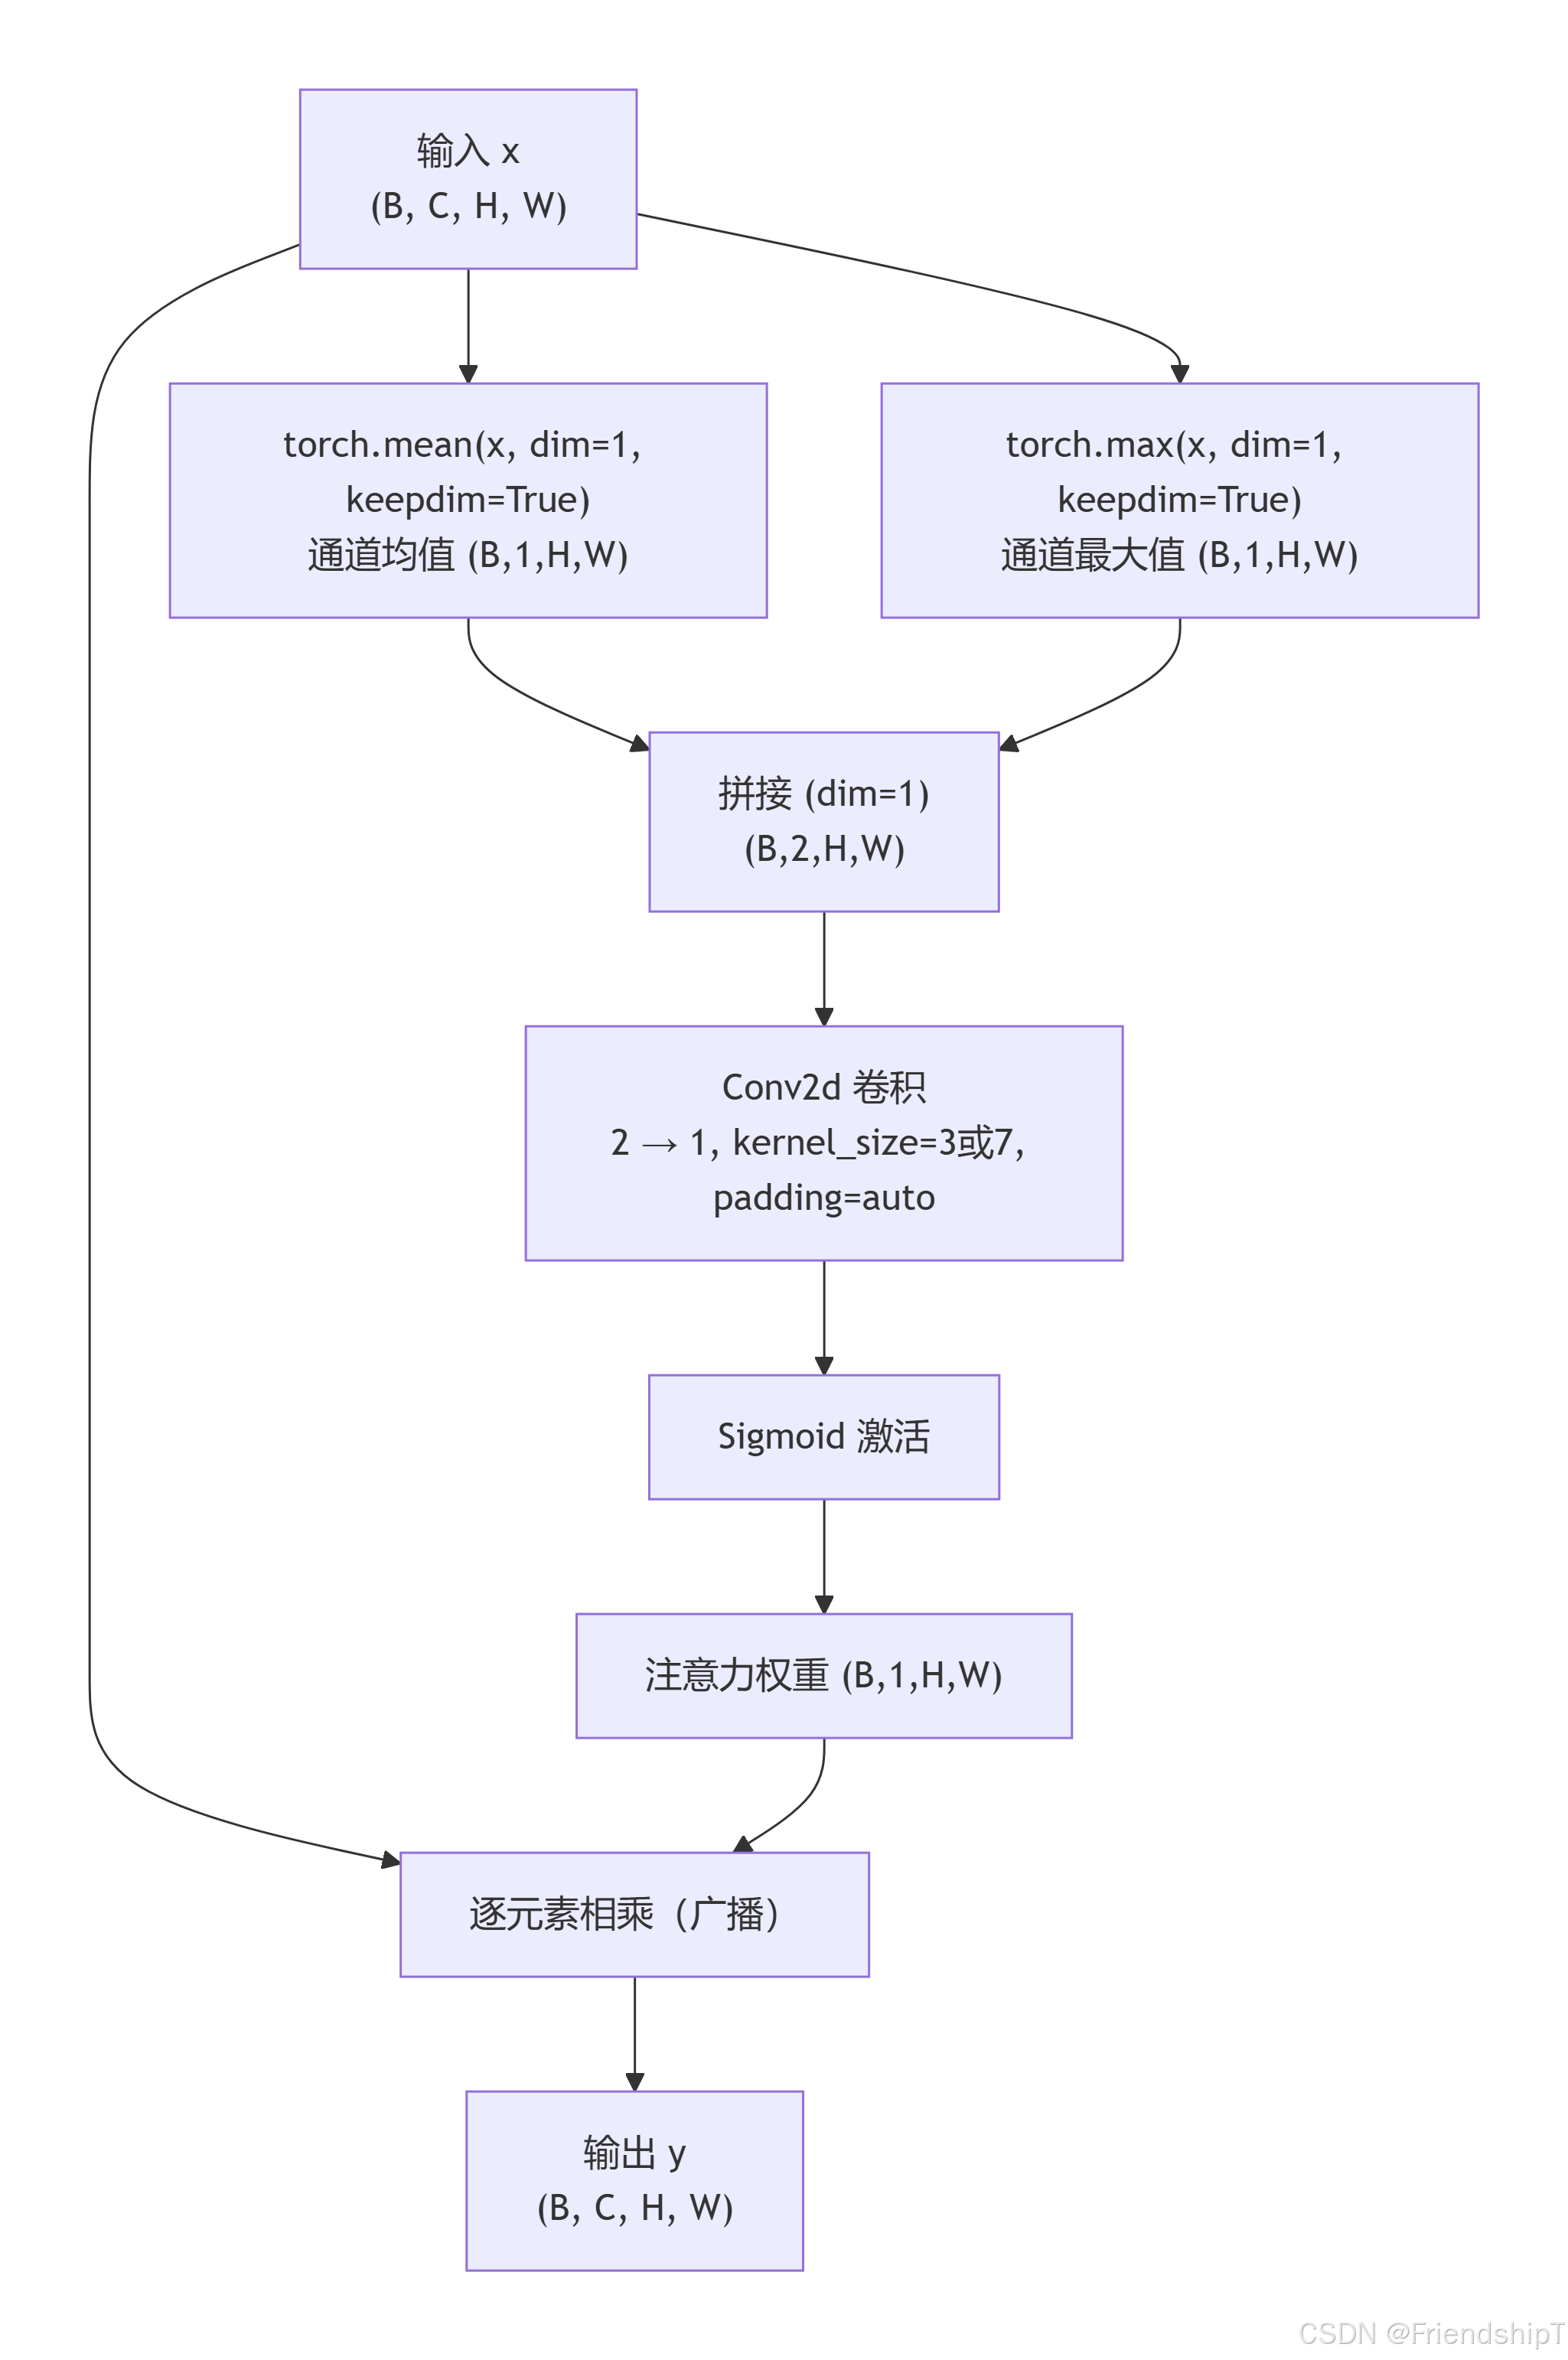
x(形状[B, C, H, W])在通道维度上分别计算 均值 和 最大值 ,得到两个形状为[B, 1, H, W]的特征图,代表每个空间位置的通道统计特性。 - 空间权重生成 :将两个统计特征图在通道维度拼接(
[B, 2, H, W]),通过一个卷积层(核大小可选 3 或 7)生成单通道的空间注意力图,再经过 Sigmoid 激活,将权重映射到(0,1)区间。 - 特征重标定:将生成的注意力权重与原始特征图逐元素相乘(广播到每个通道),突出重要空间区域,抑制不相关区域。
初始化参数
| 参数 | 类型 | 说明 |
|---|---|---|
kernel_size |
int | 卷积核大小,仅支持 3 或 7(默认 7) |
- 核大小 7 通常用于较大感受野,捕捉更广的上下文信息;核大小 3 则更注重局部细节。
- 填充值根据核大小自动设置(核 7 用填充 3,核 3 用填充 1),确保输出空间尺寸与输入一致。
前向方法
forward(x):输入x(形状[B, C, H, W]),输出x * attention,其中attention形状为[B, 1, H, W],经过广播逐元素相乘。
使用示例
python
if __name__ == '__main__':
    torch.manual_seed(42)  # 固定种子,确保每次运行初始化相同
    # 1. 读取图像
    img_path = "cat_640x640.png"
    img_bgr = cv2.imread(img_path)
    if img_bgr is None:
        raise FileNotFoundError(f"图片 {img_path} 不存在!")

    # 2. 转为张量 (1,3,640,640)
    img_rgb = cv2.cvtColor(img_bgr, cv2.COLOR_BGR2RGB)
    img_tensor = torch.from_numpy(img_rgb).float().permute(2, 0, 1).unsqueeze(0)

    # 3. 创建 SpatialAttention 模块(默认核大小7)
    sa = SpatialAttention(kernel_size=7)

    # 4. 前向传播
    with torch.no_grad():
        out = sa(img_tensor)
        # 获取注意力权重(即 self.cv1 输出后的 Sigmoid)
        pooled = torch.cat([torch.mean(img_tensor, 1, keepdim=True),
                            torch.max(img_tensor, 1, keepdim=True)[0]], 1)
        attention = sa.act(sa.cv1(pooled))  # [1, 1, 640, 640]

    print("输出形状:", out.shape)  # torch.Size([1, 3, 640, 640])
    print("注意力图形状:", attention.shape)  # [1, 1, 640, 640]

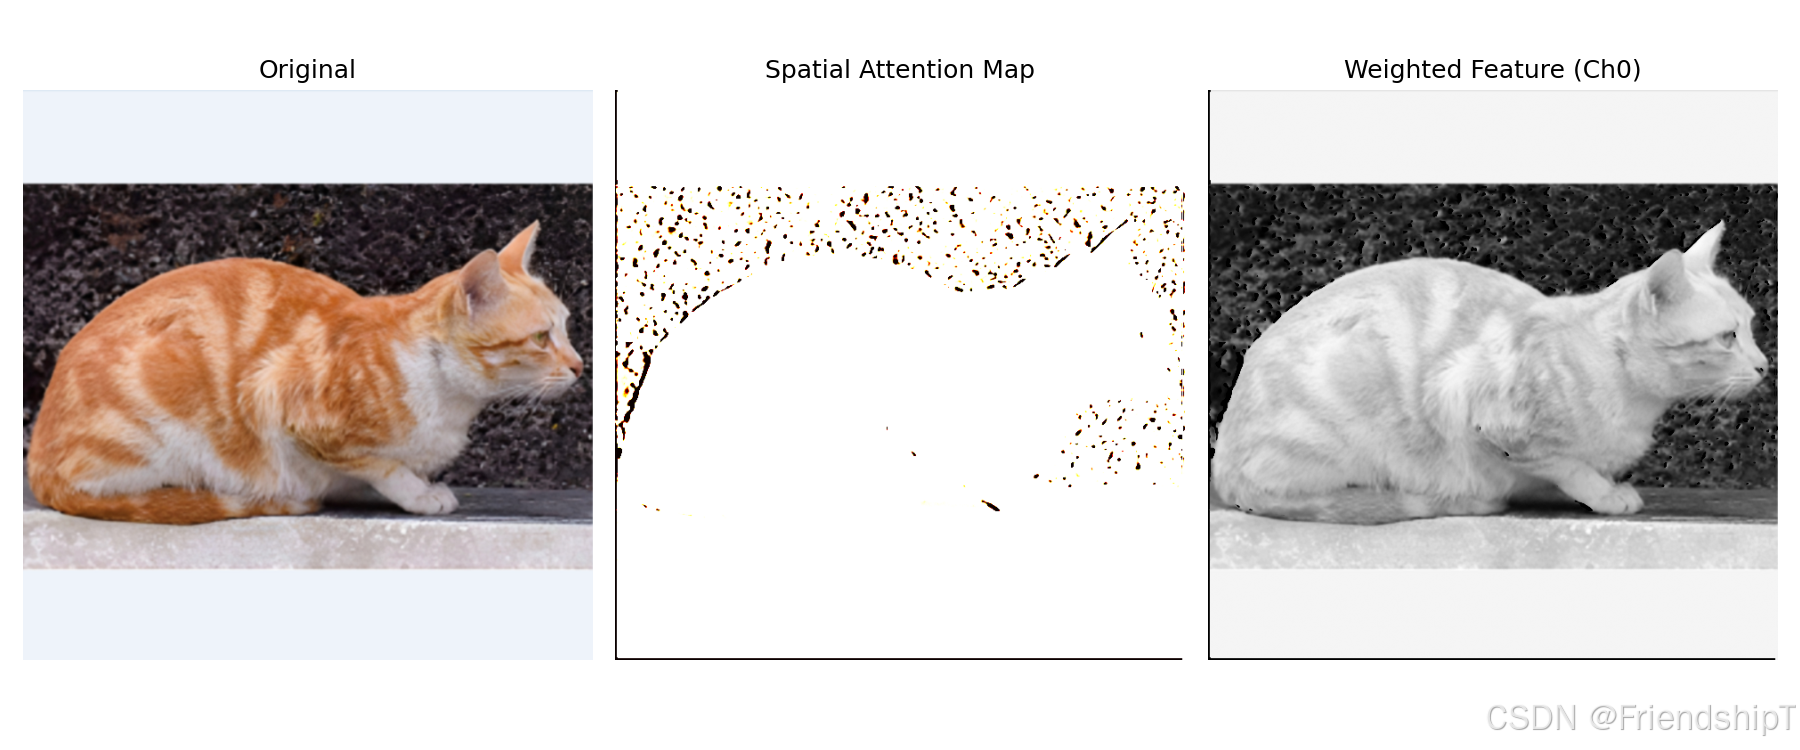
    # 5. 可视化:原图、注意力热力图、加权后的特征图(取第一个通道)
    attn_map = attention[0, 0, :, :].cpu().numpy()
    # 归一化到 [0,1] 便于显示
    attn_map = (attn_map - attn_map.min()) / (attn_map.max() - attn_map.min() + 1e-8)

    # 加权后的输出通道0
    feat_map = out[0, 0, :, :].cpu().numpy()
    feat_map = (feat_map - feat_map.min()) / (feat_map.max() - feat_map.min() + 1e-8)

    plt.figure(figsize=(12, 5))
    plt.subplot(1, 3, 1)
    plt.imshow(cv2.cvtColor(img_bgr, cv2.COLOR_BGR2RGB))
    plt.title("Original")
    plt.axis("off")

    plt.subplot(1, 3, 2)
    plt.imshow(attn_map, cmap='hot')
    plt.title("Spatial Attention Map")
    plt.axis("off")

    plt.subplot(1, 3, 3)
    plt.imshow(feat_map, cmap='gray')
    plt.title("Weighted Feature (Ch0)")
    plt.axis("off")

    plt.tight_layout()
    plt.savefig("spatial_attention_output.png", dpi=150)
    # plt.show()
print("可视化已保存为 spatial_attention_output.png")输出示例:
输出形状: torch.Size([1, 3, 640, 640])
注意力图形状: torch.Size([1, 1, 640, 640])
可视化已保存为 spatial_attention_output.png
流程示意图
代码解读
__init__ 方法
- 核大小限制:仅允许 3 或 7,因为 CBAM 原论文中推荐这两种尺寸,在性能和精度间取得平衡。
- 填充计算 :
padding = 3 if kernel_size == 7 else 1,确保输出尺寸与输入相同。 - 卷积层 :
nn.Conv2d(2, 1, kernel_size, padding=padding, bias=False),输入通道为 2(拼接后的统计图),输出通道为 1,无偏置。 - 激活函数 :
nn.Sigmoid(),将权重映射到(0,1)区间。
forward 方法
torch.mean(x, 1, keepdim=True):在通道维度求均值,输出[B, 1, H, W]。torch.max(x, 1, keepdim=True)[0]:在通道维度求最大值(取第一个返回值,即数值,忽略索引),输出[B, 1, H, W]。torch.cat([...], 1):在通道维拼接,得到[B, 2, H, W]。- 卷积 + Sigmoid 得到空间注意力图。
- 与原图
x逐元素相乘,输出加权后的特征图。
注意事项
- 输入通道数不限:该模块可接受任意通道数的特征图,因为它在通道维度进行聚合(均值和最大值),不依赖于具体通道数。
- 无 BN 和激活:卷积层无偏置且无 BN,可即插即用,适合嵌入现有网络。
- 空间尺寸不变:输出特征图的空间尺寸与输入完全相同,便于跳跃连接或残差结构。
- 核大小的选择:核 7 感受野更大,适合捕捉全局结构;核 3 更注重局部细节。可根据任务和特征图大小调整。
- 与通道注意力的区别:通道注意力关注"哪些通道重要",空间注意力关注"哪些位置重要",二者可互补,组成 CBAM 模块。
优缺点
优点
- 轻量高效 :仅增加一个卷积层(2→1),参数量约为
2 * kernel_size²,计算开销小。 - 即插即用:可插入任何 CNN 层之后,无需修改网络结构。
- 可解释性强:注意力热力图可直观显示模型关注的空间区域,有助于可视化分析。
- 通用性好:适用于分类、检测、分割等多种任务,被大量实验验证有效。
缺点
- 聚合方式单一:仅使用均值和最大值,可能丢失其他统计信息(如方差、中位数),对某些场景不够全面。
- 空间固定:核大小固定,不能自适应调整感受野;对于尺度变化较大的目标,可能不够灵活。
- 与通道注意力组合开销:若同时使用通道和空间注意力(CBAM),会增加一定计算量和显存占用。
- 训练初期易不稳定:由于权重随机初始化,空间注意力图可能噪声较大,需配合适当的正则化。
在 YOLO 等模型中,SpatialAttention 可嵌入骨干网络(如 C2f 之后)或特征金字塔中,以增强模型对空间位置的敏感性。建议在深层特征图使用核大小 7,浅层使用核大小 3,兼顾感受野与细节。
参考文献
1 https://docs.ultralytics.com/
2 https://github.com/ultralytics/ultralytics.git
- 由于本人水平有限,难免出现错漏,敬请批评改正。
- 更多精彩内容,可点击进入Python日常小操作专栏、OpenCV-Python小应用专栏、YOLO系列专栏、自然语言处理专栏、人工智能混合编程实践专栏或我的个人主页查看
- YOLOs-CPP:一个免费开源的YOLO全系列C++推理库(以YOLO26为例)
- PaddleOCR:Win10上安装使用PPOCRLabel标注工具
- 目标检测:使用自己的数据集微调DEIMv2进行物体检测
- 图像分割:PyTorch从零开始实现SegFormer语义分割
- 图像超分:使用自己的数据集微调Real-ESRGAN-x4plus进行超分重建
- 图像生成:PyTorch从零开始实现一个简单的扩散模型
- Stable Diffusion:使用自己的数据集微调 Stable Diffusion 3.5 LoRA 文生图模型
- 图像超分:使用自己的数据集微调Real-ESRGAN-x2plus进行超分重建
- Anomalib:使用Anomalib 2.1.0训练自己的数据集进行异常检测
- Anomalib:在Linux服务器上安装使用Anomalib 2.1.0
- 人工智能混合编程实践:C++调用封装好的DLL进行异常检测推理
- 人工智能混合编程实践:C++调用封装好的DLL进行FP16图像超分重建(v3.0)
- 隔离系统Python:源码编译3.11.8到自定义目录(含PGO性能优化)
- 在线机的Python环境迁移到离线机上
- Nuitka 将 Python 脚本封装为 .pyd 或 .so 文件
- Ultralytics:使用 YOLO11 进行速度估计
- Ultralytics:使用 YOLO11 进行物体追踪
- Ultralytics:使用 YOLO11 进行物体计数
- Ultralytics:使用 YOLO11 进行目标打码
- 人工智能混合编程实践:C++调用Python ONNX进行YOLOv8推理
- 人工智能混合编程实践:C++调用封装好的DLL进行YOLOv8实例分割
- 人工智能混合编程实践:C++调用Python ONNX进行图像超分重建
- 人工智能混合编程实践:C++调用Python AgentOCR进行文本识别
- 通过计算实例简单地理解PatchCore异常检测
- Python将YOLO格式实例分割数据集转换为COCO格式实例分割数据集
- YOLOv8 Ultralytics:使用Ultralytics框架训练RT-DETR实时目标检测模型
- 基于DETR的人脸伪装检测
- YOLOv7训练自己的数据集(口罩检测)
- YOLOv8训练自己的数据集(足球检测)
- YOLOv5:TensorRT加速YOLOv5模型推理
- YOLOv5:IoU、GIoU、DIoU、CIoU、EIoU
- 玩转Jetson Nano(五):TensorRT加速YOLOv5目标检测
- YOLOv5:添加SE、CBAM、CoordAtt、ECA注意力机制
- YOLOv5:yolov5s.yaml配置文件解读、增加小目标检测层
- Python将COCO格式实例分割数据集转换为YOLO格式实例分割数据集
- YOLOv5:使用7.0版本训练自己的实例分割模型(车辆、行人、路标、车道线等实例分割)
- 使用Kaggle GPU资源免费体验Stable Diffusion开源项目
- Stable Diffusion:在服务器上部署使用Stable Diffusion WebUI进行AI绘图(v2.0)
- Stable Diffusion:使用自己的数据集微调训练LoRA模型(v2.0)