目录
- [1. 引言](#1. 引言)
- [2. 什么是参数高效微调(PEFT)](#2. 什么是参数高效微调(PEFT))
- [3. PEFT 的主要作用与优势](#3. PEFT 的主要作用与优势)
- [4. PEFT 的实现类型](#4. PEFT 的实现类型)
- [4.1 选择性微调(Selective)](#4.1 选择性微调(Selective))
- [4.2 基于额外模块的方法(Additive)](#4.2 基于额外模块的方法(Additive))
- [4.3 基于重参数化的方法(Reparameterization‑based)](#4.3 基于重参数化的方法(Reparameterization‑based))
- [5. 如何选择适合的 PEFT 方法](#5. 如何选择适合的 PEFT 方法)
- [6. 实战:使用 Hugging Face PEFT 微调大模型](#6. 实战:使用 Hugging Face PEFT 微调大模型)
1. 引言
近年来,大规模预训练语言模型(LLM)如 GPT‑4、LLaMA、Bloom 等,通过海量无标注数据习得了丰富的语言知识,并在诸多自然语言处理任务上展现出惊人的能力。然而,"预训练 + 全量微调"的传统范式正面临一个严峻的现实:模型规模以指数级增长,全量微调所需的内存、算力和时间成本已远超绝大多数研究团队和个人开发者的承受范围。对于一个 65B 参数的模型,即使使用混合精度训练,也需要数百 GB 的显存,这几乎封锁了普通用户对其进行自定义适配的可能。
正是这一困境催生了**参数高效微调(Parameter‑Efficient Fine‑Tuning,简称 PEFT)**的研究热潮。PEFT 的核心思想是:在保持预训练模型主体参数冻结的前提下,只引入极少量的可训练参数或对模型进行极轻量的修改,从而以极低的资源开销将模型适配到下游任务。这不仅大幅降低了显存和存储需求,还避免了灾难性遗忘,使得"一人一模型"或"一任务一插件"式的敏捷部署成为现实。
本文将基于 Hugging Face 官方 PEFT 生态[1](#1) 的风格和设计思路,系统梳理 PEFT 的内涵、作用、实现类型,并给出一个端到端的实战案例。无论你是正在寻找低成本微调方案的研究者,还是想在自己的应用中嵌入大模型能力的工程师,都能从中获得清晰的认知。
2. 什么是参数高效微调(PEFT)
参数高效微调是一类方法的统称,它允许我们在不更新全部预训练参数的情况下,将大模型适应到新的任务或领域。与传统的全量微调(Full Fine‑Tuning)相比,PEFT 最显著的特征是可训练参数量占比极低------通常仅占模型总参数的 0.1% ~ 3%,却能在许多任务上达到与全量微调相当甚至更优的效果。
举个直观的例子:全量微调 LLaMA‑7B 需要约 56 GB 显存才能加载模型参数并计算梯度;而使用 LoRA(低秩适配)方法,可训练参数可能只有几十 MB,显存需求可降至 20 GB 以下。这意味着在一块消费级 GPU(如 RTX 3090)上,开发者就能对几十亿参数的模型进行定制。
PEFT 方法通常遵循以下设计准则:
- 最小化可训练参数:只添加或修改极小部分权重,主体模型保持冻结。
- 模块化与可组合:不同任务的参数可以像插件一样存储和加载,互不干扰,便于版本管理和快速切换。
- 性能近乎无损:在多数 NLP 任务上,性能与全量微调持平甚至更优,且对原始知识的遗忘程度更低。
这一理念由诸如 Adapters、Prefix‑Tuning、Prompt‑Tuning、LoRA 等方法共同推动,并已被 Hugging Face 统一封装到 PEFT 库中,形成了丰富的工具链。
3. PEFT 的主要作用与优势
PEFT 带来的价值远不止"省显存"这么简单,它深刻改变了我们使用大模型的方式:
-
极低的训练成本
可训练参数往往只有几十万到几千万量级,在单卡 GPU 上即可完成微调,使大模型的平民化成为可能。
-
避免灾难性遗忘
冻结原始参数,仅通过附加结构学习任务相关知识,极大程度保留了预训练阶段习得的通用语言能力,在持续学习场景下优势明显。
-
灵活的模型部署与分享
PEFT 插件(如 LoRA 权重)体积小巧(几 MB 到几十 MB),可独立于基础模型分发。开发者只需一份原始模型,再根据需要挂载不同的 PEFT 模块,就能同时服务多个下游任务。
-
提升分布式训练效率
由于大部分参数无需通信梯度,减少了分布式环境下的同步开销,特别是在多机多卡的场景下能显著加速训练。
-
支持联邦学习和隐私保护
客户端只需上传 PEFT 模块而不是完整模型,降低了数据传输带宽,也更利于隐私保护。
正是因为这些实打实的工程收益,PEFT 已成为当前大模型应用落地的核心技术之一,被广泛应用于问答系统、文本分类、代码生成、指令跟随微调等场景。
4. PEFT 的实现类型
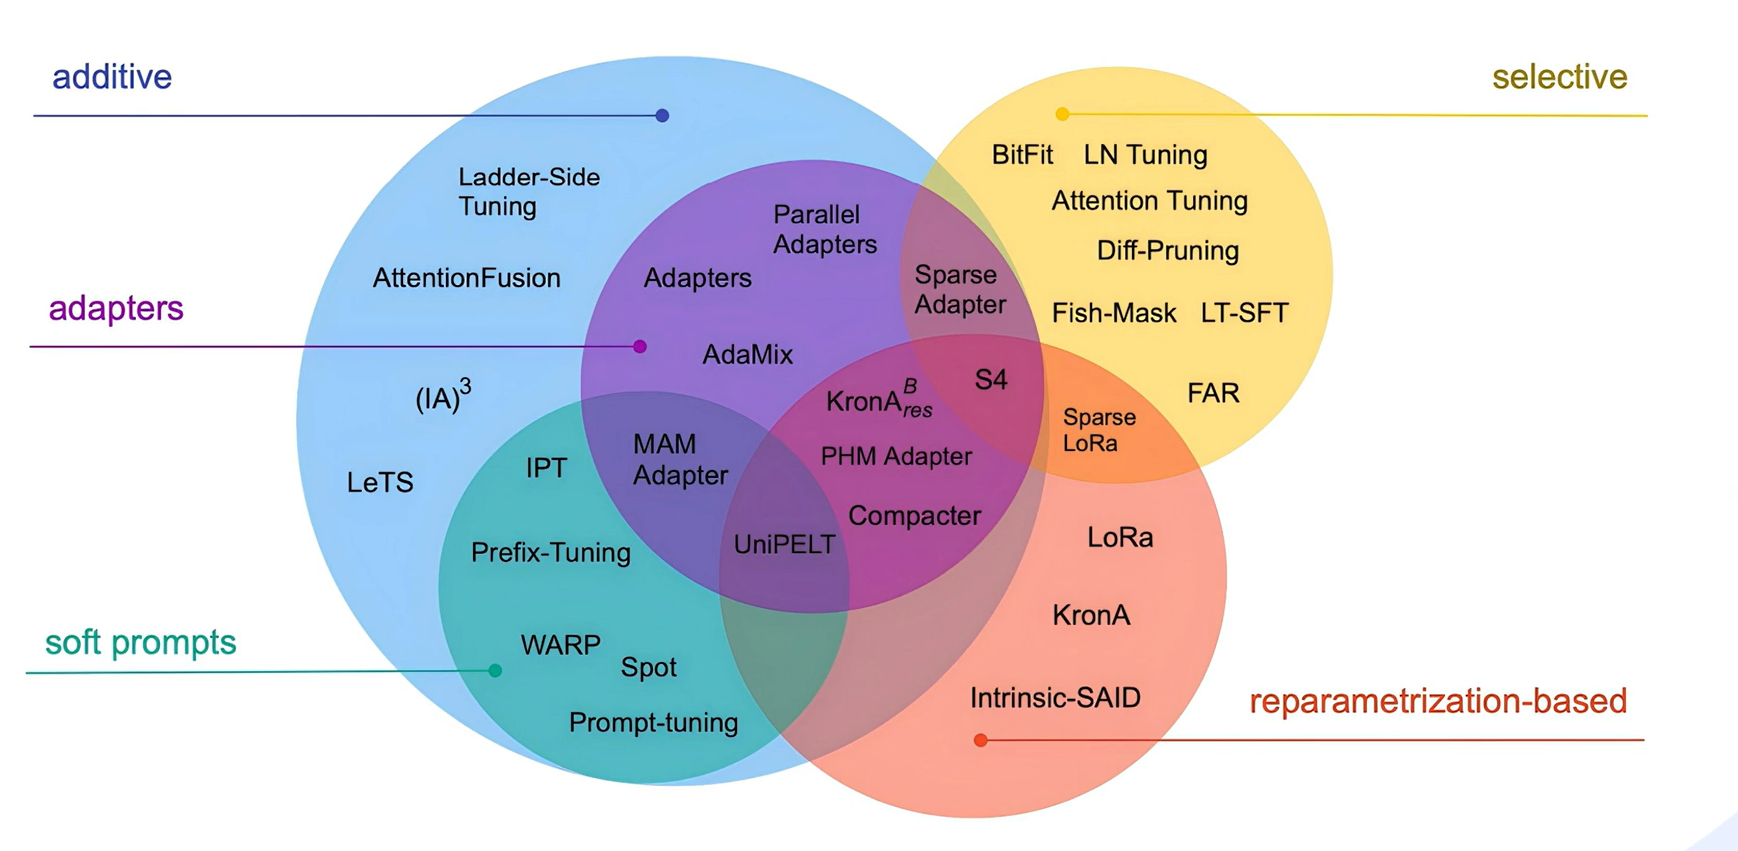
根据可训练参数插入位置、修改方式以及参数结构的差异,PEFT 方法可以大致分为三类:选择性微调(Selective) 、基于额外模块的方法(Additive) 和 基于重参数化的方法(Reparameterization‑based) 。本节我们将逐一展开,并穿插代表性的工作。
4.1 选择性微调(Selective)
选择性微调不添加任何新结构,而是从预训练模型中"挑选"一小部分参数进行训练,其余参数保持冻结。早期工作如 BitFit [2](#2) 仅微调模型中的偏置参数(bias)以及任务特定的归一化层参数。实验表明,仅仅调整这些极少量的参数,在一些基础任务上就能逼近全量微调的效果,参数量占比不到 0.1%。
BitFit 的数学形式极为简单:对于 Transformer 层中的每个权重矩阵 W,其输出通常为 y = Wx + b;BitFit 只更新 b 向量,而保持 W 不变。这种方法实现简单,但上限受限于任务对偏置的敏感度。
另外,像 Diff Pruning 等工作则通过学习一个稀疏掩码,只更新对任务贡献最大的部分参数,也属于选择性微调的范畴。
小结:选择性微调的优点是几乎没有额外结构开销,非常容易实现。缺点是在复杂任务上可能无法学到足够强的任务适应能力,通常不如参数化更强的 Additive 或 Reparameterization 方法。
4.2 基于额外模块的方法(Additive)
这类方法在原始模型架构中插入额外的可训练模块,或者通过可学习的"软提示"向量引导模型行为。其共同点是可训练参数以附加形式存在,不改变原始权重。
4.2.1 Adapters
Adapters 最早由 Houlsby 等人提出,其思路是在 Transformer 的每一层中插入一个小型瓶颈网络(bottleneck),包含下投影、非线性激活和上投影三层结构。训练时仅更新 Adapter 的参数,主模型保持冻结。每个 Adapter 的参数量可以通过瓶颈维度调节,通常只占模型总参数的 2--5%。
Adapters 的变种很多,例如 AdapterFusion 允许组合多个任务的 Adapter 进行知识复用,Compacter 通过参数共享进一步压缩体积。Hugging Face PEFT 库原生支持多种 Adapter 配置,使用非常方便。
4.2.2 Soft Prompts
与在内部插入模块不同,Soft Prompts 方法直接在输入序列前拼接一组可学习的连续向量("软提示"),将下游任务信号融入模型的早期处理。
- Prefix‑Tuning:在每一层 Transformer 的键(K)和值(V)上添加可学习的前缀向量,等价于为模型提供了一个上下文引导。它最早在生成任务上验证成功,参数量极小。
- Prompt‑Tuning:只在前置输入的嵌入层拼接几个虚拟 token 对应的嵌入向量,结构更简单,但通常需要较大的模型规模才能获得好效果。
- P‑Tuning / P‑Tuning v2:将连续提示与离散提示结合,并在多层级中引入可学习 prompt,提升了小模型上的表现。
Soft Prompt 方法的显著优势是参数量非常少,通常只需几个到几十个 token 的向量,且不改变网络结构。不过,它们对提示长度、初始化以及训练超参数较为敏感。
Soft Prompt 与 Prompt Engineering 的区别
理解 Soft Prompt 最容易的方式是将其与传统"提示工程"(Prompt Engineering)对比:
- Prompt Engineering :工程师或用户通过人工设计离散的自然语言文本(如"请对以下评论进行情感分析,正面回答 1,负面回答 0")来引导模型输出。这种方法完全依赖人的经验和反复试错,无需训练模型,但效果受限于措辞质量,且在不同模型或任务间迁移性差。
- Soft Prompt :将"提示"本身转化为一组可训练的连续嵌入向量,这些向量不再对应任何真实词汇,而是由模型在训练数据上通过梯度优化自动学习得到。它本质上是让模型自己"发现"最优的引导信号,属于微调方法的一部分,需要少量标注数据,但参数量极小(通常仅几百到几千个浮点数)。
简而言之,Prompt Engineering 停留在离散文本空间的手工调优 ,而 Soft Prompt 进入了连续向量空间的可学习优化。后者把"提得好问题"这件事从人的经验变成了模型自己的学习能力,在少样本和领域适应场景中优势显著。
4.2.3 (IA)³ ------ 注入式适配器
(IA)³ (Infused Adapter by Inhibiting and Amplifying Inner Activations)[3](#3) 是一种极其轻量的 Additive 方法。它在 Transformer 的激活(键、值以及前馈网络的中间激活)上插入三个可学习的缩放向量,对应地对激活进行抑制或放大。
(IA)³ 的参数量仅与隐藏维度相当,几乎为零额外成本,但在 T0 等模型上往往能击败 LoRA,尤其在少样本学习场景表现突出。Hugging Face PEFT 库中也提供了 (IA)³ 的实现,非常适合极端参数受限的场景。
4.3 基于重参数化的方法(Reparameterization‑based)
重参数化的核心思想是:用一个低秩矩阵间接表示全量微调时权重的变化 ,训练时只优化该低秩矩阵,推理时将其与冻结的原始权重合并,不引入额外推理延迟。目前最具代表性的工作就是 LoRA(Low‑Rank Adaptation)。
LoRA(低秩适配)
LoRA 是 参数高效微调(PEFT) 的奠基性核心算法,2021 年微软团队论文《LoRA: Low-Rank Adaptation of Large Language Models》提出。
核心思路:冻结预训练大模型全部原始权重,仅在 Transformer 注意力层(Q/V 线性投影)插入两组极小的低秩矩阵,只训练这两组矩阵,用极少参数实现媲美全量微调的领域适配效果。
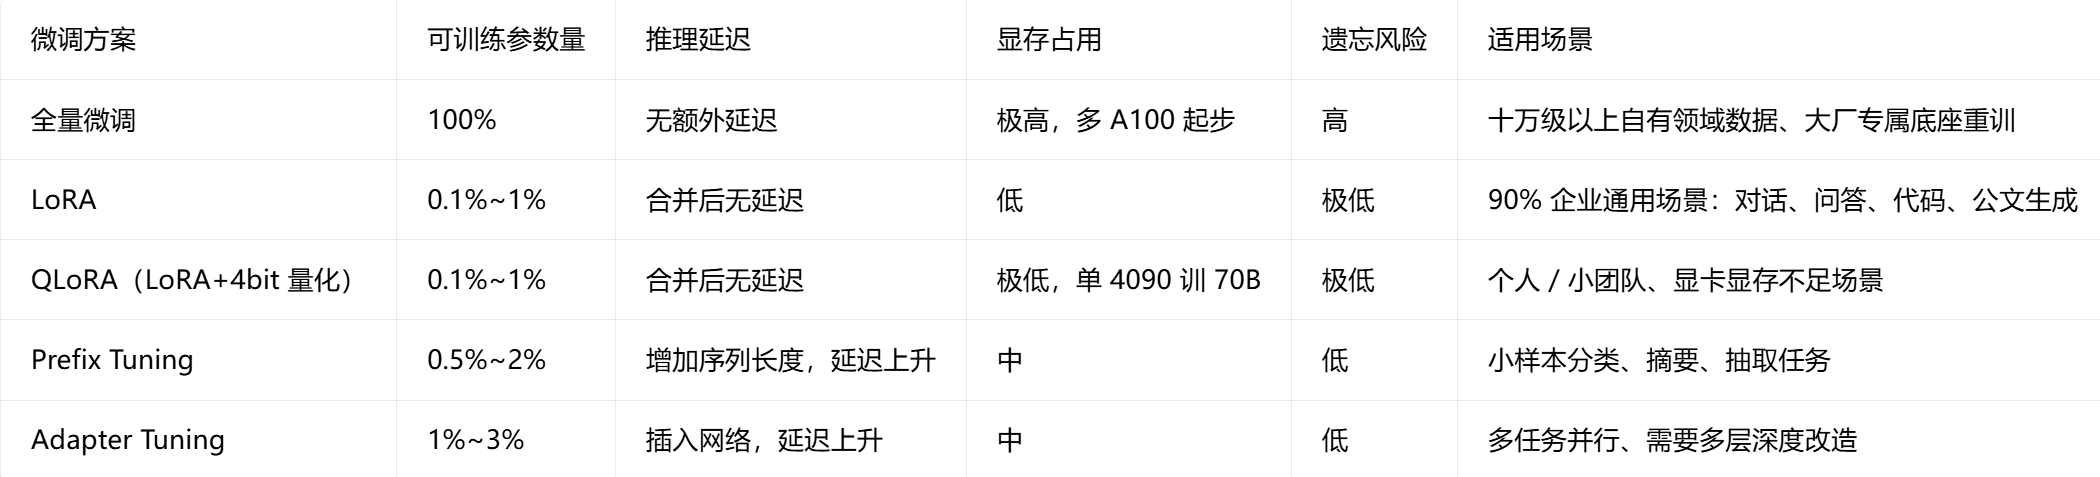
LoRA 可以应用到 Transformer 的全连接层或注意力层的 Q、K、V 投影矩阵上,实践中通常只对 Q 和 V 应用就已足够。由于矩阵 A、B 参数极少,LoRA 的训练速度极快。推理时,可以直接将 AB 乘回 W 中,得到完整的 W',因此推理延迟与原始模型完全一致------这是相对 Adapter 等方法的重大优势。
在此基础上,还衍生出许多改进版本:AdaLoRA 自适应地为不同层分配不同的秩,QLoRA 结合量化技术,进一步将微调成本压缩到一条消费级 GPU 足以运行 65B 模型的程度。
LoRA 与主流微调方案横向对比
LoRA 变体概览
| 方法 | 特点 | 代表用途 |
|---|---|---|
| LoRA | 固定低秩,简单有效 | 文本生成、指令微调 |
| AdaLoRA | 自适应秩分配 | 多任务或动态预算场景 |
| QLoRA | 量化 + LoRA | 极限显存限制下的微调 |
| VeRA | 向量随机适配 | 极度压缩(仅需两个向量) |
这些方法共同构成了重参数化路径的丰富工具箱,而 Hugging Face PEFT 库对上述绝大部分都有良好支持。
5. 如何选择适合的 PEFT 方法
面对如此多的 PEFT 类型,选择时建议从以下几个维度权衡:
-
任务复杂度与数据量
- 简单分类、情感分析等任务:BitFit 或 Prompt‑Tuning 可能已经足够,且调参简单。
- 复杂生成、多轮对话或代码生成:LoRA 或 (IA)³ 通常能带来更好的上限。
-
参数量约束与存储成本
- 极度参数受限(如边缘设备)且不想修改模型推理过程:可优先考虑 BitFit、(IA)³ 或 Prompt‑Tuning。
- 可接受少量插件式存储(几 MB 到几十 MB)且希望性能最佳:LoRA 系列是性价比最高的选择。
-
推理延迟要求
- 需要与原始模型完全一致的推理速度:LoRA(合并权重后)、(IA)³(非额外层)是首选。
- Adapter 会引入额外的层,轻微增加推理成本,但通常可以接受。
-
开发与集成便利性
- 所有方法在 Hugging Face PEFT 库中都有统一接口,但成熟度不同。LoRA 是目前社区最活跃、文档最丰富的方法,推荐作为入门首选。
一个实用的策略是:先尝试 LoRA(如 r=8 或 16)快速验证,如果效果不够满意,再尝试 (IA)³ 或 Adapter。如果资源极为有限或强调即插即用,则可以考虑 BitFit 或 Prompt‑Tuning。
6. 实战:使用 Hugging Face PEFT 微调大模型
本节展示一个完整的 LoRA 微调流程,使用 Hugging Face 的 peft、transformers 和 datasets 库。我们以微调一个小型 LLM(例如 GPT‑2)作为情绪分类任务的例子,但同样的流程可以直接迁移到 LLaMA、Bloom 等模型上。
python
from transformers import AutoModelForCausalLM, AutoTokenizer, Trainer, TrainingArguments
from peft import LoraConfig, get_peft_model, TaskType
from datasets import load_dataset

# 1. 加载基础模型和分词器
model_name = "gpt2"
model = AutoModelForCausalLM.from_pretrained(model_name)
tokenizer = AutoTokenizer.from_pretrained(model_name)
tokenizer.pad_token = tokenizer.eos_token

# 2. 定义 LoRA 配置
lora_config = LoraConfig(
    task_type=TaskType.CAUSAL_LM,   # 因果语言模型
    r=8,                            # 低秩维度
    lora_alpha=32,                  # 缩放系数
    lora_dropout=0.1,               # Dropout
    target_modules=["c_attn"]       # GPT‑2 中 Q/K/V 的融合层名称
)

# 3. 包装成为 PEFT 模型
peft_model = get_peft_model(model, lora_config)
peft_model.print_trainable_parameters()
# 输出类似: trainable params: 294,912 || all params: 124,439,808 || trainable%: 0.2371

# 4. 准备数据集(IMDB 情绪二分类简单演示)
dataset = load_dataset("imdb", split="train[:1%]")
def preprocess(examples):
    return tokenizer(examples["text"], truncation=True, padding="max_length", max_length=256)
dataset = dataset.map(preprocess, batched=True)

# 5. 设置训练参数(只演示一小段,实际训练需更多 step)
training_args = TrainingArguments(
    output_dir="./lora_imdb",
    per_device_train_batch_size=4,
    num_train_epochs=1,
    logging_steps=10,
    save_strategy="no",
    report_to="none"
)

trainer = Trainer(
    model=peft_model,
    args=training_args,
    train_dataset=dataset
)
trainer.train()

# 6. 保存 PEFT 模块(仅保存 LoRA 增量权重)
peft_model.save_pretrained("lora_imdb_adapter")
训练完成后,只有几 MB 的 adapter_config.json 和 adapter_model.bin 被保存,原始 GPT‑2 模型无需改动。部署时,只需加载基础模型再附加这个 PEFT 模块即可:
python
from peft import PeftModel

base_model = AutoModelForCausalLM.from_pretrained(model_name)
peft_model = PeftModel.from_pretrained(base_model, "lora_imdb_adapter")
这种方式天然支持多任务:同一个基础模型可以同时加载多个 PEFT 模块,通过 set_adapter 动态切换,无需多次加载整个模型。