Hive是什么
Hive是由Facebook开源,基于Hadoop的一个数据仓库工具,可以将结构化的数据文件映射为一张表,并提供类SQL查询功能。
本质:Hive是一个Hadoop客户端,用于将HQL(Hive SQL)转化成MapReduce程序。
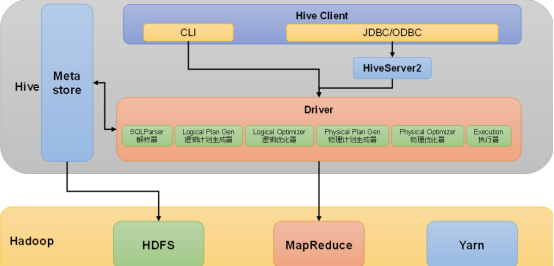
Hive架构原理
Hive的数据的写入写出都在HDFS,执行过程就是MR程序的执行,通过yarn调度器调度,提供CLI和JDBC/ODBC客户端。
Hive的优缺点
1)优点
(1)操作接口采用类SQL语法,提供快速开发的能力(简单、容易上手)。
(2)避免了去写MapReduce,减少开发人员的学习成本。
2)缺点
(1)Hive的执行延迟比较高,因此Hive常用于数据分析,对实时性要求不高的场合。
(2)Hive分析的数据是存储在HDFS上,HDFS不支持随机写,只支持追加写,所以在Hive中不能高效update和delete。
数据库和数据仓库的区别
数据库Database(Oracle, Mysql, PostgreSQL)主要用于事务处理。
数据仓库Datawarehouse(Amazon Redshift, Hive)主要用于数据分析。
用途上的不同决定了这两种架构的特点不同。
数据库(Database)的特点是:
相对复杂的表格结构,存储结构相对紧致,少冗余数据。
读和写都有优化。
相对简单的read/write query,单次作用于相对的少量数据。
数据仓库(Datawarehouse)的特点是:
相对简单的(Denormalized)表格结构,存储结构相对松散,多冗余数据。
一般只是读优化。
相对复杂的read query,单次作用于相对大量的数据(历史数据)。
Linux中安装MySQL
**1)**查看系统之前是否已安装MySQL
rpm -qa | grep mysql
有的话,卸载:
rpm -e mysql-libs-5.1.66-2.el6_3.i686 --nodeps
**2)**安装Mysql:yum install mysql mysql-server mysql-devel
**3)**安装完成后修改/etc/my.cnf文件,添加内容如下:
mysql
default-character-set=utf8
mysqld
default-character-set=utf8
lower_case_table_names=1
**4)**启动服务验证是否已启动
service mysqld start
**5)**停掉服务
service mysql stop
设置MySql用户:mysqladmin -u root password 123
**6)**登录
mysql -uroot --p
**7)**进行重置密码(可做可不做)
set password=password('123456');
查看用户:select user,host from user;(可不用查看)
--设置root账户的host地址(修改了才可以远程连接)
mysql>grant all privileges on *.* to 'root'@'%' identified by 'root'
with grant option ;
**8)**刷新
flush privileges
安装Hive
第一步:确保Mysql已经安装成功(Mysql安装详见第4点)
第二步:复制Mysql驱动jar包到hive的lib路径下
第三步:修改hive-env.sh文件,添加如下内容:
export HIVE_CONF_DIR=/usr/local/hive/hive-0.13.1-cdh5.3.6/conf export JAVA_HOME=/usr/local/java/jdk1.8.0_161 export HIVE_HOME=/usr/local/hive/hive-0.13.1-cdh5.3.6 export HADOOP_HOME=/usr/local/hadoop/hadoop-2.5.1第四步:修改hive-site.xml文件
 <property>        <name>javax.jdo.option.ConnectionURL</name>        <value>jdbc:mysql://192.168.100.110:3306/hive?createDatabaseIfNotExist=true</value>    </property>
    <property>        <name>javax.jdo.option.ConnectionDriverName</name>        <value>com.mysql.jdbc.Driver</value>   </property>
   <property>        <name>javax.jdo.option.ConnectionUserName</name>        <value>root</value>   </property>

   <property>        <name>javax.jdo.option.ConnectionPassword</name>        <value>123</value>   </property>
   <property>        <name>hive.querylog.location</name>        <value>/usr/local/hive/hive-0.13.1-cdh5.3.6/hive_tmp</value>   </property>
   <property>        <name>hive.downloaded.resources.dir</name>        <value>/usr/local/hive/hive-0.13.1-cdh5.3.6/hive_tmp</value>   </property>
   <property>        <name>hive.exec.local.scratchdir</name>        <value>/usr/local/hive/hive-0.13.1-cdh5.3.6/hive_tmp</value>   </property>
   <property>        <name>datanucleus.schema.autoCreateAll</name>        <value>true</value>   </property>
第五步:分发hive文件至各个节点
例:scp -r /usr/local/hive/hive-0.13.1-cdh5.3.6 slave1:/usr/local/hive
进入Hive命令行
确保hadoop集群启动,且节点正常的前提下,直接在Linux的命令行输入hive即可。