本文原创首发于CSDN,作者:AI技术前沿观察员
发布时间:2026年7月9日
关键词:LLM Wiki、大模型、知识管理、RAG、Andrej Karpathy、知识库、AI Agent
📌 前言:Karpathy又扔出了一个新概念
2026年4月,前OpenAI联合创始人、AI圈顶流大神 Andrej Karpathy 在X上抛出了一个新概念------LLM Wiki。
短短三个月,这个概念火遍了整个AI开发者社区。有人说它是RAG的替代品,有人说它是下一代知识库形态,还有人直接把它做成了创业项目。
但LLM Wiki到底是什么?它和传统的RAG(检索增强生成)有什么本质区别?真的能颠覆现有的知识管理方式吗?
今天这篇文章,我将从核心概念、架构设计、工作流程、与RAG深度对比、落地方案、实战案例六个维度,带你彻底搞懂LLM Wiki。
一、LLM Wiki 是什么?一张图搞懂核心定位
1.1 官方定义
LLM Wiki = 大语言模型驱动的维基知识库
简单来说,就是把LLM当成一个全职的知识编译器+自动图书管理员:
- 你只负责往里面丢原始资料(论文、网页、笔记、文档)
- LLM自动把这些零散信息编译成结构化、互联、可迭代的Markdown维基知识库
- 新资料入库时,自动更新旧词条、交叉关联、修正冲突观点
- 知识像滚雪球一样越积越多,实现真正的知识复利
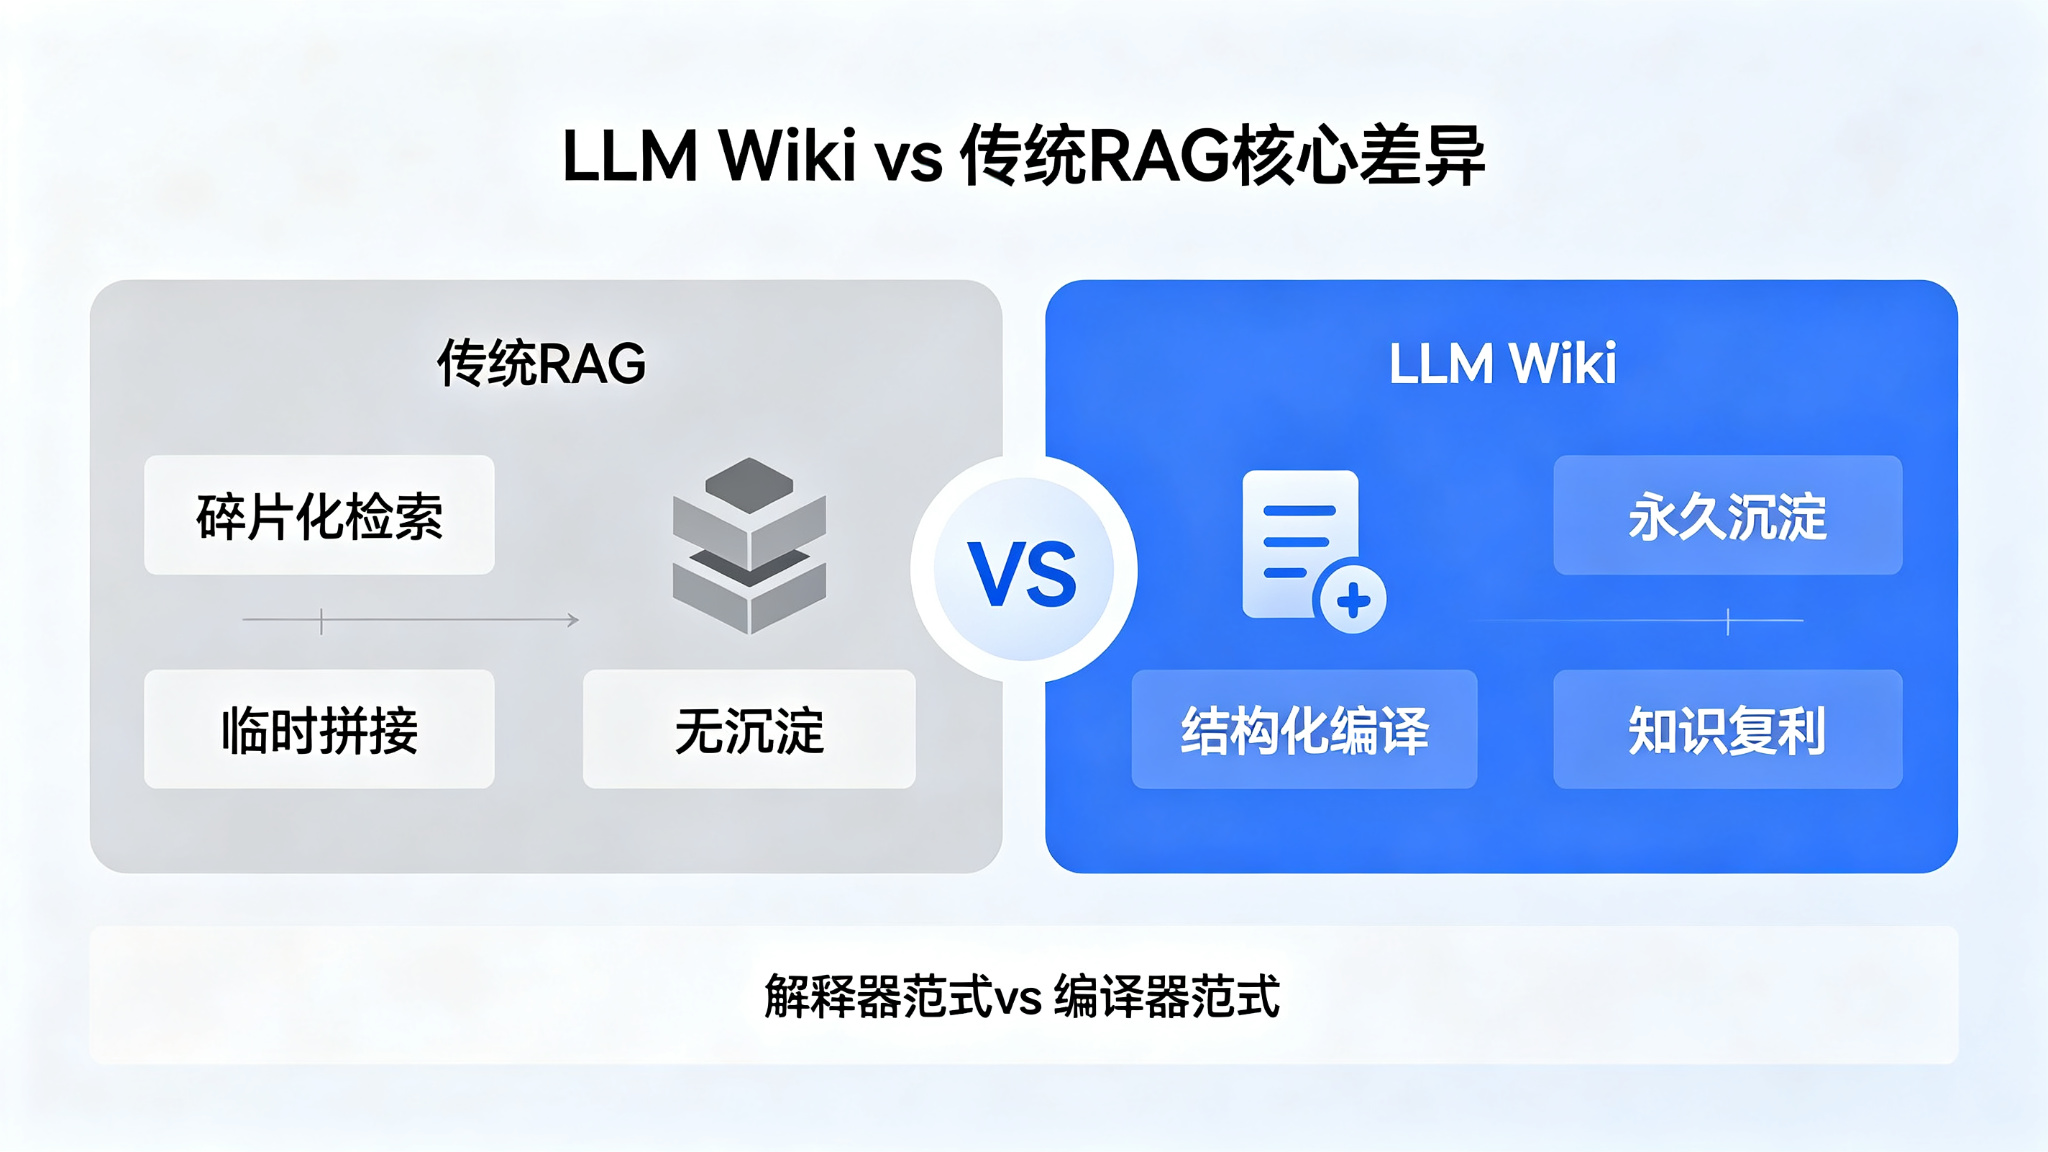
1.2 一句话理解:编译器 vs 解释器
这是Karpathy本人最推崇的类比,也是理解LLM Wiki的关键:
| 范式 | 类比 | 工作方式 |
|---|---|---|
| 传统RAG | 解释器 | 每次提问临时去原始文档里检索、拼接、回答,查询结束知识不沉淀 |
| LLM Wiki | 编译器 | 资料入库时一次性结构化编译,产出永久Wiki页面,查询直接读取整理好的知识 |
传统RAG的问题:100篇资料进去,第101篇不会让前100篇变得更好。每次查询都是从零开始的碎片拼接,没有长期记忆,没有知识积累。
LLM Wiki的突破:新知识入库会自动优化、补充、关联旧知识,整个知识库会随着资料增加持续自我进化。
💡 再换个类比:Obsidian/Logseq是代码编辑器,你的原始资料是源码,LLM是程序员,Wiki知识库是长期维护的代码仓库。
1.3 LLM Wiki 不是什么
在深入之前,先澄清几个常见误区:
❌ 不是一款具体的软件 ------它是一套知识管理范式/架构理念,任何人都可以用不同工具实现
❌ 不是要完全替代RAG ------两者是互补关系,最佳实践是组合使用
❌ 不是全自动无人值守 ------人类负责筛选优质资料和制定规则,LLM负责机械整理
❌ 不是必须用特定大模型------Grok、GPT、Claude、国产模型都能驱动
二、三层标准架构:LLM Wiki 的经典设计
2.1 整体架构概览
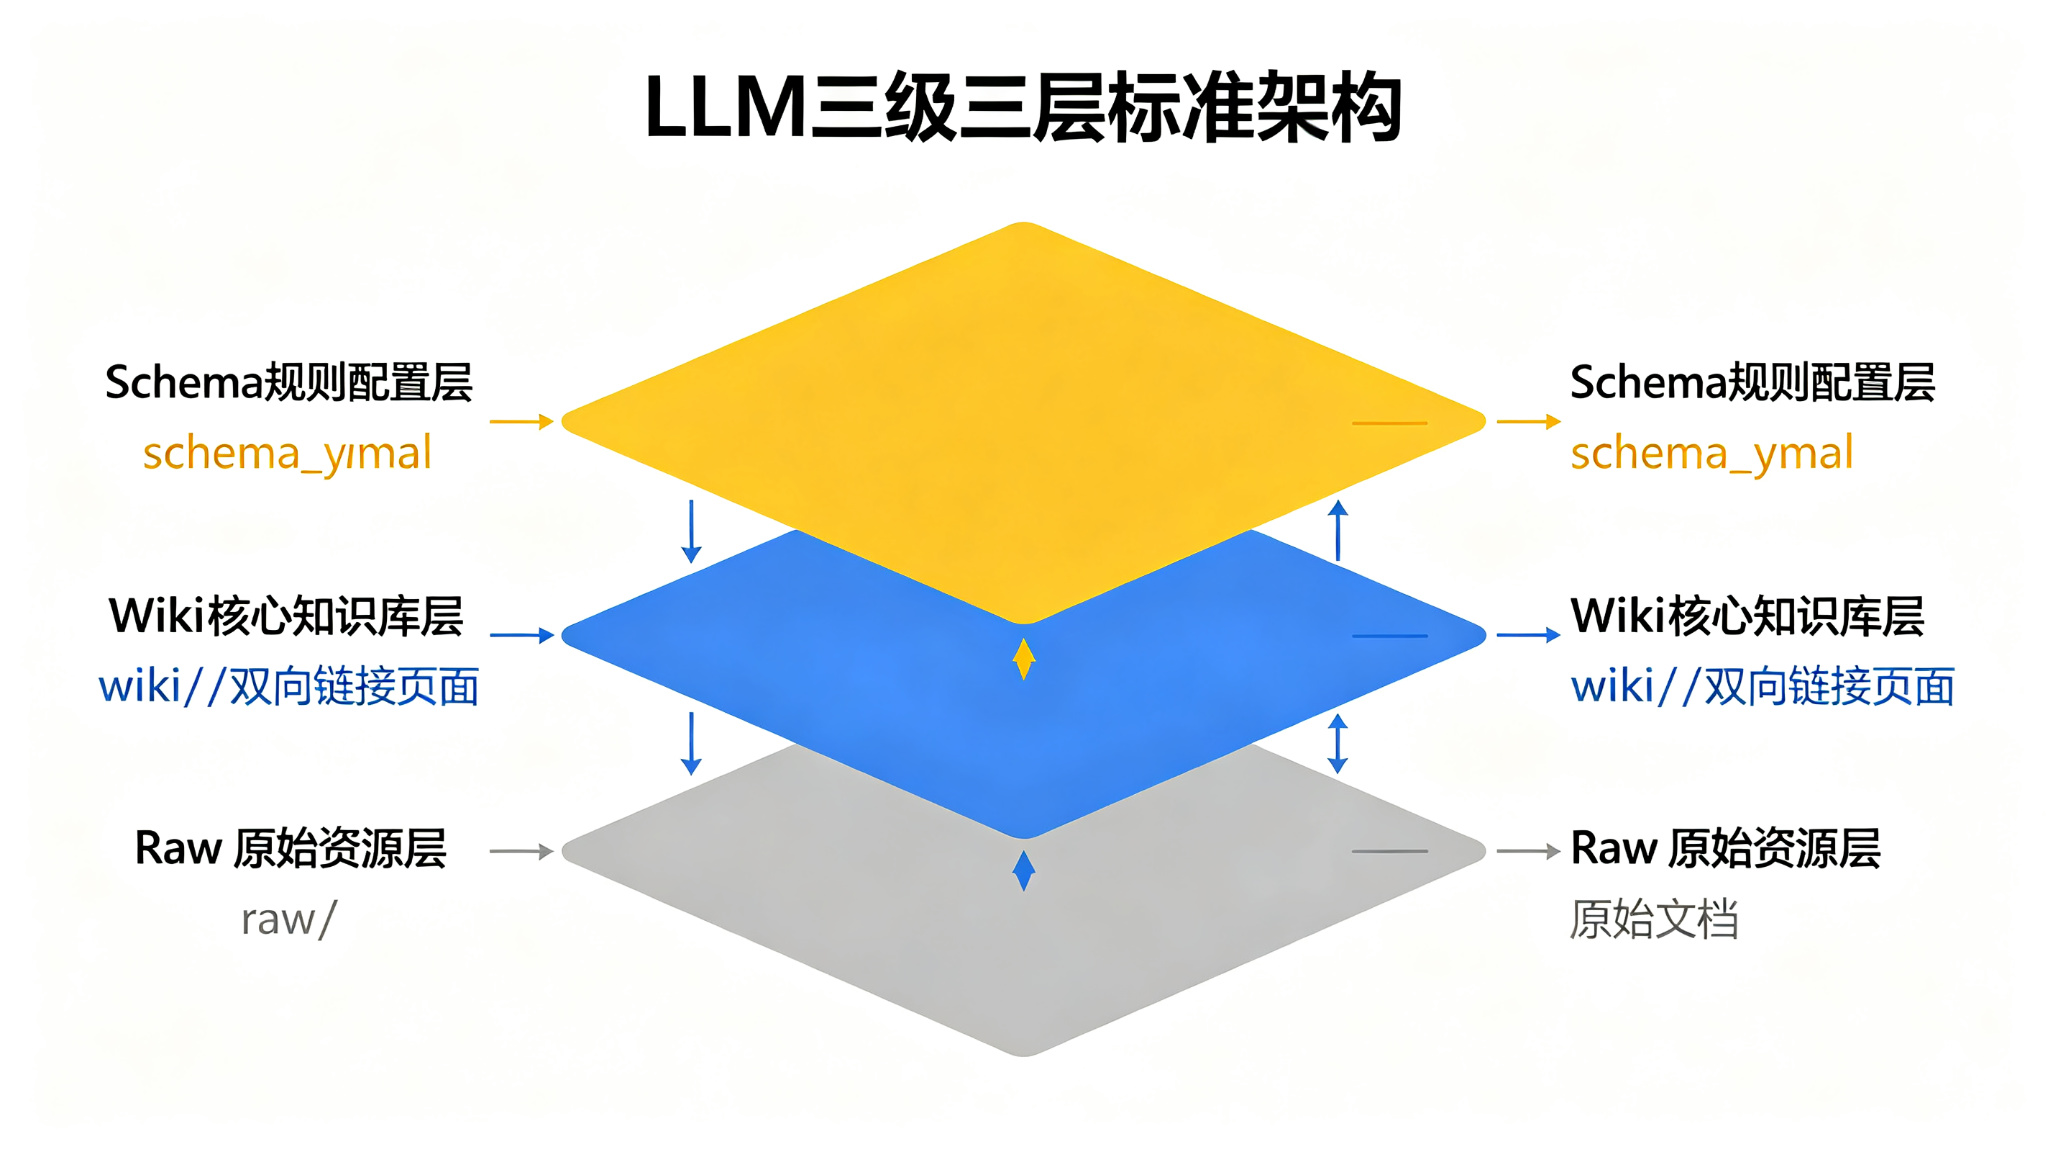
Karpathy在原始提案中给出了标准的三层目录结构,全部使用纯Markdown文本,无需向量数据库、无需复杂后端,落地极其轻量:
llm-wiki/
├── raw/          # 第一层:原始资源层(只读)
├── wiki/         # 第二层:核心知识库(LLM维护)
└── schema.yaml   # 第三层:规则配置层(人类定义)
2.2 第一层:Raw Sources 原始资源层
位置 :raw/ 文件夹
作用:存放所有不可修改的原始素材,是整个知识库的真相来源(Source of Truth)。
包含内容:
- 📄 学术论文PDF
- 🌐 网页存档、博客文章
- 💬 聊天记录、会议纪要
- 📝 个人读书笔记、灵感碎片
- 🖼️ 截图转文字、白板笔记
- 💻 技术文档、API手册
核心规则 :LLM对这一层只读不写,原始素材永久留存,所有Wiki内容都可以溯源回原始资料。
2.3 第二层:The Wiki 核心知识库
位置 :wiki/ 文件夹
作用:由大模型全权维护的结构化知识库,人类主要是阅读消费。
自动生成的页面类型:
| 页面类型 | 说明 | 示例 |
|---|---|---|
| 概念词条 | 单个知识点的独立页面,包含定义、原理、优缺点 | RAG.md、Transformer.md |
| 实体页面 | 具体模型、工具、人物的详情页 | Grok-4.5.md、Claude-Opus.md |
| 对比页面 | 多实体横向对比分析 | 旗舰大模型价格对比.md |
| 综述页面 | 某领域的系统性总结 | 2026大模型技术路线综述.md |
| 衍生报告 | 基于现有知识生成的新内容 | 技术选型建议.md、实验复盘.md |
关键特性:
- 自动生成
[[双向内部链接]],天然形成知识图谱 - 自动识别新旧资料的观点冲突并标注来源
- 新资料入库时,自动更新所有相关页面
- 纯Markdown格式,可直接用Obsidian、VS Code打开
2.4 第三层:Schema 规则配置层
位置 :schema.yaml 文件
作用:人类定义的规则手册,告诉LLM该如何维护这个Wiki。
典型配置项:
yaml
# 命名规范
naming:
  page_title_style: "首字母大写,空格分隔"
  entity_page_format: "实体名-类别.md"

# 入库流程
ingestion:
  auto_extract_key_points: true
  auto_update_related_pages: true
  max_pages_per_source: 15
  conflict_resolution: "标注分歧,保留双方观点"

# 排版规范
formatting:
  heading_levels: 4
  table_style: "markdown标准表格"
  citation_style: "文末引用,链接回raw目录"

# 巡检规则
linting:
  check_orphan_pages: true
  check_stale_content: 30天
  auto_generate_missing_comparisons: true
三、完整工作流程:三步闭环实现知识复利
3.1 流程图概览
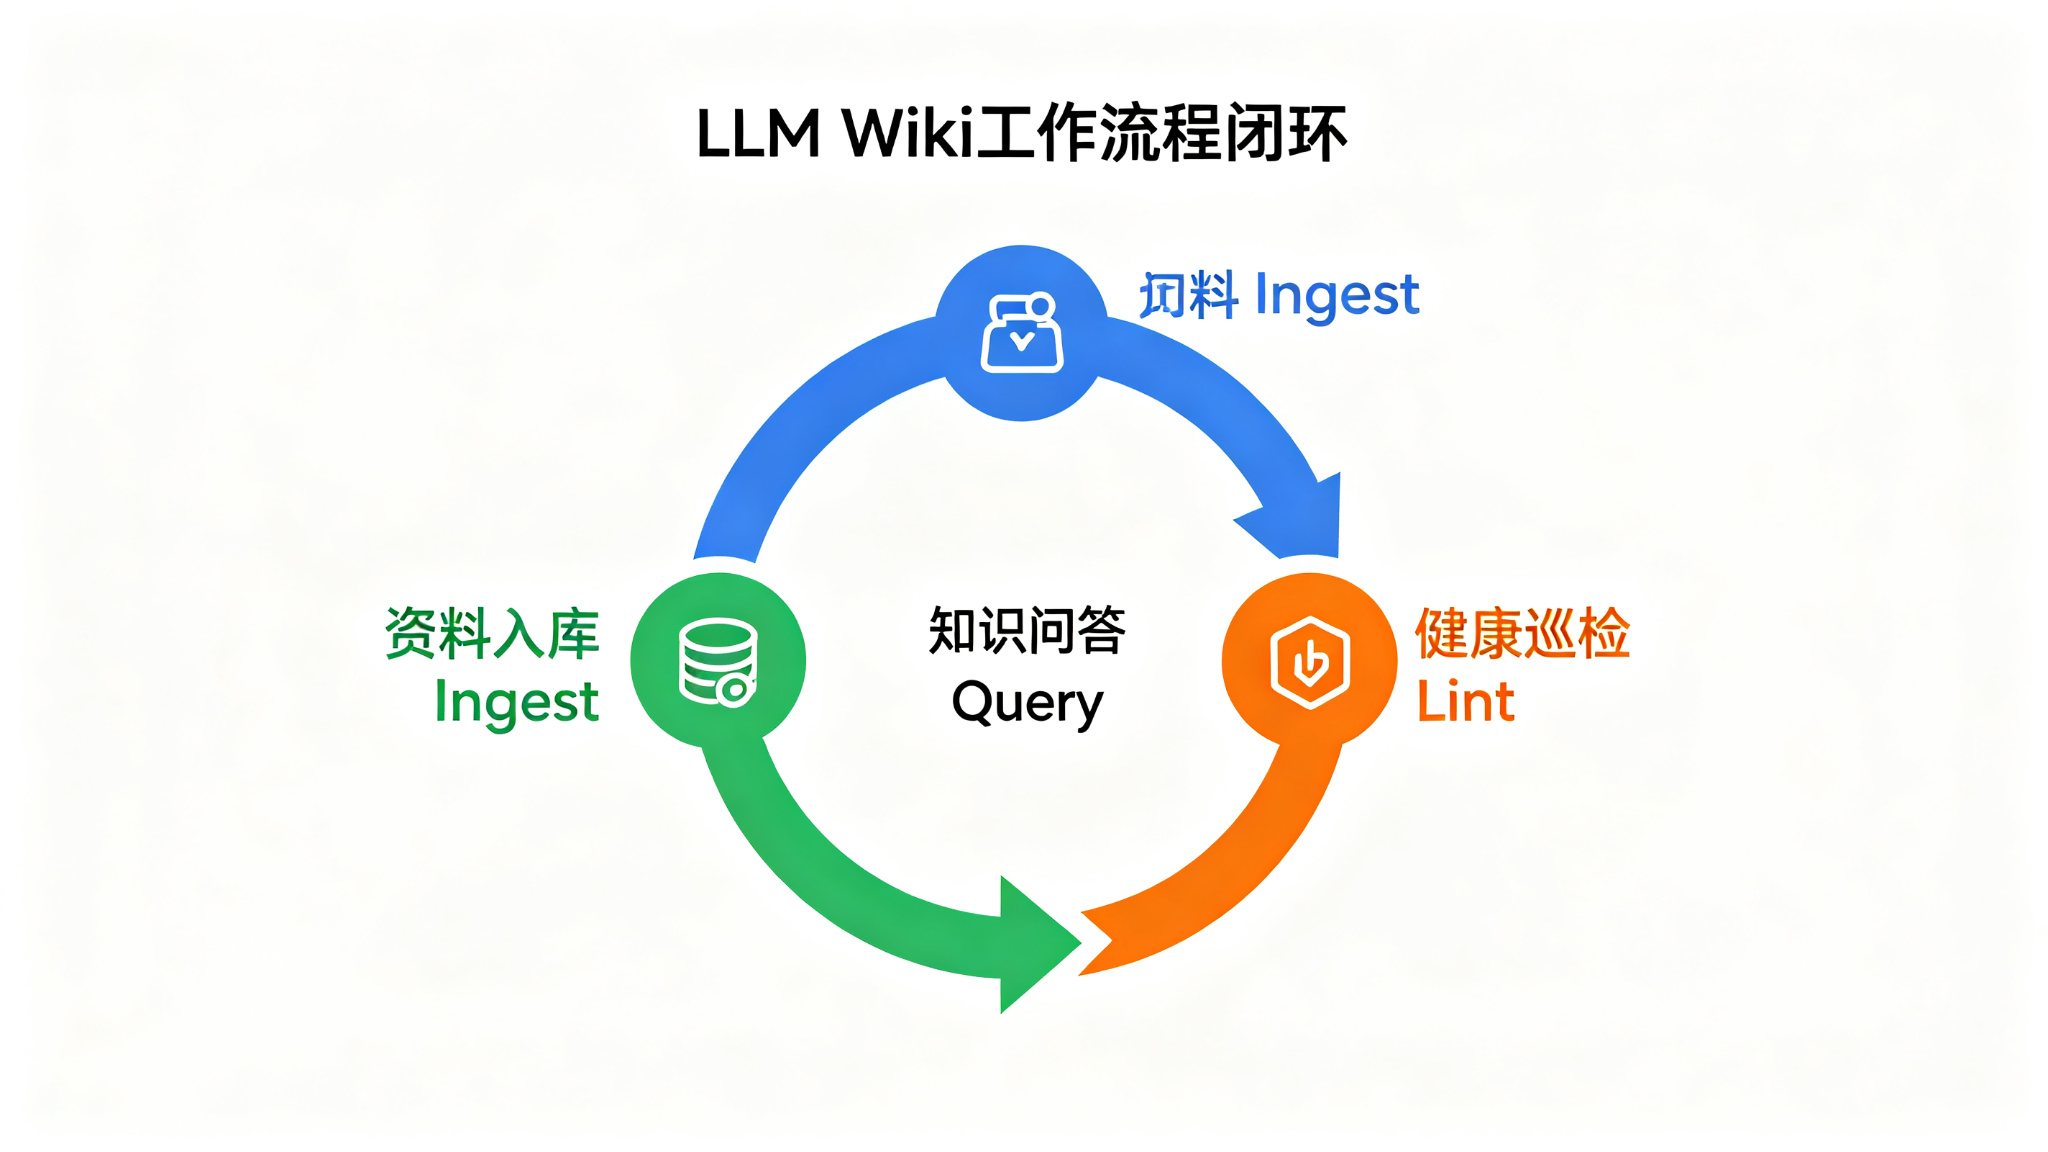
整个LLM Wiki的运行是一个持续迭代的闭环:
资料入库(Ingest) → 知识问答(Query) → 健康巡检(Lint) → 回到入库
     ↑                                            |
     └────────────────────────────────────────────┘
3.2 Step 1:Ingest 资料入库(核心环节)
当你把一份新资料丢进 raw/ 文件夹时,LLM会自动执行以下操作:
1. 内容提取与理解
- 解析文档全文,提取核心观点、关键数据、重要结论
- 识别文档中的实体、概念、人物、工具
- 提取引用来源、发布时间、可信度标记
2. 关联检索
- 遍历整个Wiki,找出所有与新资料相关的已有词条
- 识别重叠内容、互补内容、冲突内容
3. 批量更新
- 更新已有相关页面(补充新信息、修正过时内容)
- 创建新的概念/实体词条
- 添加双向内部链接,建立知识关联
- 生成/更新对比页面、综述页面
4. 冲突处理
- 新旧资料观点不一致时,不直接覆盖,而是标注分歧
- 保留双方观点,并注明各自来源
- 由人类最终判断哪个更准确
💡 典型效果:一份高质量的新论文入库,通常会同步更新10~15个Wiki页面,触发整个知识网络的局部进化。
3.3 Step 2:Query 知识问答
提问时,LLM不再去碎片化的原始文档里检索,而是直接读取预编译好的完整结构化Wiki。
优势对比:
| 传统RAG问答 | LLM Wiki问答 |
|---|---|
| 临时检索碎片拼接,逻辑易断裂 | 读取完整结构化词条,推理质量更高 |
| 每次都要消耗大量token做检索 | 直接读取,token消耗少、速度快 |
| 答案用完即弃,无沉淀 | 高质量问答可自动归档为新Wiki页面 |
| 跨文档对比能力弱 | 天然支持多维度对比分析 |
问答产出的新洞察,会自动回流到Wiki中------这就是知识复利的来源。
3.4 Step 3:Lint 知识库健康巡检
类似代码的Lint检查,定期对整个知识库执行健康巡检:
检查项:
- 🧹 孤立页面检测:找出没有任何内链指向的孤儿页面
- ⏰ 内容时效性检查:标记超过N天未更新的可能过期内容
- 🔗 链接完整性:检测断链、缺失的关联页面
- 📊 覆盖度分析:识别知识盲区,生成待研究清单
- ⚖️ 一致性校验:检查不同页面间是否存在未标注的矛盾观点
巡检产出:
- 自动修复可自动修复的问题(补充链接、更新格式)
- 生成「人类待处理清单」,标注需要人工决策的内容
四、深度对比:LLM Wiki vs 传统RAG
4.1 核心差异总览
这是大家最关心的问题:LLM Wiki和RAG到底有什么不一样?
| 对比维度 | 传统RAG | LLM Wiki |
|---|---|---|
| 处理时机 | 查询时实时检索拼接(在线计算) | 资料入库时预编译结构化(离线计算) |
| 知识形态 | 碎片化原始文档 + 向量索引 | 结构化互联Wiki页面 + 双向链接 |
| 留存特性 | 查询即销毁,无长期沉淀 | Wiki永久保存,持续迭代进化 |
| 跨文档推理 | 依赖检索质量,碎片拼接易断裂 | 完整词条天然支持深度对比综合 |
| 维护方式 | 人工分块、调参、优化向量 | LLM全自动维护关联、更新、纠错 |
| 系统依赖 | 向量数据库、Embedding模型、重排模型 | 仅纯Markdown文件,零额外依赖 |
| Token效率 | 每次查询都要重复检索,浪费token | 一次编译多次使用,token效率极高 |
| 知识增长 | 线性叠加,资料越多检索越慢 | 复利增长,资料越多知识库越智能 |
| 可解释性 | 溯源困难,不知道答案来自哪 | 每条结论都可溯源到原始资料 |
| 人工成本 | 持续调优检索策略、分块策略 | 前期定义Schema,后期几乎不用管 |
4.2 为什么LLM Wiki的回答质量更高?
传统RAG的痛点------上下文窗口的囚徒困境:
- 检索回来的是碎片化的文档片段
- 片段之间缺乏上下文关联
- 模型需要在有限上下文里拼凑出完整答案
- 信息遗漏、逻辑断裂是常态
LLM Wiki的优势------预编译的完整知识:
- Wiki页面本身就是经过整理的完整知识单元
- 概念定义、优缺点、对比分析、相关引用一应俱全
- 模型直接读取完整结构化内容进行推理
- 跨页面的关联通过双向链接保证完整性
4.3 成本对比:谁更省钱?
以「维护一个100篇论文的技术知识库,日均50次查询」为例:
| 成本项 | 传统RAG | LLM Wiki |
|---|---|---|
| 入库成本 | Embedding向量化(低成本) | LLM编译整理(中高成本,一次性) |
| 单次查询成本 | 高(检索+重排+生成,重复消耗) | 低(直接读取Wiki生成) |
| 月度总成本估算 | ~$200-500 | ~$50-150 |
| 规模效应 | 文档越多,查询成本越高 | 文档越多,单次查询成本越低 |
结论:查询频率越高、资料越多,LLM Wiki的成本优势越明显。对于高频使用的内部知识库,长期成本可能只有RAG的1/3~1/5。
4.4 最佳实践:不是替代,而是组合
LLM Wiki不是要完全干掉RAG,两者各有擅长的场景:
LLM Wiki 擅长:
- 高频查询的稳定知识
- 需要深度综合、对比分析的问题
- 长期沉淀的核心知识库
- 团队共享的结构化知识
RAG 擅长:
- 低频、临时性的长尾问题
- 需要精确匹配原始文档的场景
- 时效性极强、快速变化的信息
- 大规模全文档精准检索
黄金组合方案:
LLM Wiki作为核心知识层,沉淀80%的高频稳定知识;RAG作为补充检索层,覆盖20%的长尾临时需求。
五、核心优势:为什么LLM Wiki正在火起来
5.1 解决「信息吃灰」的终极方案
每个人都有这样的痛点:
- 收藏了几百篇技术文章、几十篇论文,再也没看过
- 笔记软件里存了几千条笔记,找的时候找不到
- 学过的知识散落在各处,无法形成体系
LLM Wiki让这些沉睡的信息真正流动起来------AI自动帮你消化、串联、结构化,彻底摆脱信息孤岛。
5.2 极致轻量化,零技术债务
- 纯文本Markdown,不绑定任何平台
- 没有向量数据库、没有复杂后端
- 可以用Git做版本管理,完整历史可追溯
- 可以用Obsidian、VS Code、任何Markdown编辑器打开
你的知识库永远是你的,不会被任何厂商锁定。
5.3 知识复利:越用越值钱
这是LLM Wiki最迷人的特性。
传统知识库:资料越多,检索越慢,维护越麻烦,价值线性增长。
LLM Wiki:资料越多,知识关联越丰富,回答质量越高,价值指数级增长。
每一份新资料的加入,都在让整个知识库变得更聪明。
5.4 完美适配AI Agent时代
Agent需要长期记忆,但目前的Agent记忆方案都有各种问题:
- 向量检索记忆太碎片化
- 总结记忆丢失太多细节
- 上下文窗口记忆容量有限
LLM Wiki天然就是Agent的长期记忆外置硬盘:
- 结构化的知识便于Agent理解和使用
- 双向链接支持Agent探索式学习
- 可溯源避免Agent幻觉
- 可以多Agent共享同一个知识库
六、主流落地方案:从个人到企业的四种选择
6.1 方案一:纯手工DIY(极客/个人开发者首选)
适合人群:喜欢折腾的程序员、想完全掌控的技术爱好者
技术栈:
- 文件夹结构:手动创建 raw/ wiki/ schema.yaml
- LLM调用:Python脚本 + OpenAI/Grok/Claude API
- 编辑器:Obsidian / VS Code
- 版本管理:Git
核心步骤:
- 搭建三层目录结构
- 编写Python入库脚本(调用LLM解析文档、生成/更新Wiki)
- 用Obsidian打开wiki文件夹,可视化浏览知识图谱
- 写个定时任务执行Lint巡检
优点 :完全可控、成本最低、可深度定制
缺点:需要一定开发能力,前期花时间搭架子
6.2 方案二:开箱即用工具(普通用户首选)
| 工具名称 | 类型 | 特点 | 价格 |
|---|---|---|---|
| llmwiki.app | Web应用 | Karpathy理念官方配套工具,UI友好 | 免费版+Pro版 |
| llm-wiki.net | 开源CLI | 命令行工具,支持批量爬虫、多Agent | 免费开源 |
| WikiMind | 桌面应用 | 本地运行,支持多种本地大模型 | 免费+付费高级功能 |
| Obsidian + Copilot插件 | 插件组合 | 在Obsidian内直接实现LLM Wiki功能 | 插件订阅制 |
6.3 方案三:Python库集成(开发者嵌入业务)
推荐库 :llm-notebook(PyPI可安装)
核心能力:
- 一行代码执行资料入库
- 支持多种LLM后端(OpenAI、Anthropic、国产模型)
- 可生成静态Wiki网站,部署到GitHub Pages
- 支持自定义Schema和处理Pipeline
代码示例:
python
from llm_notebook import LLMWiki

# 初始化知识库
wiki = LLMWiki(
    base_path="./my-wiki",
    llm_provider="openai",
    model="gpt-4o"
)

# 批量入库
wiki.ingest("./raw/papers/*.pdf")

# 查询知识库
answer = wiki.query("RAG和LLM Wiki有什么区别?")
print(answer)

# 生成静态网站
wiki.build_static_site(output="./docs")
6.4 方案四:企业级部署
适合:中大型企业内部知识库、团队协作
架构建议:
- 接入企业内部文档系统(Confluence、Notion等)
- 私有化部署大模型(数据安全)
- 多用户权限管理
- 审核工作流(AI生成内容需人工审核后发布)
- 与企业搜索、Chatbot集成
七、实战案例:搭建大模型测评知识库
光说不练假把式,我们拿一个具体场景来看看LLM Wiki是怎么工作的。
7.1 场景背景
你是一个AI技术博主,要持续跟踪主流大模型,写测评文章。手上有这些资料:
- Grok 4.5 官方博客
- Claude Opus 4.8 技术报告
- GPT-5.5 基准测试数据
- 各模型的定价页面
- 第三方评测机构的对比报告
7.2 LLM Wiki 自动产出什么
1. 独立实体页面(每个模型一个)
Grok-4.5.md:参数规模、发布时间、架构特点、基准成绩、定价Claude-Opus-4.8.md:同上结构GPT-5.5.md:同上结构
2. 自动生成对比页面
旗舰大模型SWE-bench成绩对比.md:带表格、排名、分析大模型API价格对比.md:输入输出价格、相对成本倍数2026旗舰模型综合能力对比.md:多维度雷达图分析
3. 衍生洞察页面
大模型价格战趋势分析.md:基于价格数据自动生成的趋势观察编程能力模型选型建议.md:不同场景的模型推荐
4. 双向关联网络
- 每个模型页面都链向对比页面
- 对比页面都链向各个模型详情页
- 相关概念(SWE-bench、Token效率)自动生成词条
7.3 新资料入库会发生什么
假设你又看到了DeepSeek V4的最新评测报告,把PDF丢进raw/:
- 自动创建
DeepSeek-V4.md实体页面 - 更新所有对比页面,加入DeepSeek V4的数据
- 更新价格排名、性能排名
- 自动生成「国产大模型崛起分析」之类的新洞察页面
- 检测到与之前结论有冲突的地方,标注分歧
整个过程全自动,你什么都不用做,知识库自己进化了。
7.4 写博客时的体验
以前写测评文章:
- 打开十几个网页翻数据
- 手动整理对比表格
- 到处找基准测试分数
- 核对价格信息
- 至少花大半天
现在用LLM Wiki:
- 直接查询:「帮我整理一篇Grok 4.5的测评文章框架」
- 秒级返回,所有数据、对比、结论都现成的
- 你只需要润色和加个人观点
- 效率提升5~10倍
八、适用场景与不适用场景
8.1 强烈推荐使用的场景 ⭐⭐⭐⭐⭐
| 场景 | 为什么适合 |
|---|---|
| 个人技术知识库 | 程序员的技术沉淀、框架学习、踩坑复盘,越积累越值钱 |
| 学术研究管理 | 批量论文阅读自动综述、观点对比、实验数据长期跟踪 |
| 技术博主/内容创作者 | 素材自动整理结构化,写稿效率翻倍 |
| 小型团队知识库 | 产品文档、接口规范、业务方案自动同步更新 |
| AI Agent长期记忆 | 给Agent提供结构化的外置记忆,比向量检索靠谱 |
| 行业垂直知识沉淀 | 法律、金融、医疗等专业领域的知识体系化 |
8.2 可以用但不是最优的场景 ⭐⭐⭐
- 纯问答客服机器人:传统RAG可能更直接
- 超大规模(百万级文档):全量编译成本较高,建议RAG+Wiki混合
- 强实时性信息:新闻、股价等秒级变化的信息,RAG更灵活
- 一次性临时查询:只查一次的资料没必要编译入库
8.3 不推荐使用的场景 ❌
| 场景 | 原因 | 替代方案 |
|---|---|---|
| 简单文件检索 | 杀鸡用牛刀 | 普通搜索即可 |
| 高度敏感绝密数据 | LLM处理有泄露风险 | 纯人工管理 |
| 完全不需要结构化的素材库 | 原始文件归档就够了 | 云盘/知识库软件 |
九、常见误区与最佳实践
9.1 五大常见误区
❌ 误区1:追求100%自动化,完全不干预
真相:LLM Wiki是人机协作,不是无人值守。人类负责筛选高质量输入、定义规则、处理冲突。垃圾进垃圾出,原始资料质量决定了Wiki的上限。
❌ 误区2:什么东西都往里塞
真相:不是所有资料都值得编译入库。只把有长期价值的核心资料放进Wiki,临时信息、垃圾信息会稀释知识库质量。
❌ 误区3:一开始就追求大而全
真相:从小范围开始,先围绕一个主题建起来,跑通流程,再逐步扩展。上来就塞几百份资料,质量会很差。
❌ 误区4:频繁修改Wiki页面内容
真相:尽量不要直接手改Wiki页面。正确做法是修改原始资料或者更新Schema,然后重新执行入库,让LLM来更新Wiki。否则下次入库会被覆盖。
❌ 误区5:LLM Wiki必须用最强的模型
真相:入库编译可以用好模型(保证质量),日常查询可以用便宜模型(降本)。不需要全程都用GPT-5级别的模型。
9.2 七条最佳实践
✅ 从一个垂直领域切入 :比如先搞「大模型测评」这个主题,跑通了再扩展
✅ 严格区分原始层和知识层 :永远不要直接在wiki/里手动大改
✅ 建立入库审核机制 :重要内容人工审核后再正式入库
✅ 定期执行Lint巡检 :每周跑一次,保持知识库健康
✅ 善用双向链接 :这是Wiki的灵魂,链接越多知识网络越强
✅ 保留完整溯源 :每条结论都能找到原始出处,避免幻觉
✅ 用Git做版本管理:所有变更可追溯,出问题可以回滚
十、未来展望:LLM Wiki 会走向何方
10.1 短期趋势(1年内)
- 工具爆发:会出现大量LLM Wiki相关的工具、插件、SaaS产品
- 编辑器原生集成:Obsidian、Notion、VS Code会原生支持类似功能
- 多模态支持:从纯文本扩展到图片、表格、公式、代码
- 协作功能:多人协作编辑、权限管理、评论审核
10.2 中期趋势(2~3年)
- Agent原生支持:AI Agent直接在Wiki上工作,自主研究、更新、维护
- 知识市场:高质量的垂直领域Wiki可以直接交易、订阅
- 联邦知识网络:多个Wiki之间互联互通,形成分布式知识网络
- 自动研究Agent:给一个研究课题,Agent自动找资料、更新Wiki、产出报告
10.3 长期想象
如果LLM Wiki这个范式跑通了,它可能会成为:
- 人类的第二大脑基础设施:每个人都有自己持续增长的外置知识库
- AI时代的「图书馆」:结构化、互联、可推理的数字知识基础设施
- 科学研究的加速器:自动跨领域关联知识,加速新发现的产生
🎯 总结:LLM Wiki 是范式升级,不是工具迭代
最后总结一下全文的核心观点:
- LLM Wiki不是又一个RAG框架,而是一种全新的知识管理范式------从「查询时临时检索」变成「入库时预编译沉淀」
- 它的核心价值是知识复利:每一份新资料都在让整个知识库变得更好,而不是简单的线性叠加
- 它不替代RAG,而是互补:Wiki管核心高频知识,RAG管长尾临时需求
- 落地门槛极低:纯Markdown + 任意LLM就能跑起来,每个人都可以试试
- 这可能是AI Agent时代的标配基础设施:Agent需要结构化的长期记忆,LLM Wiki是目前最合理的方案
大模型发展到今天,模型本身的能力差距正在缩小。下一个竞争高地,是如何更好地管理和利用知识。
LLM Wiki给出了一个很有想象力的答案。至于它能不能成为下一代知识管理的标准,我们拭目以待。
但有一点可以确定:从「解释器范式」到「编译器范式」的这个思路转变,值得每一个做AI应用的人认真思考。
📚 参考资料
- Andrej Karpathy - LLM Wiki 原始提案
- llmwiki.app 官方文档
- LLM Notebook 开源项目文档
- Artificial Analysis - RAG vs Structured Knowledge 对比报告
- Obsidian 官方博客 - AI时代的笔记进化方向
声明:本文基于2026年7月公开信息整理,LLM Wiki作为新兴概念仍在快速演进中,相关工具和最佳实践可能会持续更新。
如果觉得这篇文章对你有帮助,欢迎点赞、收藏、关注三连!有任何问题也欢迎在评论区交流~