一、问题:从一次偶发超时说起
你有没有遇到过这种情况:应用报 Redis 超时,你吭哧吭哧去查 Redis 监控、GC 日志、慢查询------结果 Redis 一切正常。再查网络、查连接数、查防火墙------也都好好的。问题在哪?不知道,反正"不是我的问题"。
今天要讲的这个 case,就遇到了同样的困惑。不过最后挖出来的根因很有意思:既不在 Redis,也不在网络,而是在 CPU 的一颗核上。
在 docker97.xxx.qihoo.net 这个节点上,部分 Pod 访问 Redis 时出现了偶发超时,具体表现为:
• 应用日志 里 Redis 请求 RT 偶发拉长,甚至直接超时
• 非持续性 ,重试后往往恢复,但时不时又冒出来
• Redis 服务端本身没有任何异常------CPU、连接数、QPS 都正常
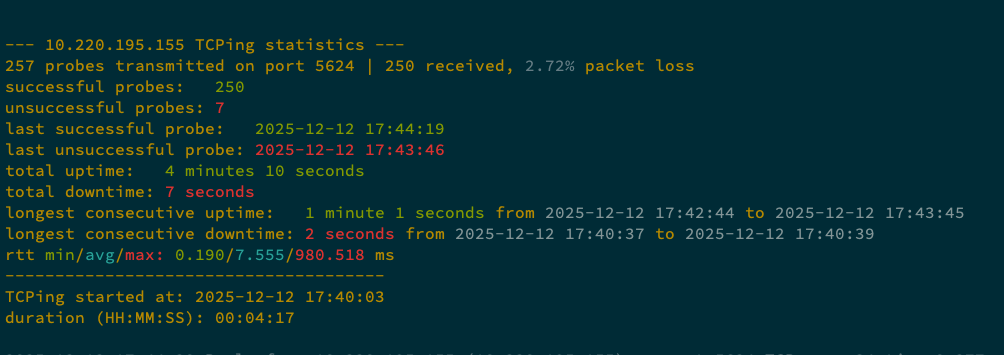
从表象看,这不像典型的应用 Bug,也不像 Redis 性能瓶颈。更像是某种底层系统抖动。
二、验证:网络层面排除了什么
先确认网络是否真的稳定。在 Pod 网络命名空间里直接验证:
nc -z -v 10.220.193.137 25747
结果很有意思:大多数时间完全正常,少数几次连接建立明显变慢。
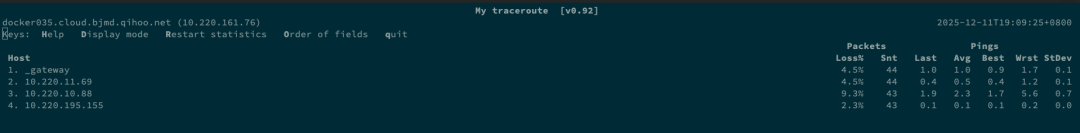
阶段性结论:不是典型网络链路故障。更像是节点侧处理能力不稳定。
三、转向:换个角度重新看
当 "应用无明显异常 + 网络不稳定但无硬性丢包" 同时出现时,应立刻警惕:
⚠️ CPU / 中断 / 软中断(softirq)层面的处理能力问题
尤其是 Redis 这种高频短连接、高频网络 IO 的场景,对软中断调度延迟极其敏感------数据包到了网卡,但 CPU 什么时候来处理它,这里面的不确定性就会直接转化为请求延迟。
四、深入:软中断的追凶之旅
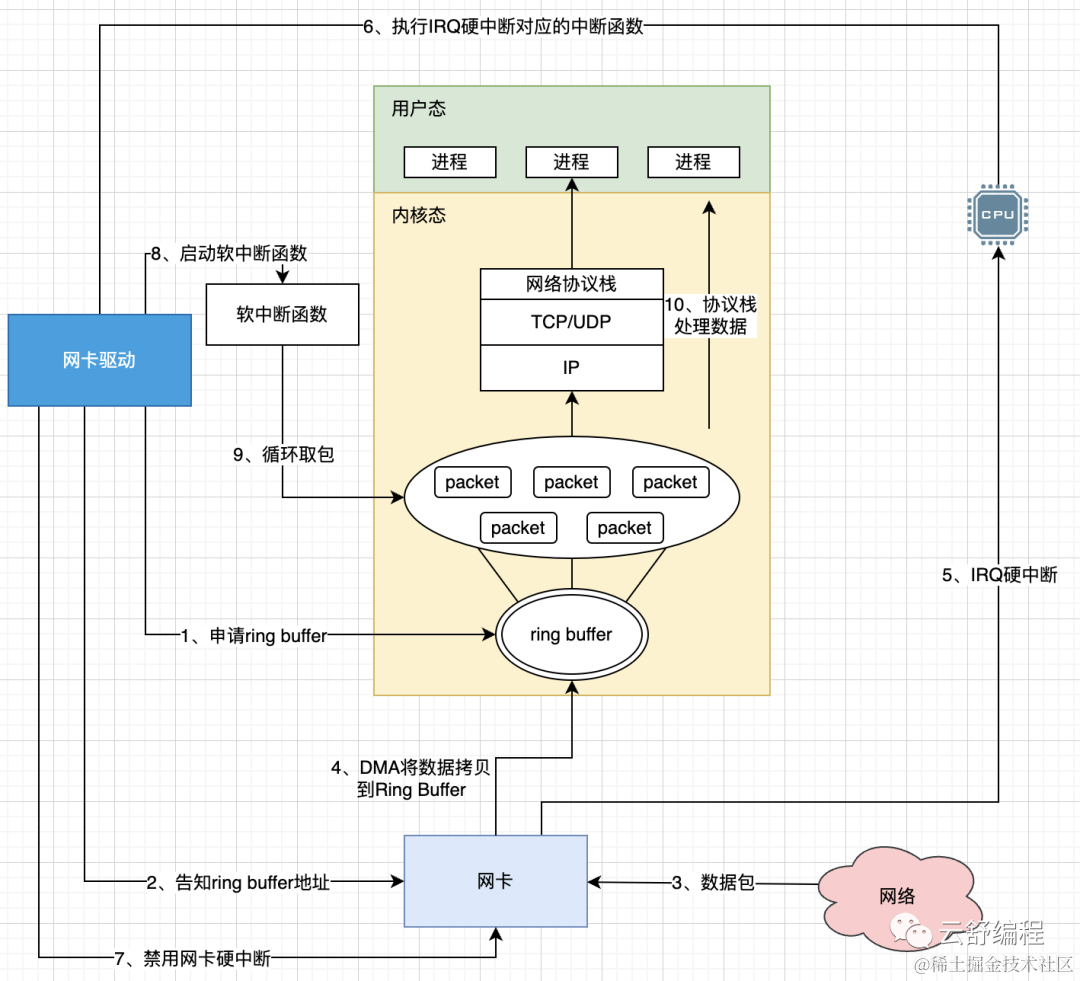
- CPU 和中断全景观察
先用 mpstat 看全局 CPU 状态:
mpstat -P ALL 1
mpstat -I SCPU 1 5
发现:个别 CPU 核的 %soft(软中断占用)明显偏高,软中断在 CPU 间分布极不均匀。
再看中断分布:
cat /proc/interrupts | less -S
cat /proc/softirqs | less -S
top --> 1
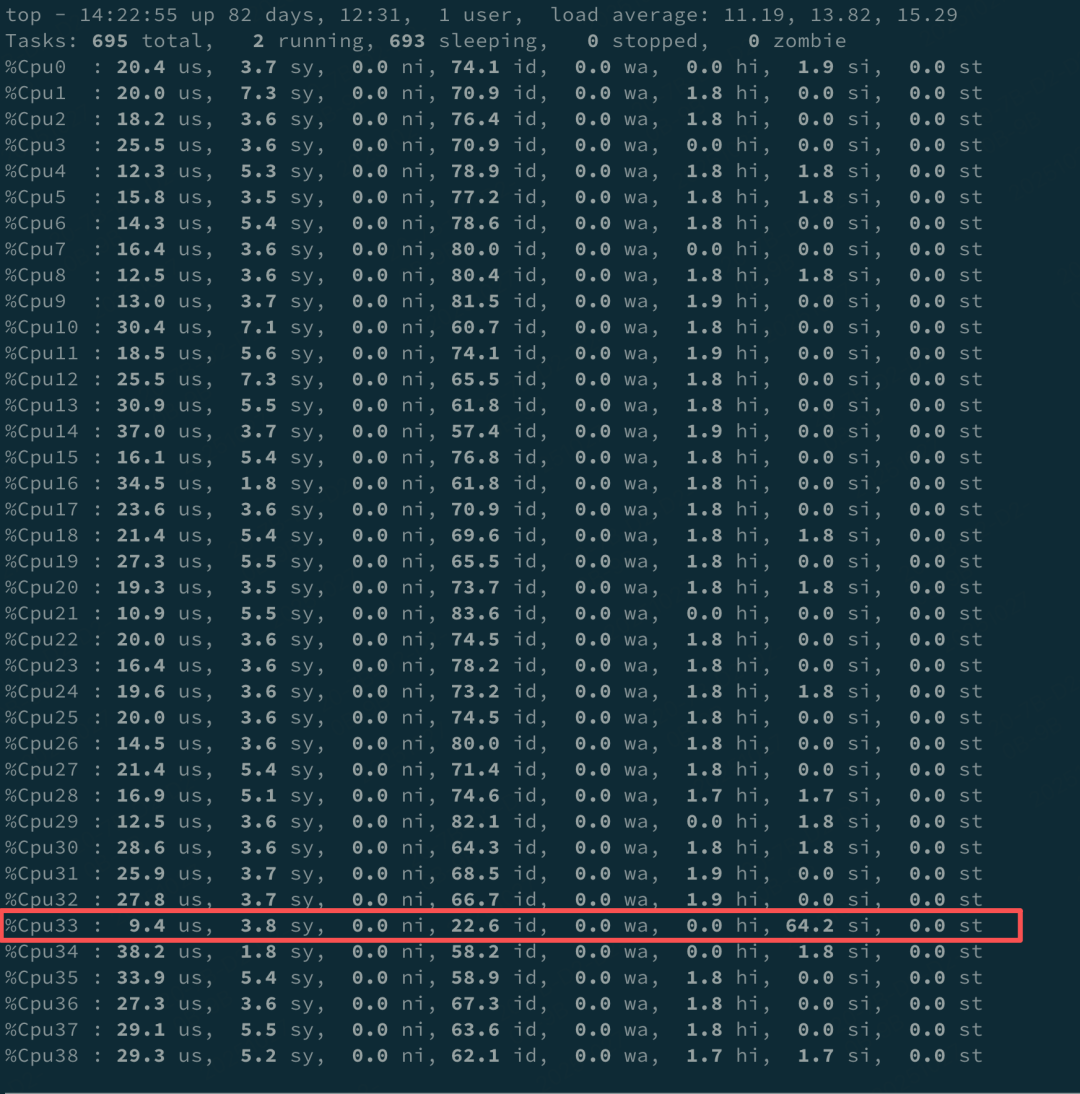
进一步统计每个 CPU 的中断总量:
awk '{for(i=2;i<=NF;i++)ai+=$i} END{for(i in a)print "CPU"i-2":",ai}' /proc/interrupts
发现:网络相关 IRQ / softirq 明显集中在少数 CPU
- 网卡与 NUMA 拓扑关系
先确认网卡型号和 PCIe 信息:
ethtool -i eth2
driver: ixgbe
version: 5.10.134-14.an8.x86_64
firmware-version: 0x80000625
bus-info: 0000:84:00.0
#lspci -vvvs 0000:84:00.0
#查看网口绑定的NUMA node编号
cat /sys/class/net/eth2/device/numa_node
#查看网卡队列与CPU绑核关系
grep . /proc/irq/*/smp_affinity_list
查网卡挂载的 NUMA 节点:
cat /sys/class/net/eth2/device/numa_node
#确认:网卡挂载在 NUMA Node 0
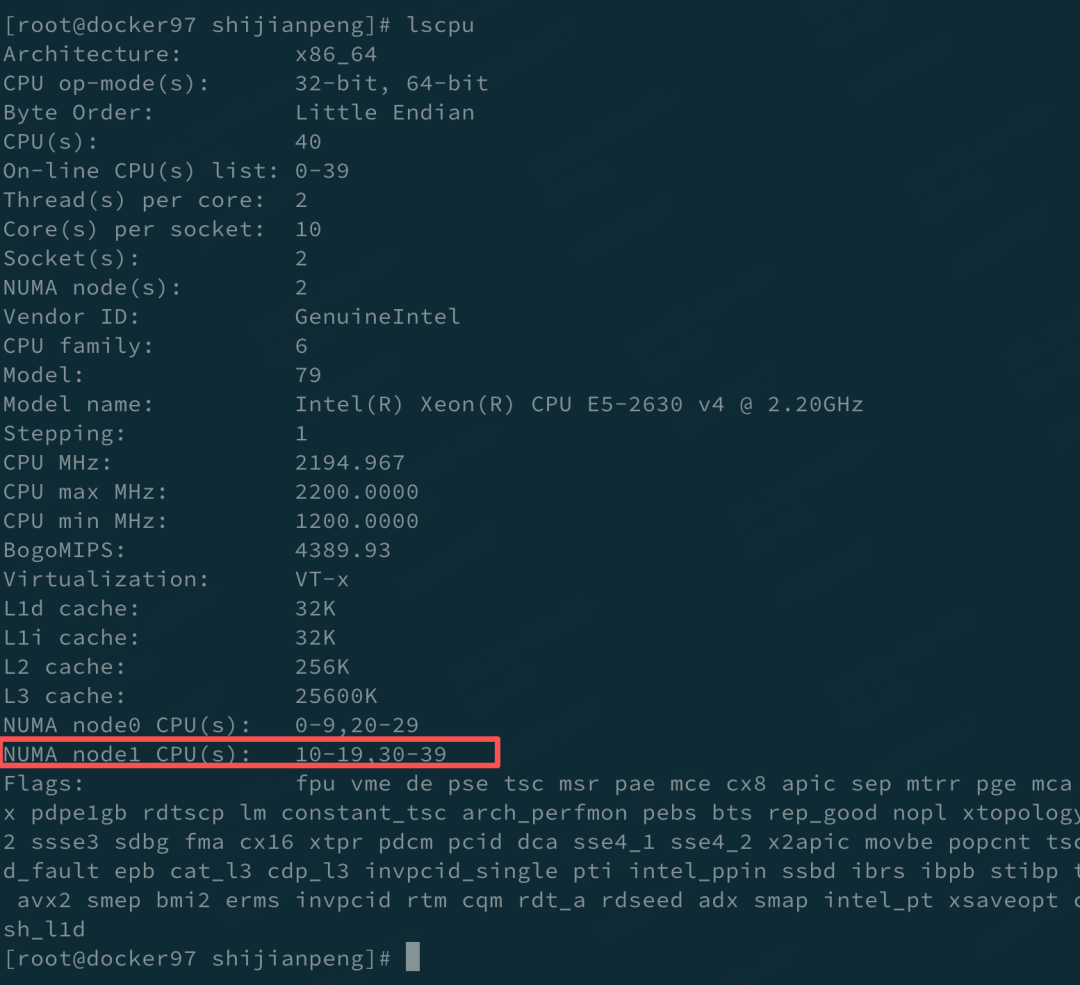
关键背景 :如果中断 / 软中断跑在非本 NUMA 节点的 CPU 上,会引入远端内存访问,直接造成延迟抖动。
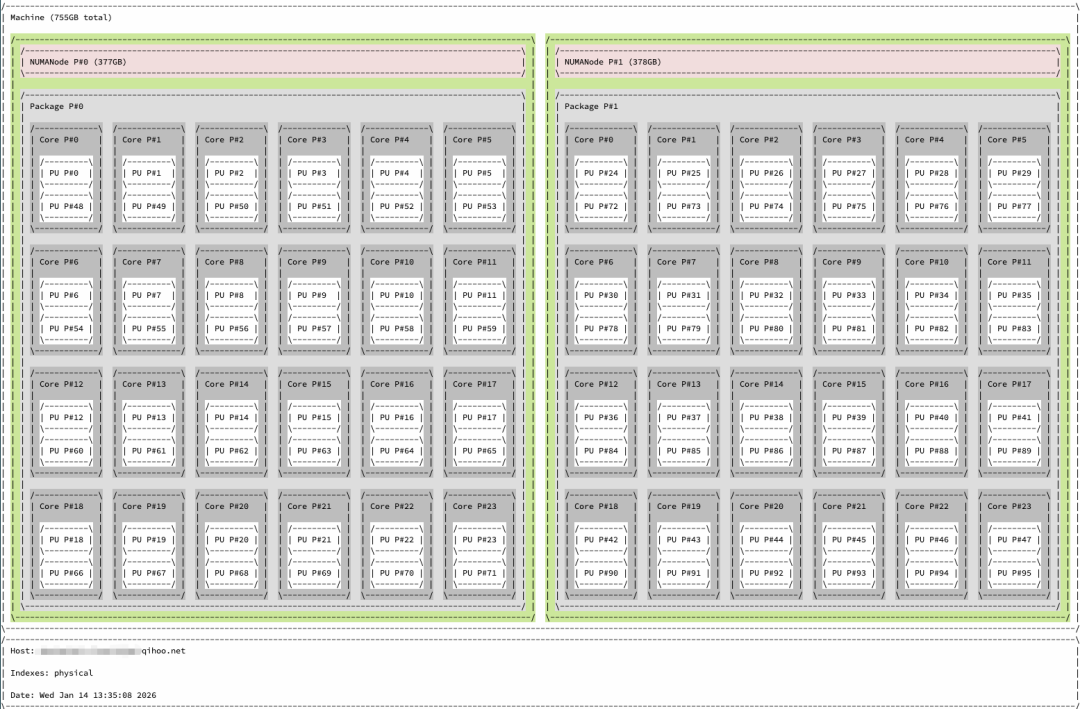
#用 lstopo 可以生成完整的 NUMA + PCIe 拓扑图
yum install -y hwloc hwloc-gui
生成带网卡的完整 NUMA + PCIe 拓扑图
sudo lstopo --whole-system --whole-io --rect --fontsize 9 --gridsize 8 /root/topo.svg
- irqbalance------这个"老好人"闯了祸
irqbalance(中断均衡服务)是 Linux 默认用来动态迁移中断的工具。它的工作逻辑是:周期性读取 /proc/interrupts,然后把中断尽量"平均地"调度到各个 CPU 上。听起来很合理对吧?
但问题来了:
在高吞吐、低延迟场景(尤其是 Redis / RPC)下,中断的"漂移"反而会带来:
• Cache Miss :每次迁移,CPU 缓存失效
• NUMA 远程访问 :中断飘到远端 NUMA 节点的 CPU,需要访问远端内存
• 软中断处理延迟:数据包在网卡队列里等待被处理的时间变得不可控
这本质上是"稳定性优先 vs 吞吐优先"的经典冲突。
systemctl status irqbalance
五、根因:一起"冤案"的真相
**根因不是 Redis,也不是应用,而是:**网络中断 & 软中断亲和性不合理
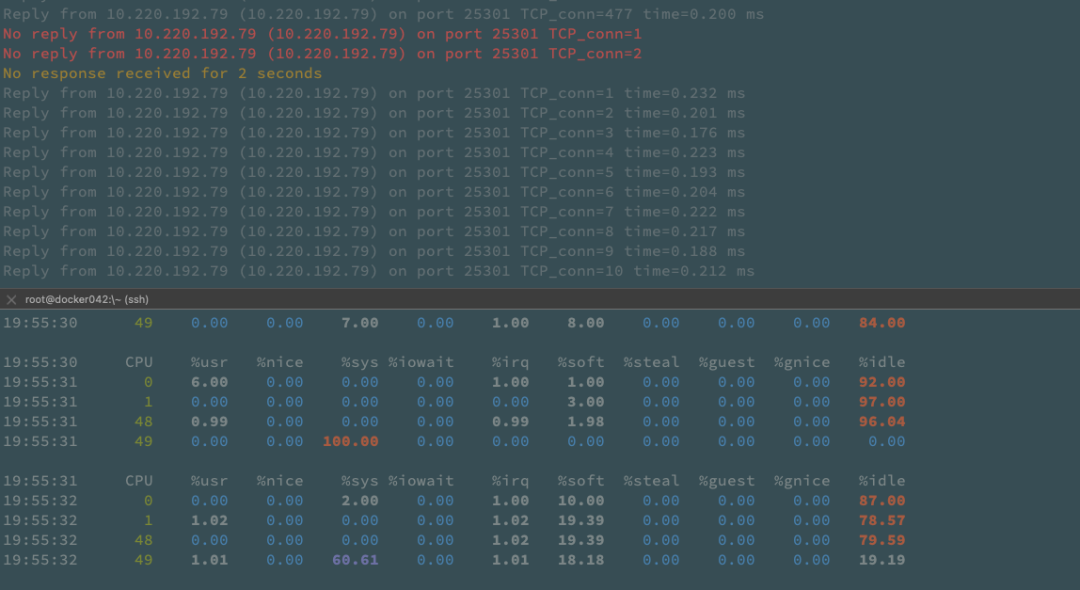
具体路径是这样的:
多队列网卡 + irqbalance 自动迁移
→ 中断分布跨 NUMA 节点
→ 软中断(NET_RX)集中 + 处理延迟
→ Pod 网络请求被"卡在内核里"
→ 应用层:Redis 请求偶发超时
六、解决方案:对症下药
设计原则:中断处理要稳定而不是"平均",IRQ / softirq / CPU / NUMA 必须协同,网络 IO 属于基础设施级负载,优先级要高。
方案一:调整网卡队列数(对齐 NUMA)
ethtool -L eth0 combined 20
目的:队列数 ≈ NUMA Node0 CPU 数,避免队列跨节点调度
方案二:增大网卡 Ring Buffer
ethtool -G eth0 rx 2048 tx 2048
目的:增强突发流量承载能力,减少 RX 丢包 / 回压
方案三:改变 irqbalance 绑核策略
1、先停掉服务
systemctl stop irqbalance
2、改用NUMA 感知的 IRQ 绑核
绑核效果 cat /etc/sysconfig/irqbalance
IRQBALANCE_BANNED_CPUS=3fffffff,ffff3fff,ffffffff
3、开启服务
systemctl start irqbalance
配置 koordinator 调度,预留核数不被业务占用
kubectl get node -o json | jq -r '
.items\[\]
| [.metadata.name,
(.metadata.annotations"node.koordinator.sh/reservation" // "")]
| @tsv
'| grep "docker042.cloud.bjmd.qihoo.net"
docker042.cloud.bjmd.qihoo.net {"resources":{"memory":"162143134516"},"reservedCPUs":"46,47,94,95"}
七、验证与方法论沉淀
效果验证维度 :
✅ Redis 访问超时消失
✅ %softirq 明显下降
✅ 中断分布稳定,不再频繁迁移
✅ Pod 网络 RT 波动显著减小
方法论沉淀 :
这不是一次"Redis 问题",而是一次系统软中断调度能力不足的问题。当你在生产环境看到以下组合时:
• 应用偶发网络超时
• Redis / MySQL 无明显瓶颈
• mtr 无稳定丢包
• CPU %soft 偏高
立刻进入 IRQ / softirq / NUMA 排查,不要在应用层和 Redis 上浪费时间。
八、尾声:经验之谈
网络延迟不一定在网络上,Redis 超时也不一定在 Redis。很多时候,问题卡在 CPU 正在"什么时候处理软中断"。
后续还有一个可以继续优化的方向:把 kubelet 和 containerd 进程也单独隔离出相应的 CPU 核数,避免它们和业务 Pod 争抢资源,进一步降低不可预期的调度抖动。
**参考文献:**https://cloud.tencent.com/developer/article/2383533