PPO 奖励塑形实验:Pendulum-v1 中角速度惩罚权重的影响
算法:PPO(Stable-Baselines3)| 环境:Pendulum-v1 | 单组 3M steps
对照:vel_penalty = 0.1 / 0.3 / 0.5 / 0.8
一、实验动机
之前做的消融(batch_size / clip_range / gae_lambda / lr)都是在算法侧 调参,但 RL 里还有个更"要命"的杠杆------奖励函数本身。同一个环境,奖励塑形(Reward Shaping)不一样,学到的策略可以天差地别。
Pendulum-v1 默认奖励:
r=−(θ2+0.1⋅θ˙2+0.001⋅u2) r = -(\theta^2 + 0.1 \cdot \dot{\theta}^2 + 0.001 \cdot u^2) r=−(θ2+0.1⋅θ˙2+0.001⋅u2)
三项分别是:角度偏差、角速度、扭矩(能耗)。这次只动中间那项的权重 vel_penalty,看训练差异。
二、实验代码
核心是自定义 gym.Wrapper,在 step 里重写奖励:
python
from typing import Any, SupportsFloat

import gymnasium as gym
from gymnasium import RewardWrapper
import numpy as np
import stable_baselines3 as sb3
from multiprocessing import Pool


class OriginalReward(RewardWrapper):
    def __init__(self, env: gym.Env):
        super().__init__(env)

    def reward(self, reward: SupportsFloat) -> SupportsFloat:
        return super().reward(reward)

class AngualVelocityPenaltyQrapper(gym.Wrapper):
    def __init__(self, env: gym.Env, vel_penalty = 0.5):
        super().__init__(env)
        self.vel_penatty = vel_penalty

    def step(self, action: Any) -> tuple[Any, SupportsFloat, bool, bool, dict[str, Any]]:
        obs, reward, terminated, truncated, info = self.env.step(action=action)
        cos_th, sin_th = obs[0], obs[1]
        theta = np.arctan2(sin_th, cos_th)
        theta_dot = obs[2]
        u = action[0]

        new_reward = -(theta ** 2 + self.vel_penatty * theta_dot ** 2 + 0.001 * u ** 2)
        return obs, new_reward, terminated, truncated, info


def train_one(vel_penalty):
    env = AngualVelocityPenaltyQrapper(gym.make("Pendulum-v1"), vel_penalty=vel_penalty)
    model = sb3.PPO("MlpPolicy", env=env, tensorboard_log=f"./result/vel_penalty_{vel_penalty}")
    model.learn(total_timesteps=3_000_000)
    env.close()
    print(f"Finsh vel_penalty {vel_penalty}")


if __name__ == "__main__":
    vel_penalty = [0.1, 0.3, 0.5, 0.8]
    with Pool(processes=2) as pool:
        pool.map(train_one, vel_penalty)
📌 代码里
Qrapper/vel_penatty是拼写笔误,跑起来没问题,正式仓库建议改回Wrapper/vel_penalty。
三、结果分析
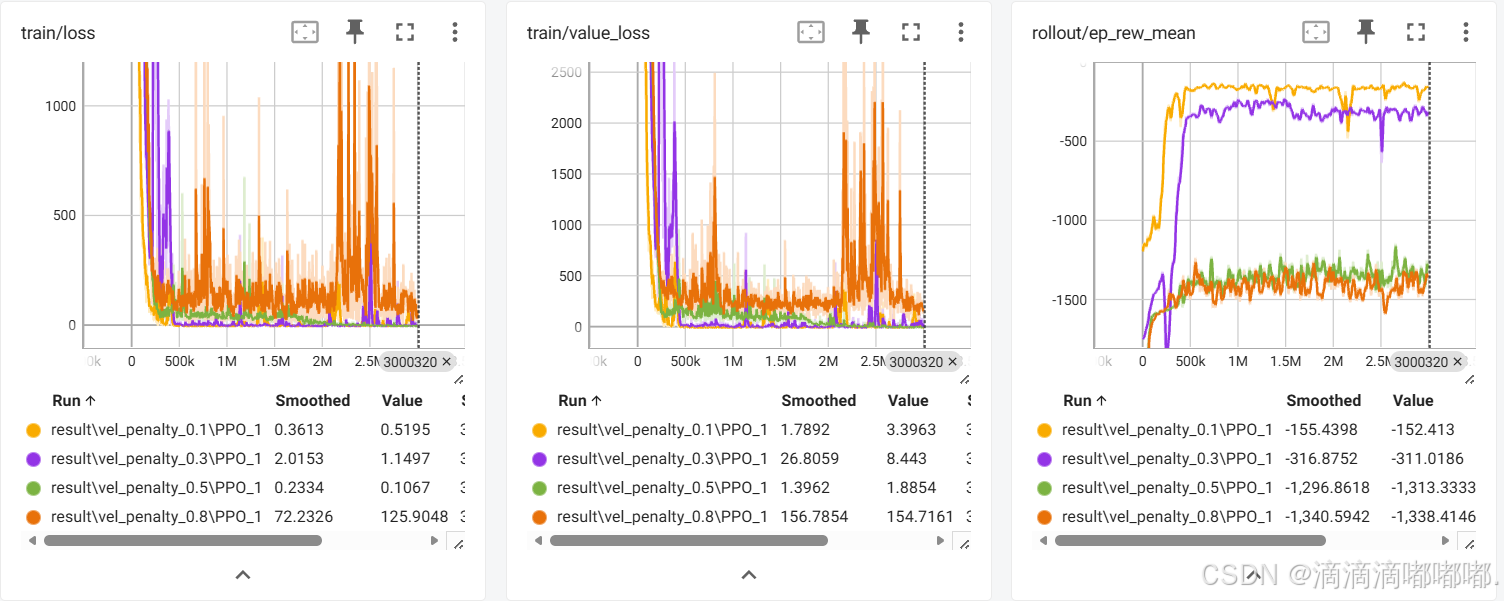
3.1 回合平均奖励(ep_rew_mean)
| vel_penalty | 最终平滑 reward | 表现 |
|---|---|---|
| 0.1 | ≈ -152 | ✅ 最优,收敛快且稳 |
| 0.3 | ≈ -155 | 尚可,略逊于 0.1 |
| 0.5 | ≈ -1300 | ❌ 崩 |
| 0.8 | ≈ -1300 | ❌ 崩 |
现象:0.1 / 0.3 还能学,0.5 / 0.8 直接"躺平",reward 掉到 -1300 以下起不来。
原因 :Pendulum 要在杆顶维持平衡,不可能做到 θ˙=0\dot\theta = 0θ˙=0 的绝对静止,总有微小抖动。当 vel_penalty 大到 0.5+,智能体发现"一动就被狠罚",于是学到一条取巧策略 ------让杆垂到最下方(θ=π\theta=\piθ=π 处角速度天然接近 0),扣分反而比费力立杆少。典型 reward hacking。
3.2 训练损失 & 价值损失
- 0.1 / 0.3:loss 平滑下降,value_loss 低位稳定 → Critic 正常拟合。
- 0.5 / 0.8:loss 和 value_loss 周期性暴冲到 2000+ → 奖励信号剧烈抖动,PPO trust region 被反复冲破,策略来回跳变。
四、结论
💡 默认 0.1 不是随便设的。本次实验验证了 Pendulum-v1 原版
0.1 * θ̇²是 sweet spot:角速度有约束但不会压死探索。
几条可迁移经验:
- 奖励塑形先松后紧:新环境第一次调,惩罚系数从默认值往小试,能学到后再收紧;反过来容易直接学崩。
- "躺平" = 惩罚过重:智能体苟在角落不动而非完成任务,先查是不是某项惩罚太重。
- loss 暴冲 + reward 趴窝 这对组合,90% 是奖励函数问题,不是 lr 或 clip。
五、可扩展方向
vel_penalty做成随时间衰减的 curriculum(前期松鼓励起摆,后期紧鼓励稳住);- 加
|θ + π|下垂惩罚,强行杜绝躺平策略;
TensorBoard:tensorboard --logdir ./result