介绍一下你的项目架构?
2023-10 ⾄ 2023-12
这个项目整体采用前后端分离架构。
后端基于:
- Spring Boot
- MyBatis
- Redis
- MySQL
- XXL-Job
构建业务服务。
前端包含:
- 若依管理后台
- UniApp医护端
- UniApp患者端
AI智能体部分采用:
- Ollama本地开源模型
- 阿里百炼大模型服务
结合RAG知识库增强和Function Calling实现业务Agent。
为什么采用Ollama+阿里百炼混合模型?
OLLAMA 隐私安全 ollama方便
阿里百炼混合模型 springAI AALBB 适配阿里百链 适配RAG 工作流 等复杂操作
如何判断请求走本地模型还是云模型?
什么是Agent?和普通Chat有什么区别?
chat无外部能力
agent可以自主思考的AI
记忆
RAG
工具
多AGENT
任务调度 -并发,重复
汇合
用户输入
↓
任务规划
↓
调用工具
↓
执行任务
↓
总结结果
Function Calling是什么?
Function Calling让大模型可以调用后端定义好的业务函数。
发送信息,携带工具
大模型 返回工具
工具调用路由调用对应工具,得到结果,组装得到回答
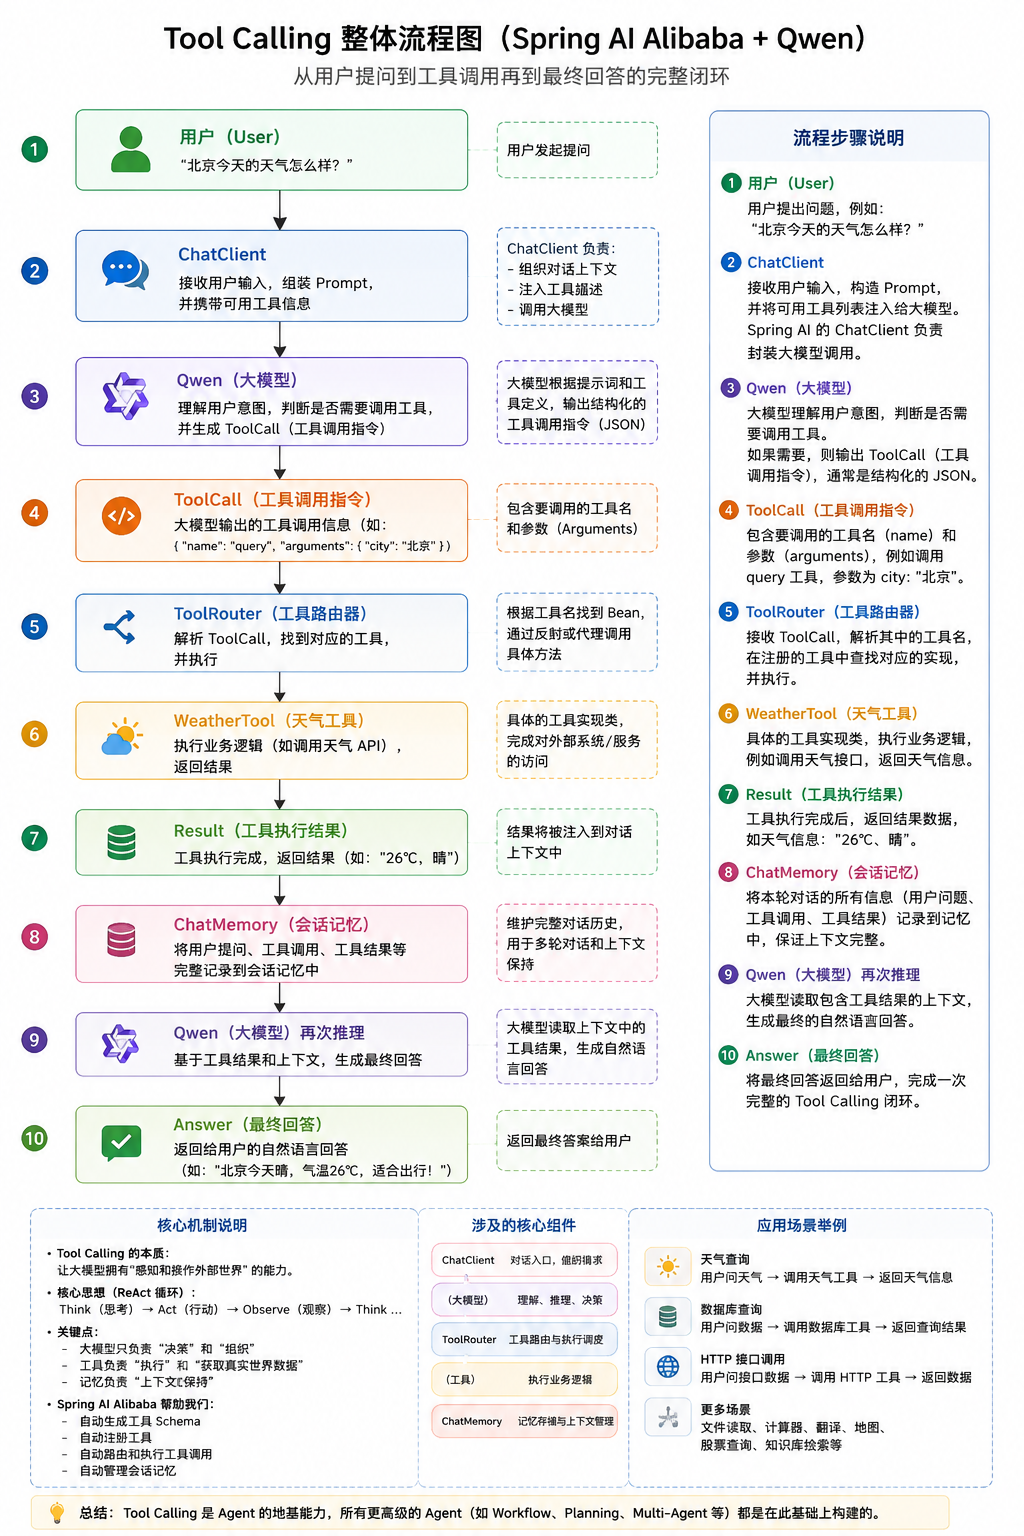
你的挂号Agent流程?
用户输入
|
Agent理解意图
|
判断是否需要工具
|
调用Function
|
查询医生信息
|
查询排班
|
创建预约
|
返回结果
queryDepartment() queryDoctor() querySchedule() createAppointment()
为什么需要RAG?
上下文无法满足,需要减轻上下文
RAG通过外部知识库增强。-知识库过滤命中、
医疗知识库:
疾病指南
药品说明
医院规则
用户:
"糖尿病饮食注意什么"
流程:
问题向量化
↓
检索相关知识
↓
拼接Prompt
↓
LLM回答
RAG具体流程?
离线阶段:
医疗文档
|
文本切片
|
Embedding模型(文本意图理解)
|
生成向量
|
保存向量数据库
用户问题 | Embedding| 向量检索 |
TopK相关内容
| Prompt增强
| LLM生成
为什么需要文本切片?
数据太长,匹配精确度下降,切片后进行向量化(向量模型)
问题匹配精度下降。
所以:
例如:
10000字文档
切:
500~1000字chunk。
每个chunk生成独立向量。
如何提高RAG准确率?
回复优化 -增加命中
es优化 再次增加命令
选取好用的向量模型
AI自行判断是否足够
重排序
XXL-Job如何实现RAG增量更新?
每天定时任务扫描数据。