🔥 星光编译者 · 个人主页
📚 学习专栏: 《C/C++ 成长笔记》 · 《Linux 实践手册》 · 《数据结构与算法》
🌄 向云端飞扬,编译属于自己的代码星河。
☕ 写在开篇
你好,这里是 星光编译者。
这里记录我在 C/C++、Linux、数据结构与算法 学习中遇到的真实问题、亲手验证过的代码,以及那些容易被忽略的实现细节。
比起简单罗列结论,我更愿意从问题出发,把一个知识点的来由讲清楚,把"为什么会这样"和"应该怎样解决"说明白,让每一次踩坑都沉淀成可以复用的经验。
如果这篇记录能帮你少绕一点路,或让某个模糊的地方忽然变得清晰,那么这次分享便有了意义。愿我们在一次次阅读、编译与调试中稳步向前,慢慢搭起属于自己的技术世界。
🔥 本文定位 :从"位模式 + 类型解释"出发,串起整数补码、大小端字节序、
char的有无符号性、无符号回绕以及 IEEE 754 浮点表示,并逐题拆解课程中的典型代码。💡 学习目标:能手算常见整数与浮点数的位模式;能画出多字节对象在大端、小端机器上的字节排列;能识别整数提升、格式串不匹配、无符号死循环、指针截断和别名规则风险。
📌 平台约定 :除非特别说明,例题沿用课程常见环境:
CHAR_BIT == 8、sizeof(int) == 4、有符号整数采用二进制补码、浮点数采用 IEEE 754 binary32/binary64。涉及实现定义或未定义行为的地方会单独标出。
文章目录
- 一、先建立统一视角:内存只保存比特
- 二、整数为什么以补码形式保存
- [三、同一个字节:signed、unsigned 与整型提升](#三、同一个字节:signed、unsigned 与整型提升)
- 四、大小端:多字节对象怎样排列
- 五、课程整型与地址练习完整解析
- 六、浮点数不是"带小数点的整数"
- [七、IEEE 754 的存入过程](#七、IEEE 754 的存入过程)
- [八、IEEE 754 的取出过程与特殊值](#八、IEEE 754 的取出过程与特殊值)
- 九、同一串比特为什么会得到两个答案
- 十、稳定解题流程、高频问答与练习
- 总结
一、先建立统一视角:内存只保存比特
变量在源代码里拥有名字和类型,内存本身却只保存一串二进制位。下面两行代码都可能占用 4 个连续字节:
c
int   i = 9;
float f = 9.0f;
但它们写入的位模式完全不同。在常见 32 位 int 与 IEEE 754 binary32 环境中:
text
int   9     → 0x00000009
float 9.0f  → 0x41100000
分析"数据在内存中如何存储"时,至少要分清四个层次:
- 值 :数学意义上的
9、-25、0.5; - 类型 :
int、unsigned char、float; - 对象表示:这个类型用哪些比特表示该值;
- 字节排列:对象超过一个字节时,各字节落在哪些地址上。
例如 0x11223344 是一个数值写法,44 33 22 11 是它在常见小端机器中从低地址到高地址的字节排列。两件事不能混为一谈。
同理,把 int 的地址强制转换成 float * 并不会把整数数值转换成浮点数;它只是要求程序把原有比特换一套规则解释,而且还可能违反 C 的有效类型与别名规则。
这一讲所有题目的主线都可以压缩成一句话:
先确定位宽与位模式,再根据类型和读取规则解释,最后检查这次读取在 C 语言里是否合法。
二、整数为什么以补码形式保存
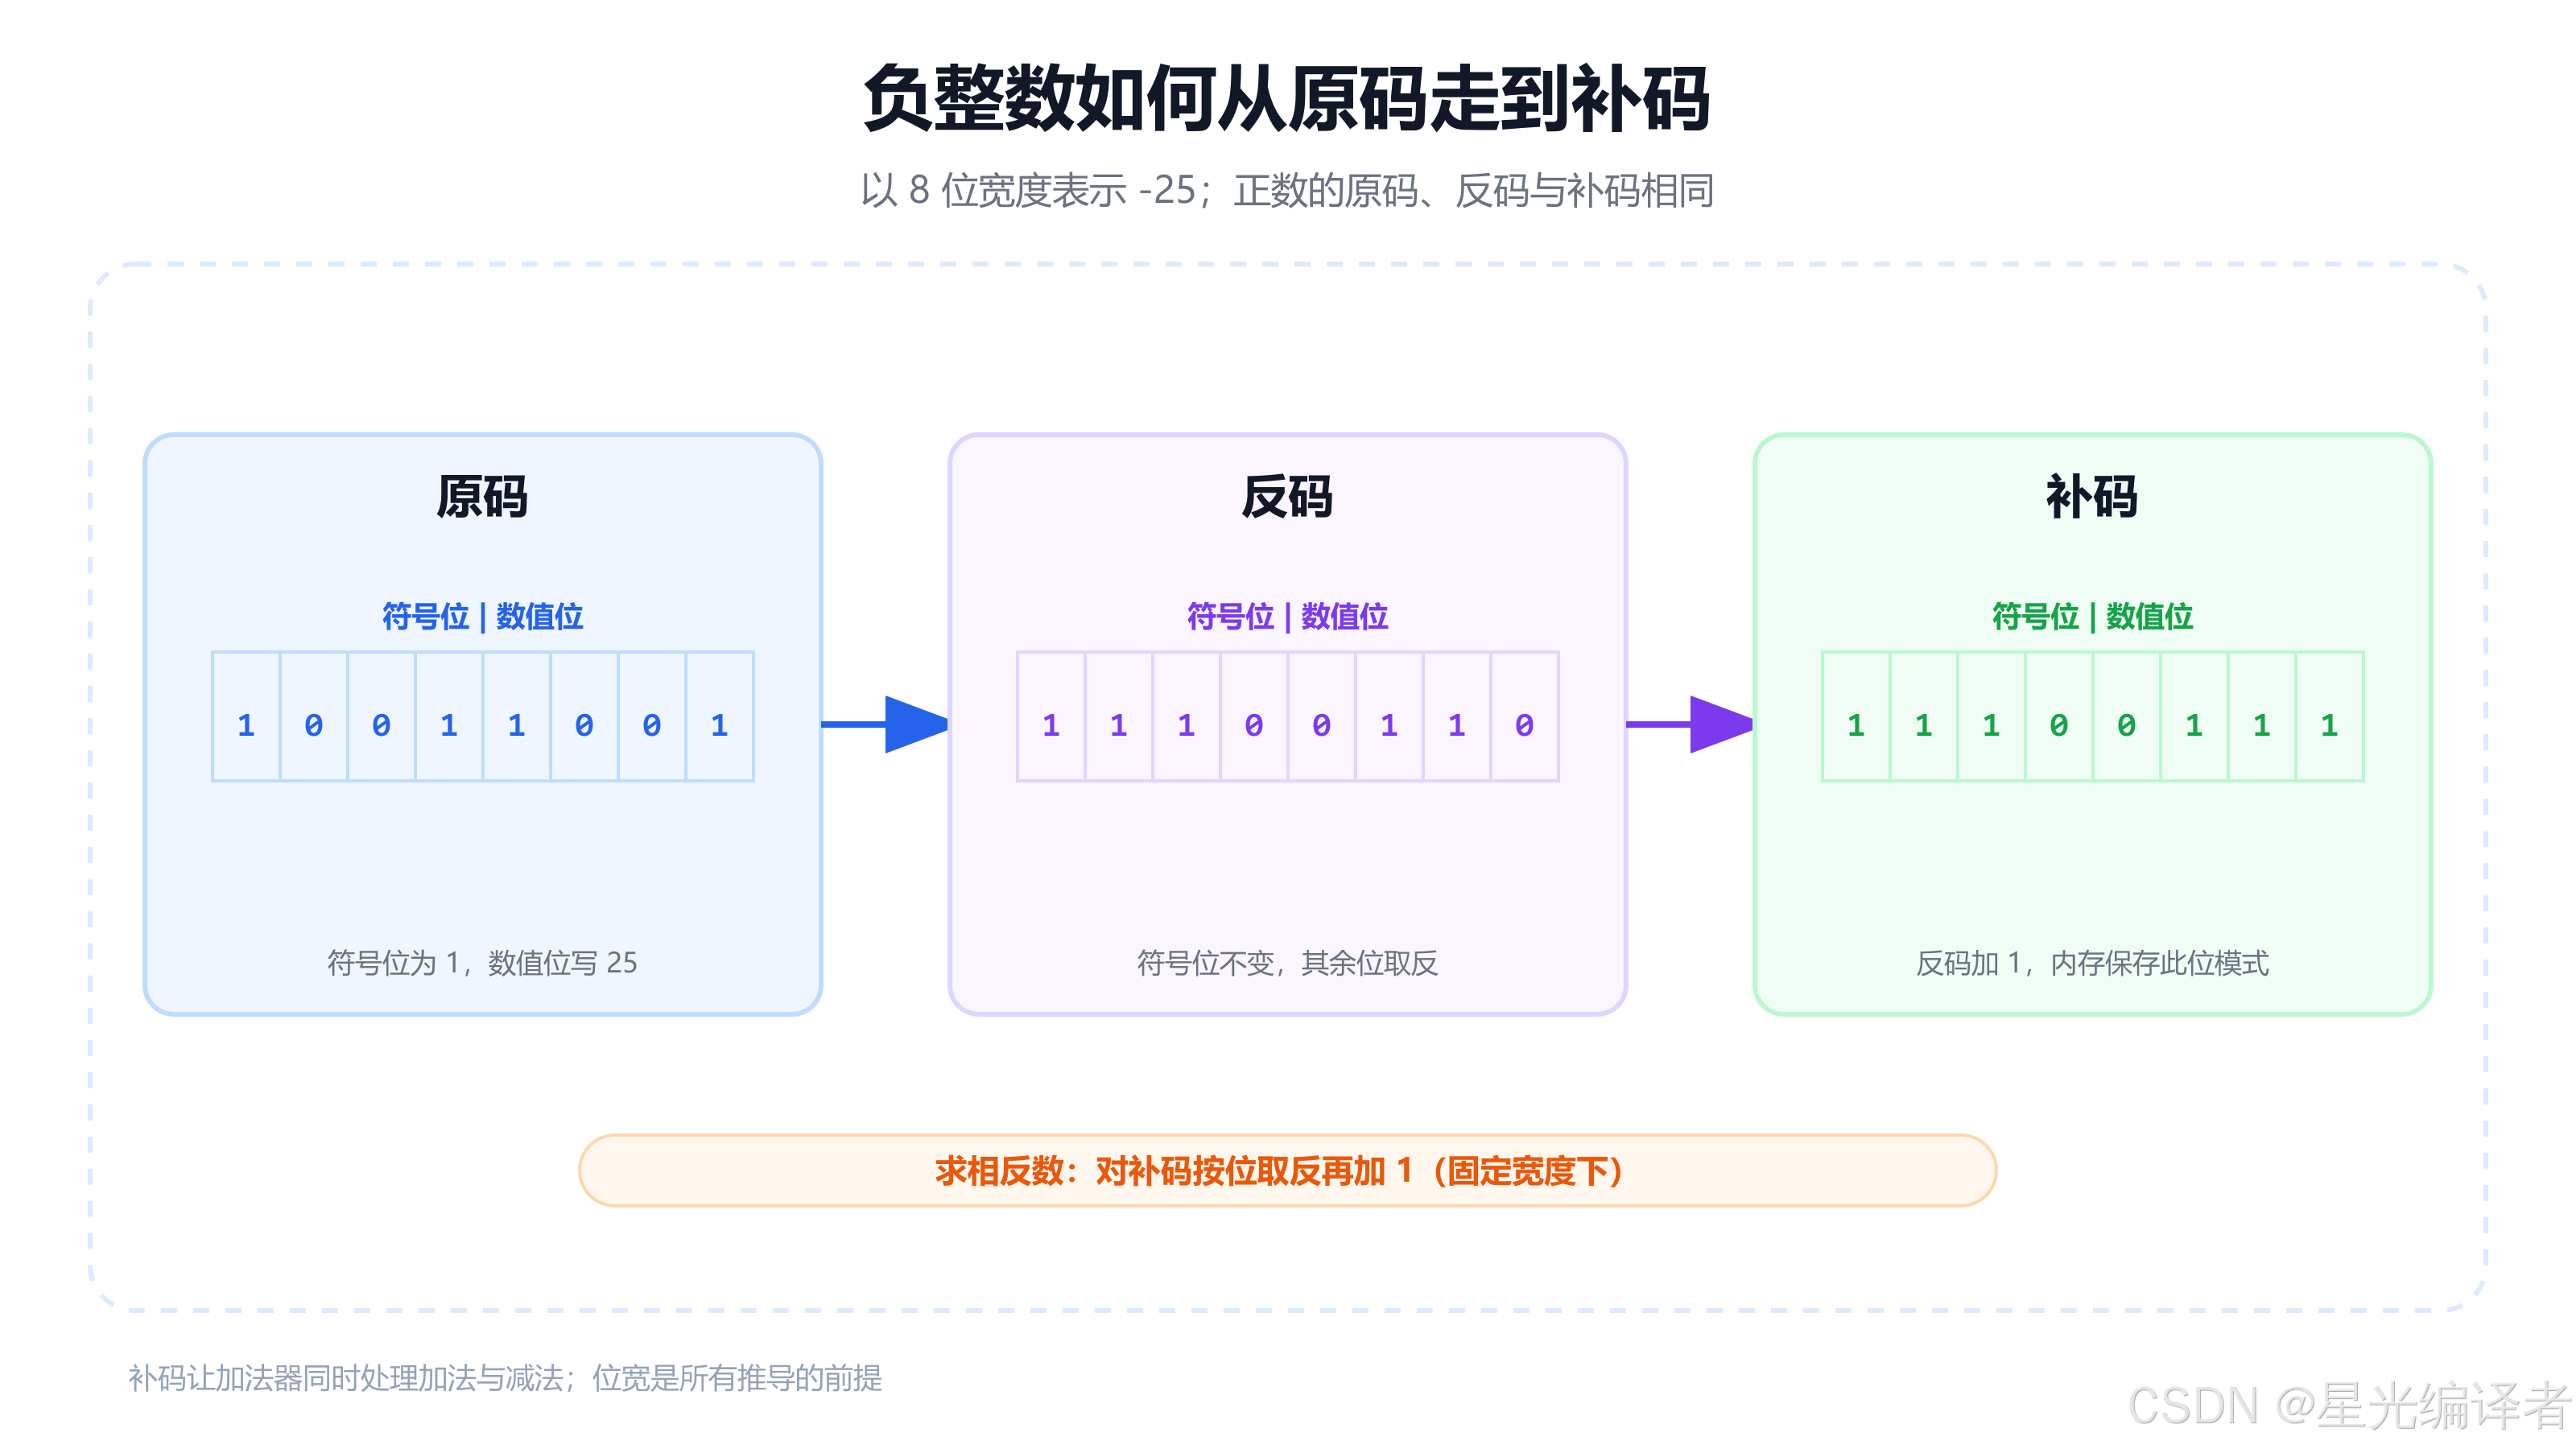
2.1 原码、反码和补码
以 8 位宽度表示 -25。先把 25 写成二进制:
text
25 = 00011001₂三种编码分别为:
text
原码:10011001
反码:11100110
补码:11100111
计算步骤如下:
- 原码最高位为符号位,负数写
1,其余 7 位保存绝对值; - 反码保持符号位不变,其余位按位取反;
- 补码等于反码加
1。
对于正数,原码、反码和补码相同。课程以及现代主流平台讨论整数内存表示时,实际关注的是补码位模式。
2.2 补码解决了什么问题
如果把符号和数值完全分开处理,硬件需要为加法、减法以及符号规则准备更多逻辑。补码让固定宽度的减法能够转化为加法。
以 8 位为例,计算 5 + (-3):
text
  00000101   // 5
+ 11111101   // -3 的补码
-----------
1 00000010
最高位之外的进位被丢弃,留下 00000010,正好是 2。
这种统一并不意味着可以随意溢出。对 C 程序而言:
- 无符号整数运算按模
2^N进行,回绕是规则的一部分; - 有符号整数溢出属于未定义行为,不能简单照搬"丢弃最高位"的硬件现象;
- 位宽不同,同一个数的补码长度也不同,推导前必须先确定类型宽度。
2.3 从补码还原负数
看到 11100111,如果已经知道它是 8 位有符号补码,可以按"按位取反再加 1"求出绝对值:
text
11100111  按位取反 → 00011000
00011000  再加 1   → 00011001 = 25
最高位为 1,所以结果为 -25。
注意:同样的 11100111 若按 unsigned char 解释,结果则是 231。位模式没有改变,改变的是解释类型。
三、同一个字节:signed、unsigned 与整型提升
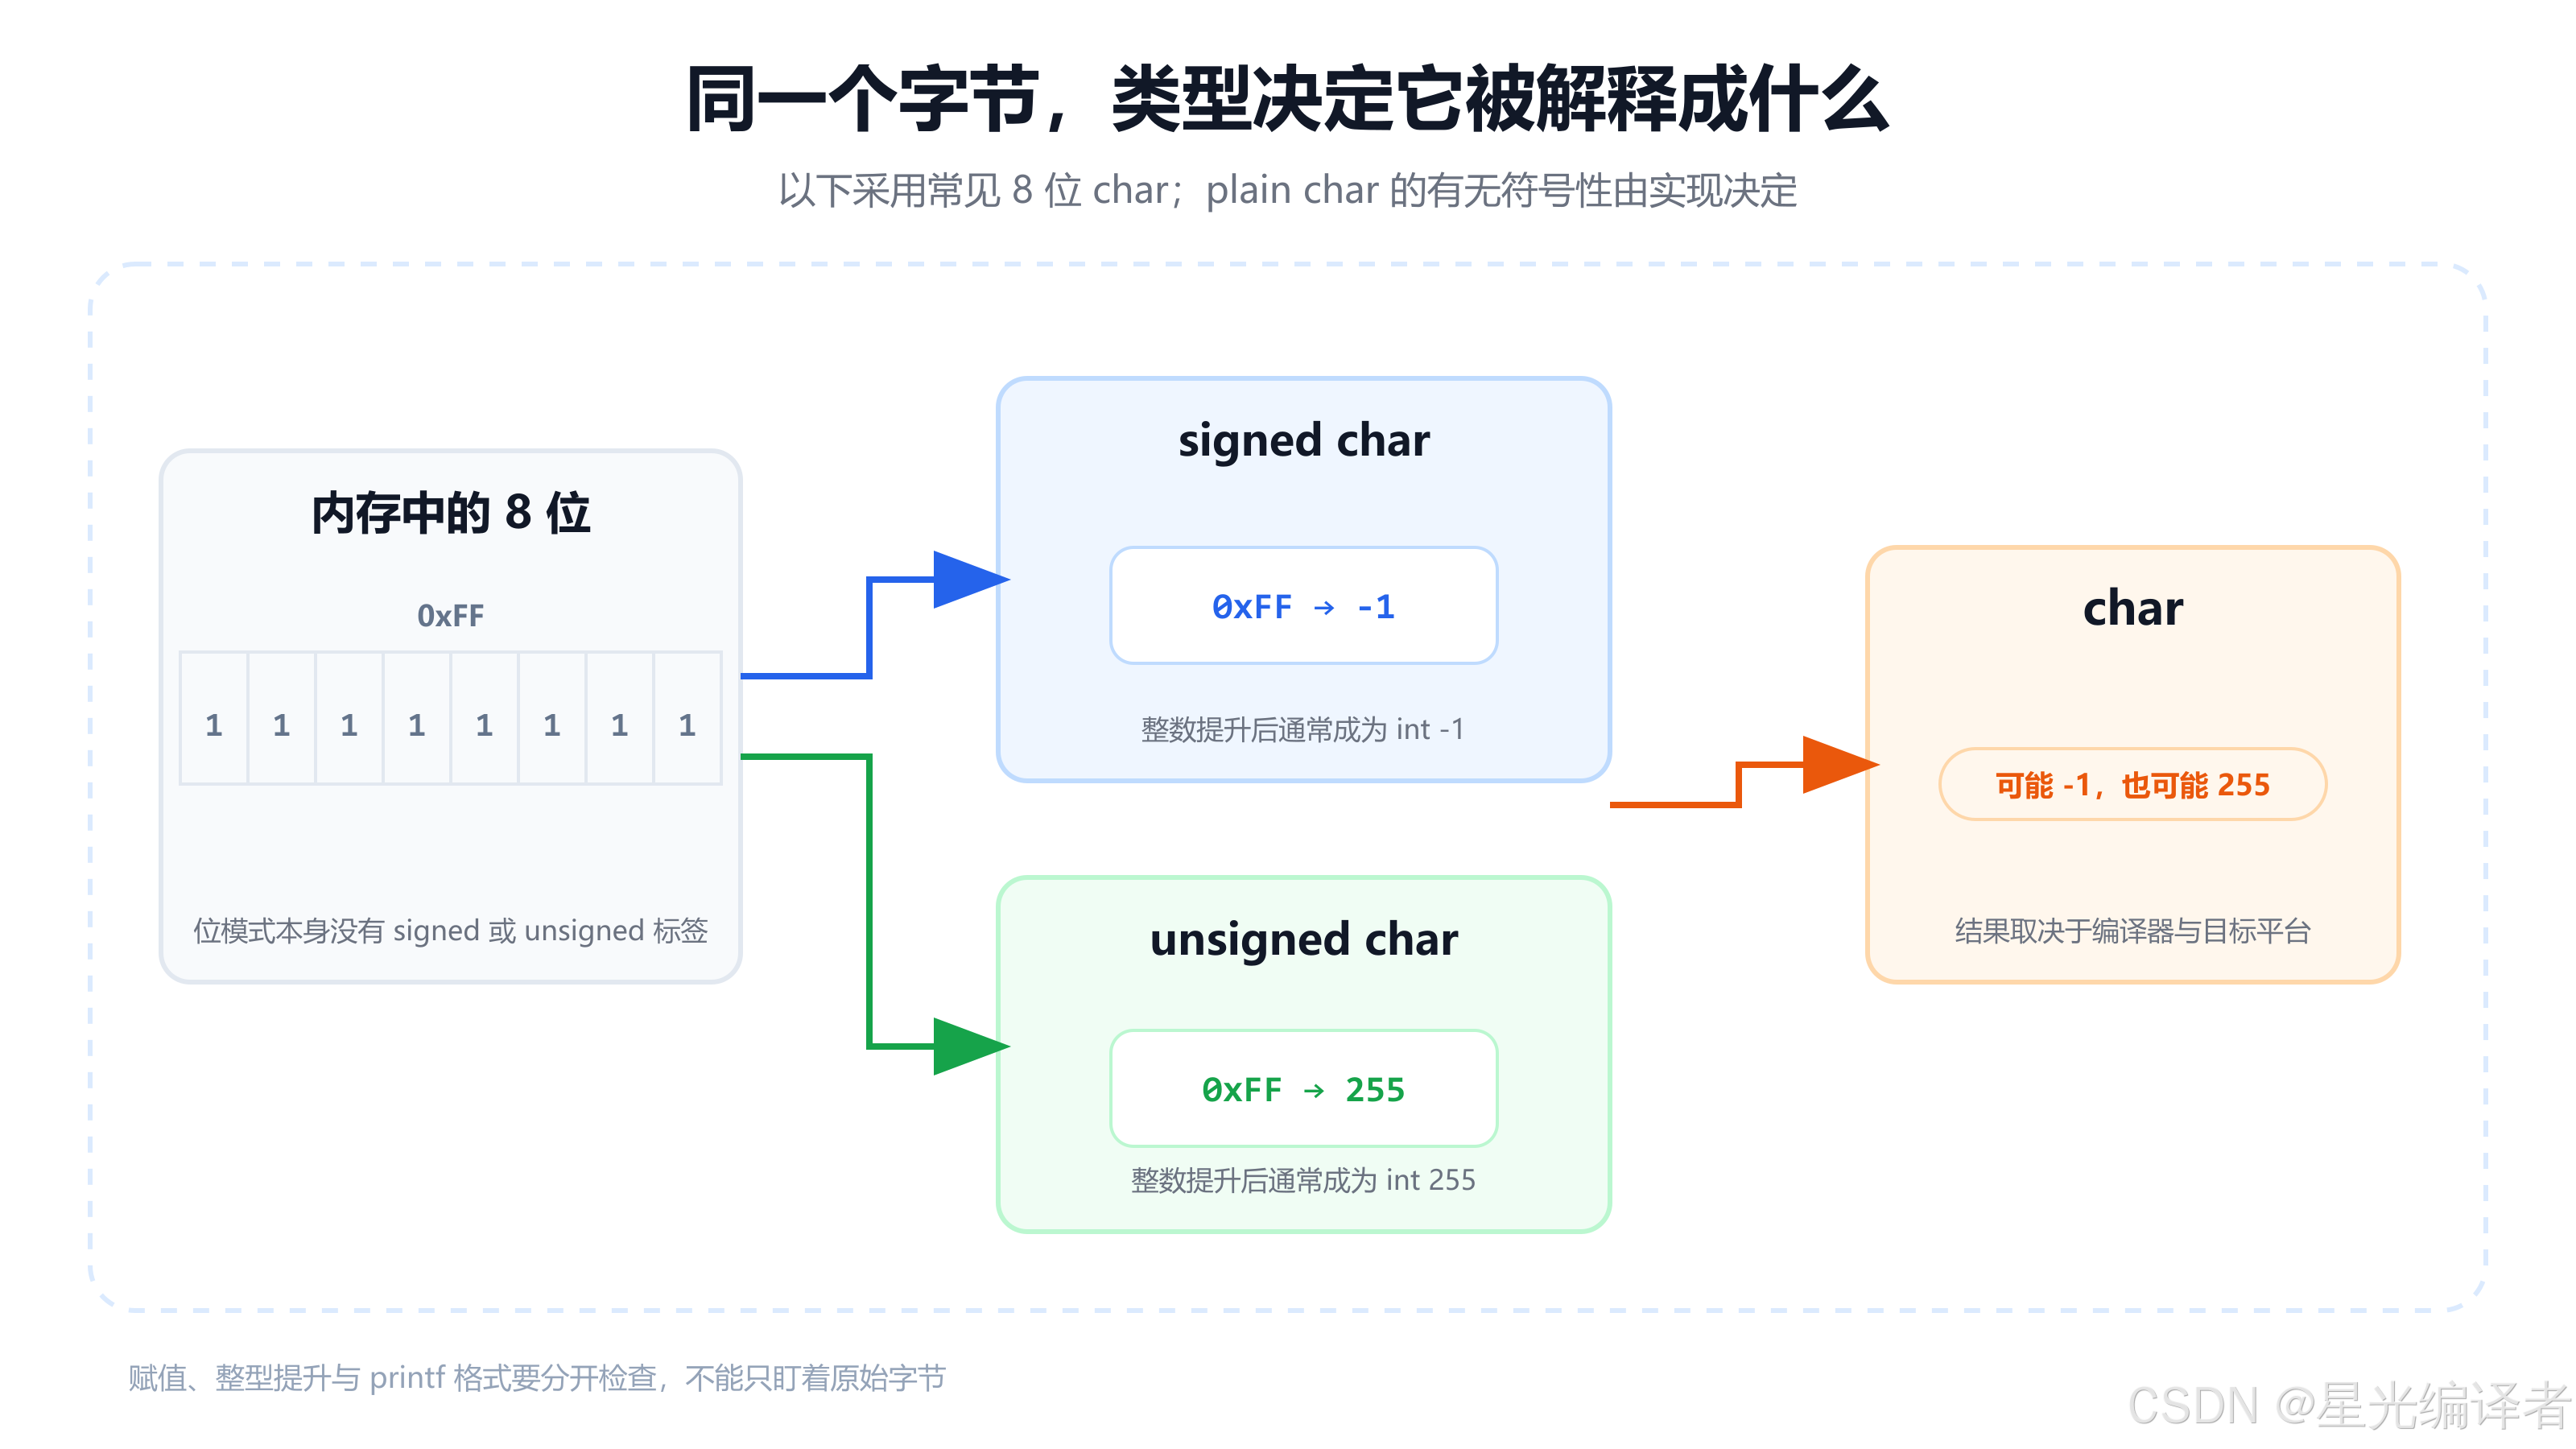
3.1 char、signed char、unsigned char 不是一回事
C 语言规定 char、signed char 和 unsigned char 是三种不同类型。char 与其中哪一种具有相同的取值范围,由实现决定。
在常见 8 位字节环境中:
text
signed char   常见范围:-128 ~ 127
unsigned char 范围:     0 ~ 255
char          范围:     由实现选择上述一种
因此,下面的 a 不能脱离编译器选项直接断言:
c
char a = -1;但 signed char b = -1; 与 unsigned char c = -1; 的意图更清楚。对 8 位无符号类型,-1 转换后为 255。
3.2 为什么三个变量用 %d 打印
课程例题:
c
#include <stdio.h>

int main(void)
{
    char a = -1;
    signed char b = -1;
    unsigned char c = -1;

    printf("a=%d, b=%d, c=%d\n", a, b, c);
    return 0;
}
传给可变参数函数 printf 时,窄整数会先发生默认参数提升。常见平台中三者都提升为 int:
text
a:取决于 plain char 的实现选择
b:-1
c:255
若本机 char 默认有符号,典型输出为:
text
a=-1, b=-1, c=2553.3 %u 不是"把负数打印成大正数"的转换器
下面的写法在课程题中经常出现:
c
char a = -128;
printf("%u\n", a);
a 通常先提升为 int,而 %u 要求对应实参是 unsigned int。格式说明符与实际参数类型不匹配,标准 C 语义下不能把某个大数当成可靠答案。
如果目的是查看该字节的无符号值,应显式完成转换并匹配格式:
c
printf("%u\n", (unsigned int)(unsigned char)a);若 8 位字节中保存的是 10000000,这里会稳定打印 128。
另一个常见陷阱是:
c
char a = 128;若 char 是有符号且最大值为 127,128 转换到 char 的结果由实现定义。想表达 0~255 范围,应直接使用 unsigned char。
四、大小端:多字节对象怎样排列
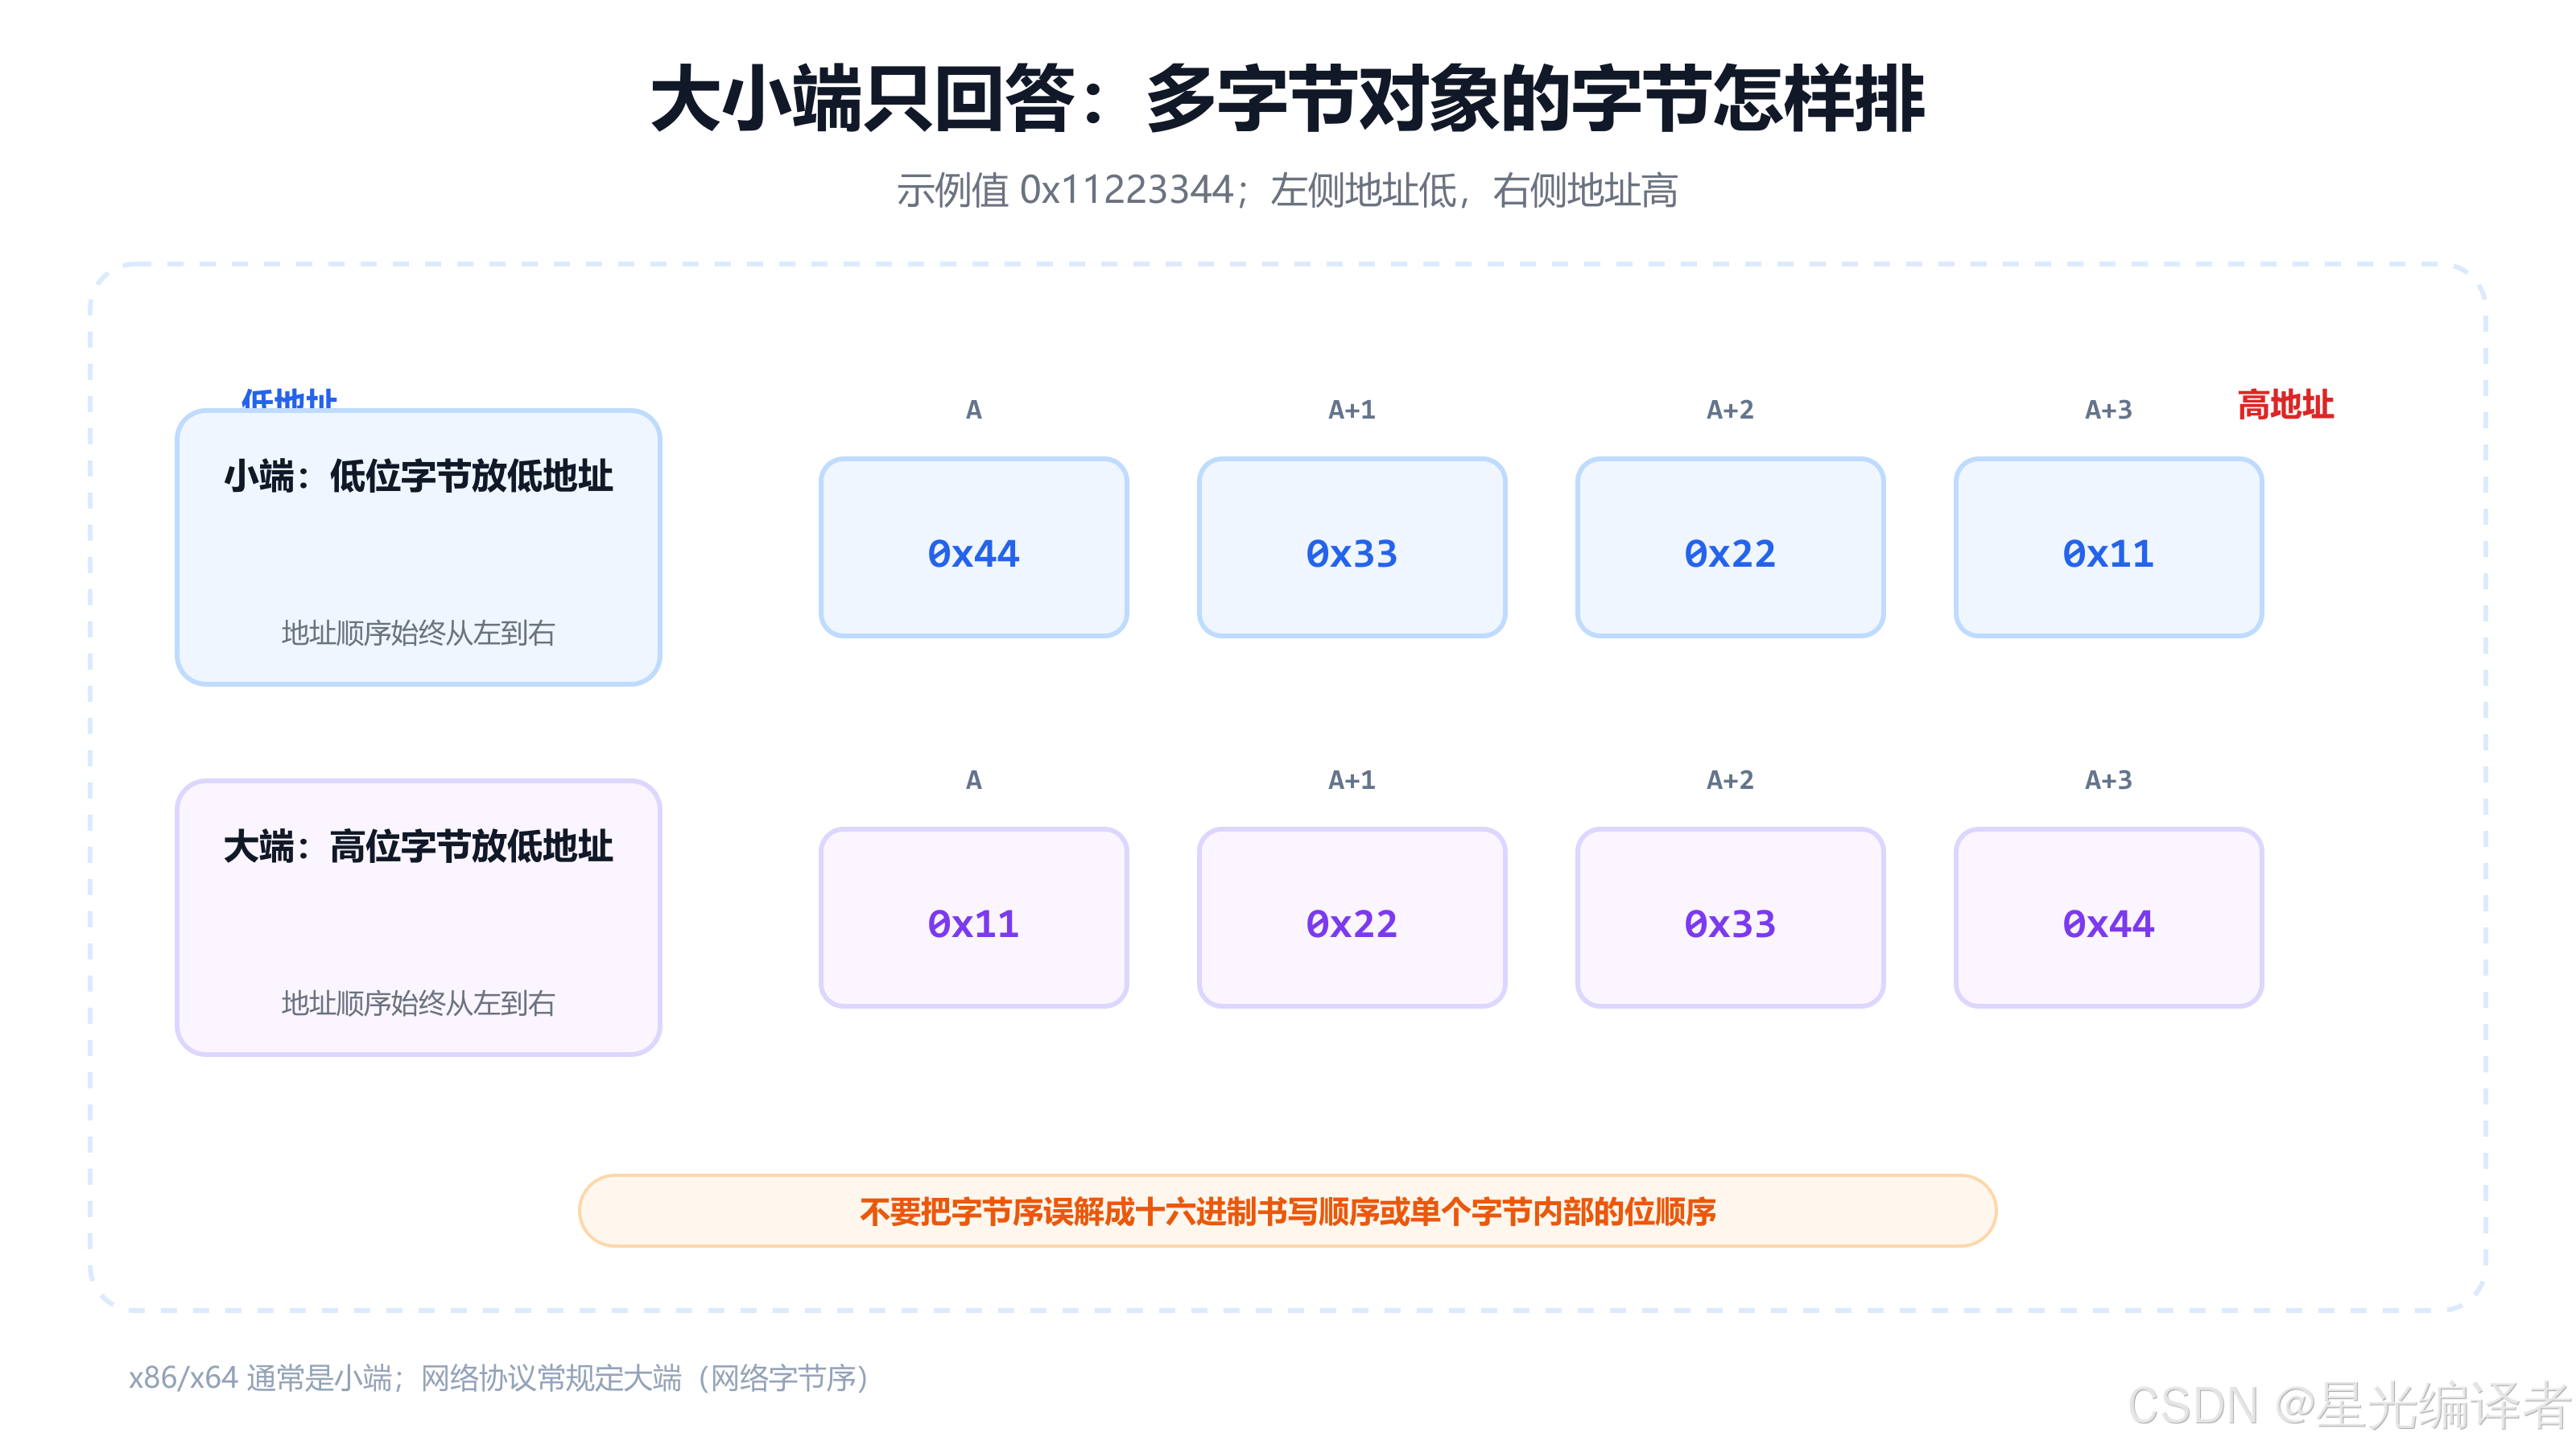
4.1 大端与小端的定义
设一个 32 位整数的值为:
c
unsigned int value = 0x11223344u;从高位到低位,它的四个字节是:
text
高位                                  低位
0x11        0x22        0x33        0x44
若对象起始地址为 A:
| 地址 | A |
A+1 |
A+2 |
A+3 |
|---|---|---|---|---|
| 小端 | 44 |
33 |
22 |
11 |
| 大端 | 11 |
22 |
33 |
44 |
定义可以这样记:
- 小端:最低有效字节放在最低地址;
- 大端:最高有效字节放在最低地址。
大小端讨论的是多字节对象的字节顺序,不是十六进制数字应该从哪边书写,也不是单个字节内部的位顺序。
4.2 为什么需要字节序
内存按字节编址,而 short、int、long long 等对象通常占多个字节。处理器一次读取一个多字节对象时,体系结构必须规定"哪个字节放低地址"。不同体系结构作出了不同选择,于是形成大端和小端。
x86/x64 通常采用小端。网络协议常把大端称为网络字节序,但不要由此推断所有文件格式、设备协议都使用同一种顺序;协议必须自己写清楚。
4.3 用程序判断当前机器的字节序
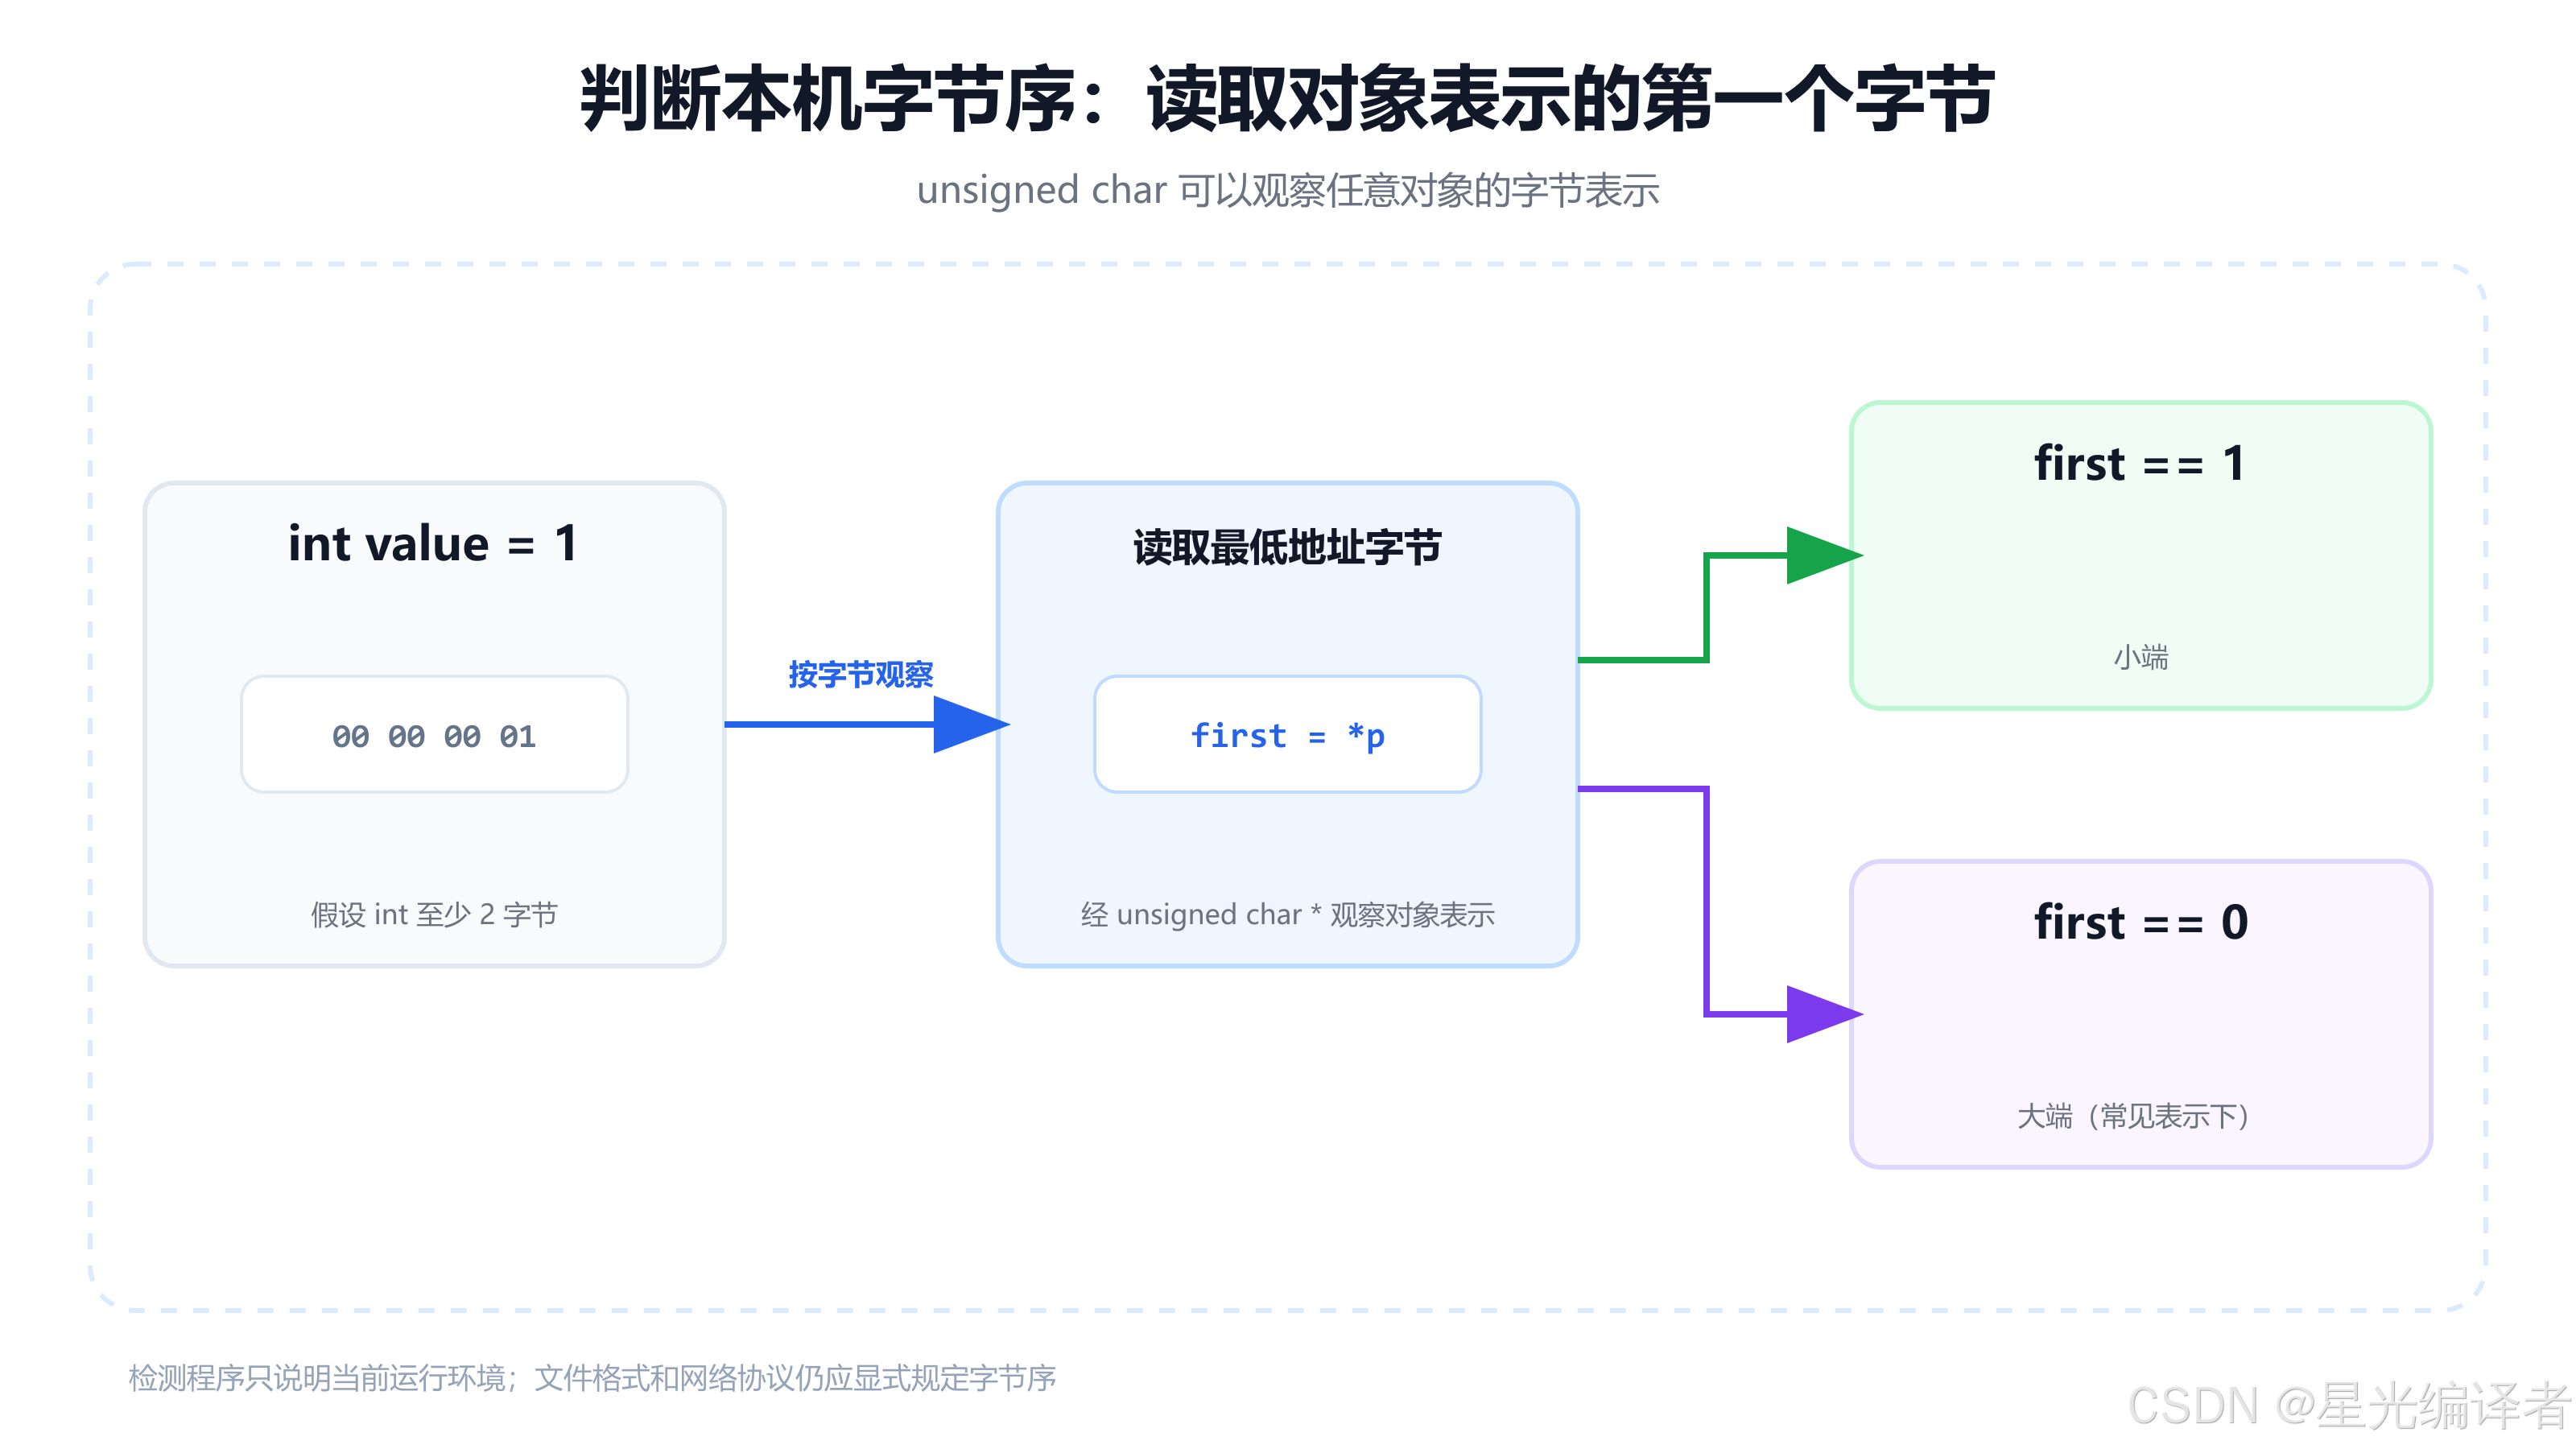
最直接的方法是把对象表示当作 unsigned char 序列观察:
c
#include <stdio.h>

int is_little_endian(void)
{
    const unsigned int value = 1u;
    const unsigned char *first = (const unsigned char *)&value;
    return *first == 1u;
}

int main(void)
{
    printf("%s\n", is_little_endian() ? "little-endian" : "big-endian");
    return 0;
}
C 允许通过字符类型指针观察对象表示。若最低地址处读到 1,说明数值最低有效字节位于最低地址,即小端。
课程还给出了联合体版本:
c
union
{
    int i;
    unsigned char c;
} u;

u.i = 1;
printf("%s\n", u.c == 1 ? "little-endian" : "big-endian");
这个写法在 C 实现中很常见,但用 unsigned char * 明确表达"查看对象表示"更容易说明意图。无论采用哪种检测方法,结果只描述当前运行环境;序列化和网络通信仍应显式转换成协议规定的字节序。
五、课程整型与地址练习完整解析
5.1 字符数组中第一个 \0 在哪里
课程代码的核心是:
c
char a[1000];

for (int i = 0; i < 1000; ++i)
{
    a[i] = -1 - i;
}

printf("%zu\n", strlen(a));
在课程采用的 8 位补码环境中,赋入数组的低 8 位依次为:
text
i = 0   → 0xFF
i = 1   → 0xFE
...
i = 254 → 0x01
i = 255 → 0x00
因此第一个零字节位于 a[255],典型结果为:
text
strlen(a) == 255完整代码还需要 #include <string.h>,并使用 %zu 打印 size_t。这个结果依赖课程平台对超范围整数到 char 的转换方式;若要编写可移植的业务逻辑,不应把这种转换当作生成字符串终止符的手段。
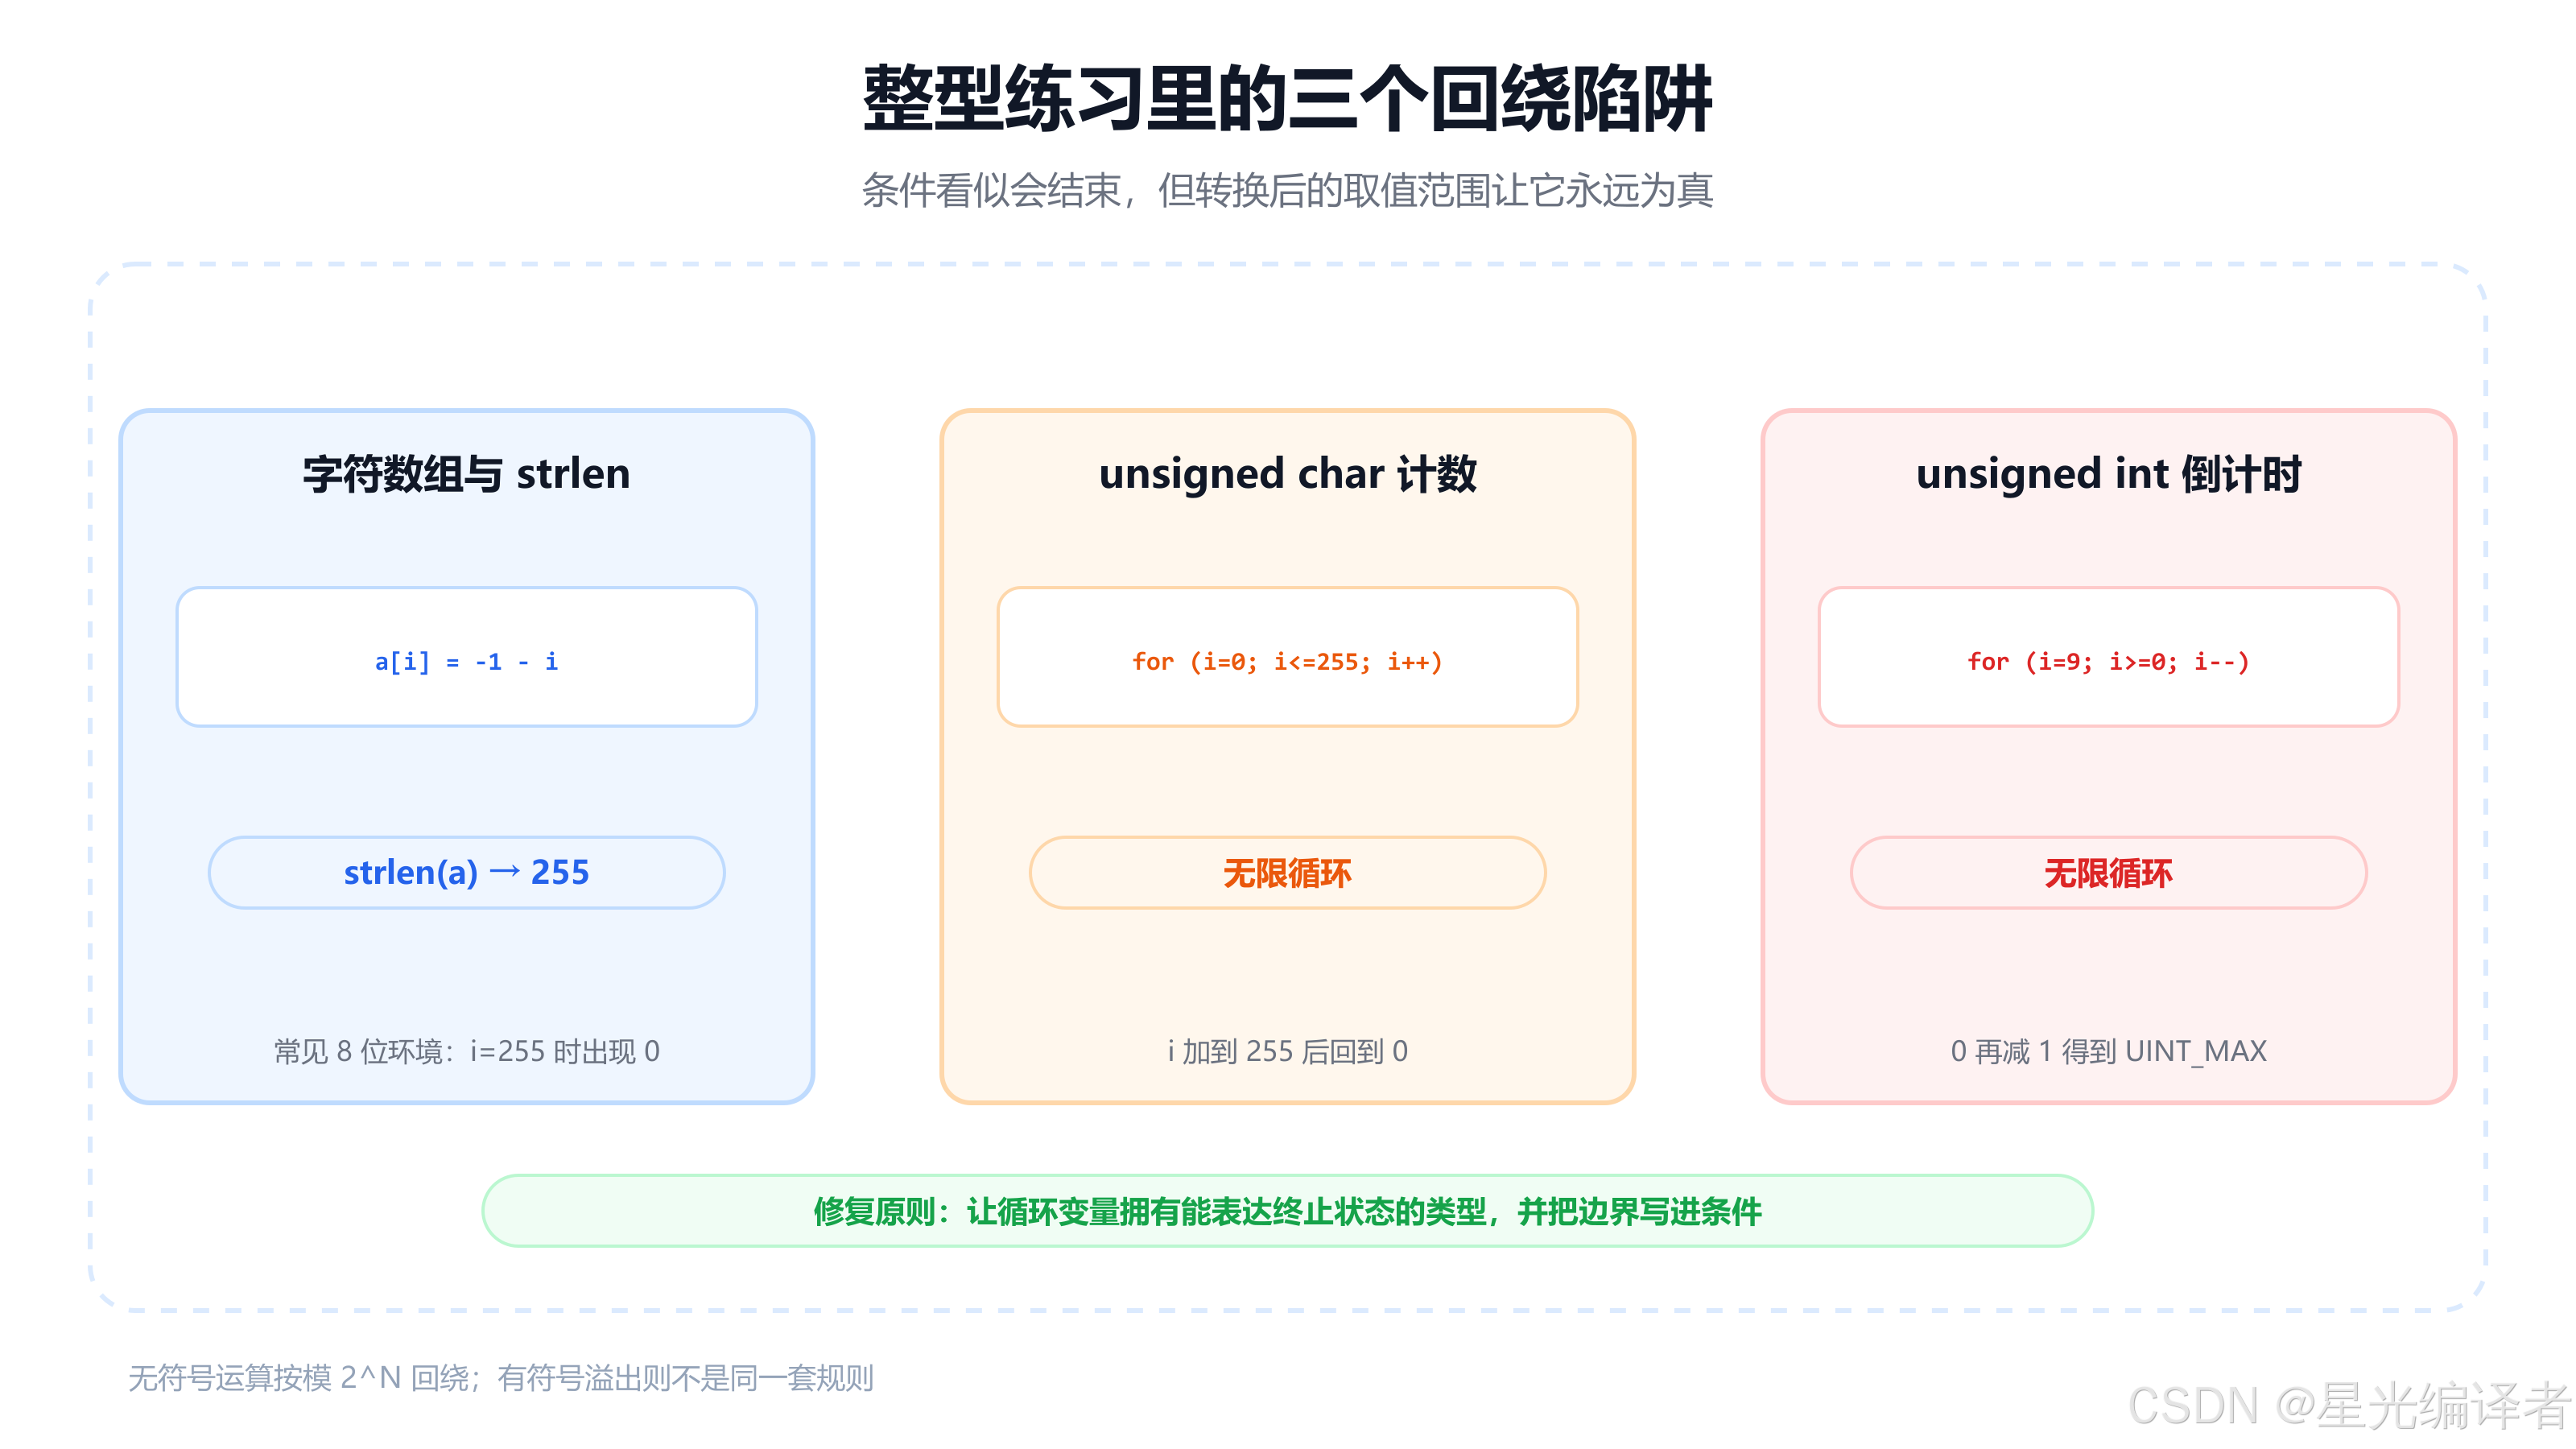
5.2 unsigned char 为什么会无限循环
c
unsigned char i = 0;

for (i = 0; i <= 255; ++i)
{
    puts("hello world");
}
在常见环境中,判断 i <= 255 时,i 提升为 int,它的值永远位于 0~255,所以条件始终为真。当 i 为 255 再执行 ++i,转换回 unsigned char 后回到 0。
若确实想循环 256 次,可以让循环变量拥有更宽的类型:
c
for (unsigned int i = 0; i <= 255u; ++i)
{
    puts("hello world");
}
5.3 无符号整数为什么不能用 i >= 0 倒计时
c
for (unsigned int i = 9; i >= 0; --i)
{
    printf("%u\n", i);
}
无符号数不可能小于 0,所以 i >= 0 永远成立。i 从 0 再减 1 后会回绕为 UINT_MAX。
常见改法有两种:
c
for (int i = 9; i >= 0; --i)
{
    printf("%d\n", i);
}
或保留无符号类型,把递减与判断合并:
c
for (unsigned int i = 10; i-- > 0; )
{
    printf("%u\n", i);
}
5.4 地址综合题的课程结果
课程例题:
c
int a[4] = {1, 2, 3, 4};
int *ptr1 = (int *)(&a + 1);
int *ptr2 = (int *)((int)a + 1);

printf("%x,%x", ptr1[-1], *ptr2);
在课程假设的 32 位小端、sizeof(int) == 4 环境中:
&a指向整个int[4]数组;&a + 1越过整组 16 字节;- 课程写法把它转成
int *后回退一个元素,典型读到a[3],即4; (int)a + 1把起始地址数值增加 1 字节;- 从第二个字节起按一个
int读取,会看到00 00 00 02; - 小端解释为
0x02000000,用%x打印为2000000。
所以传统题目的典型答案是:
text
4,2000000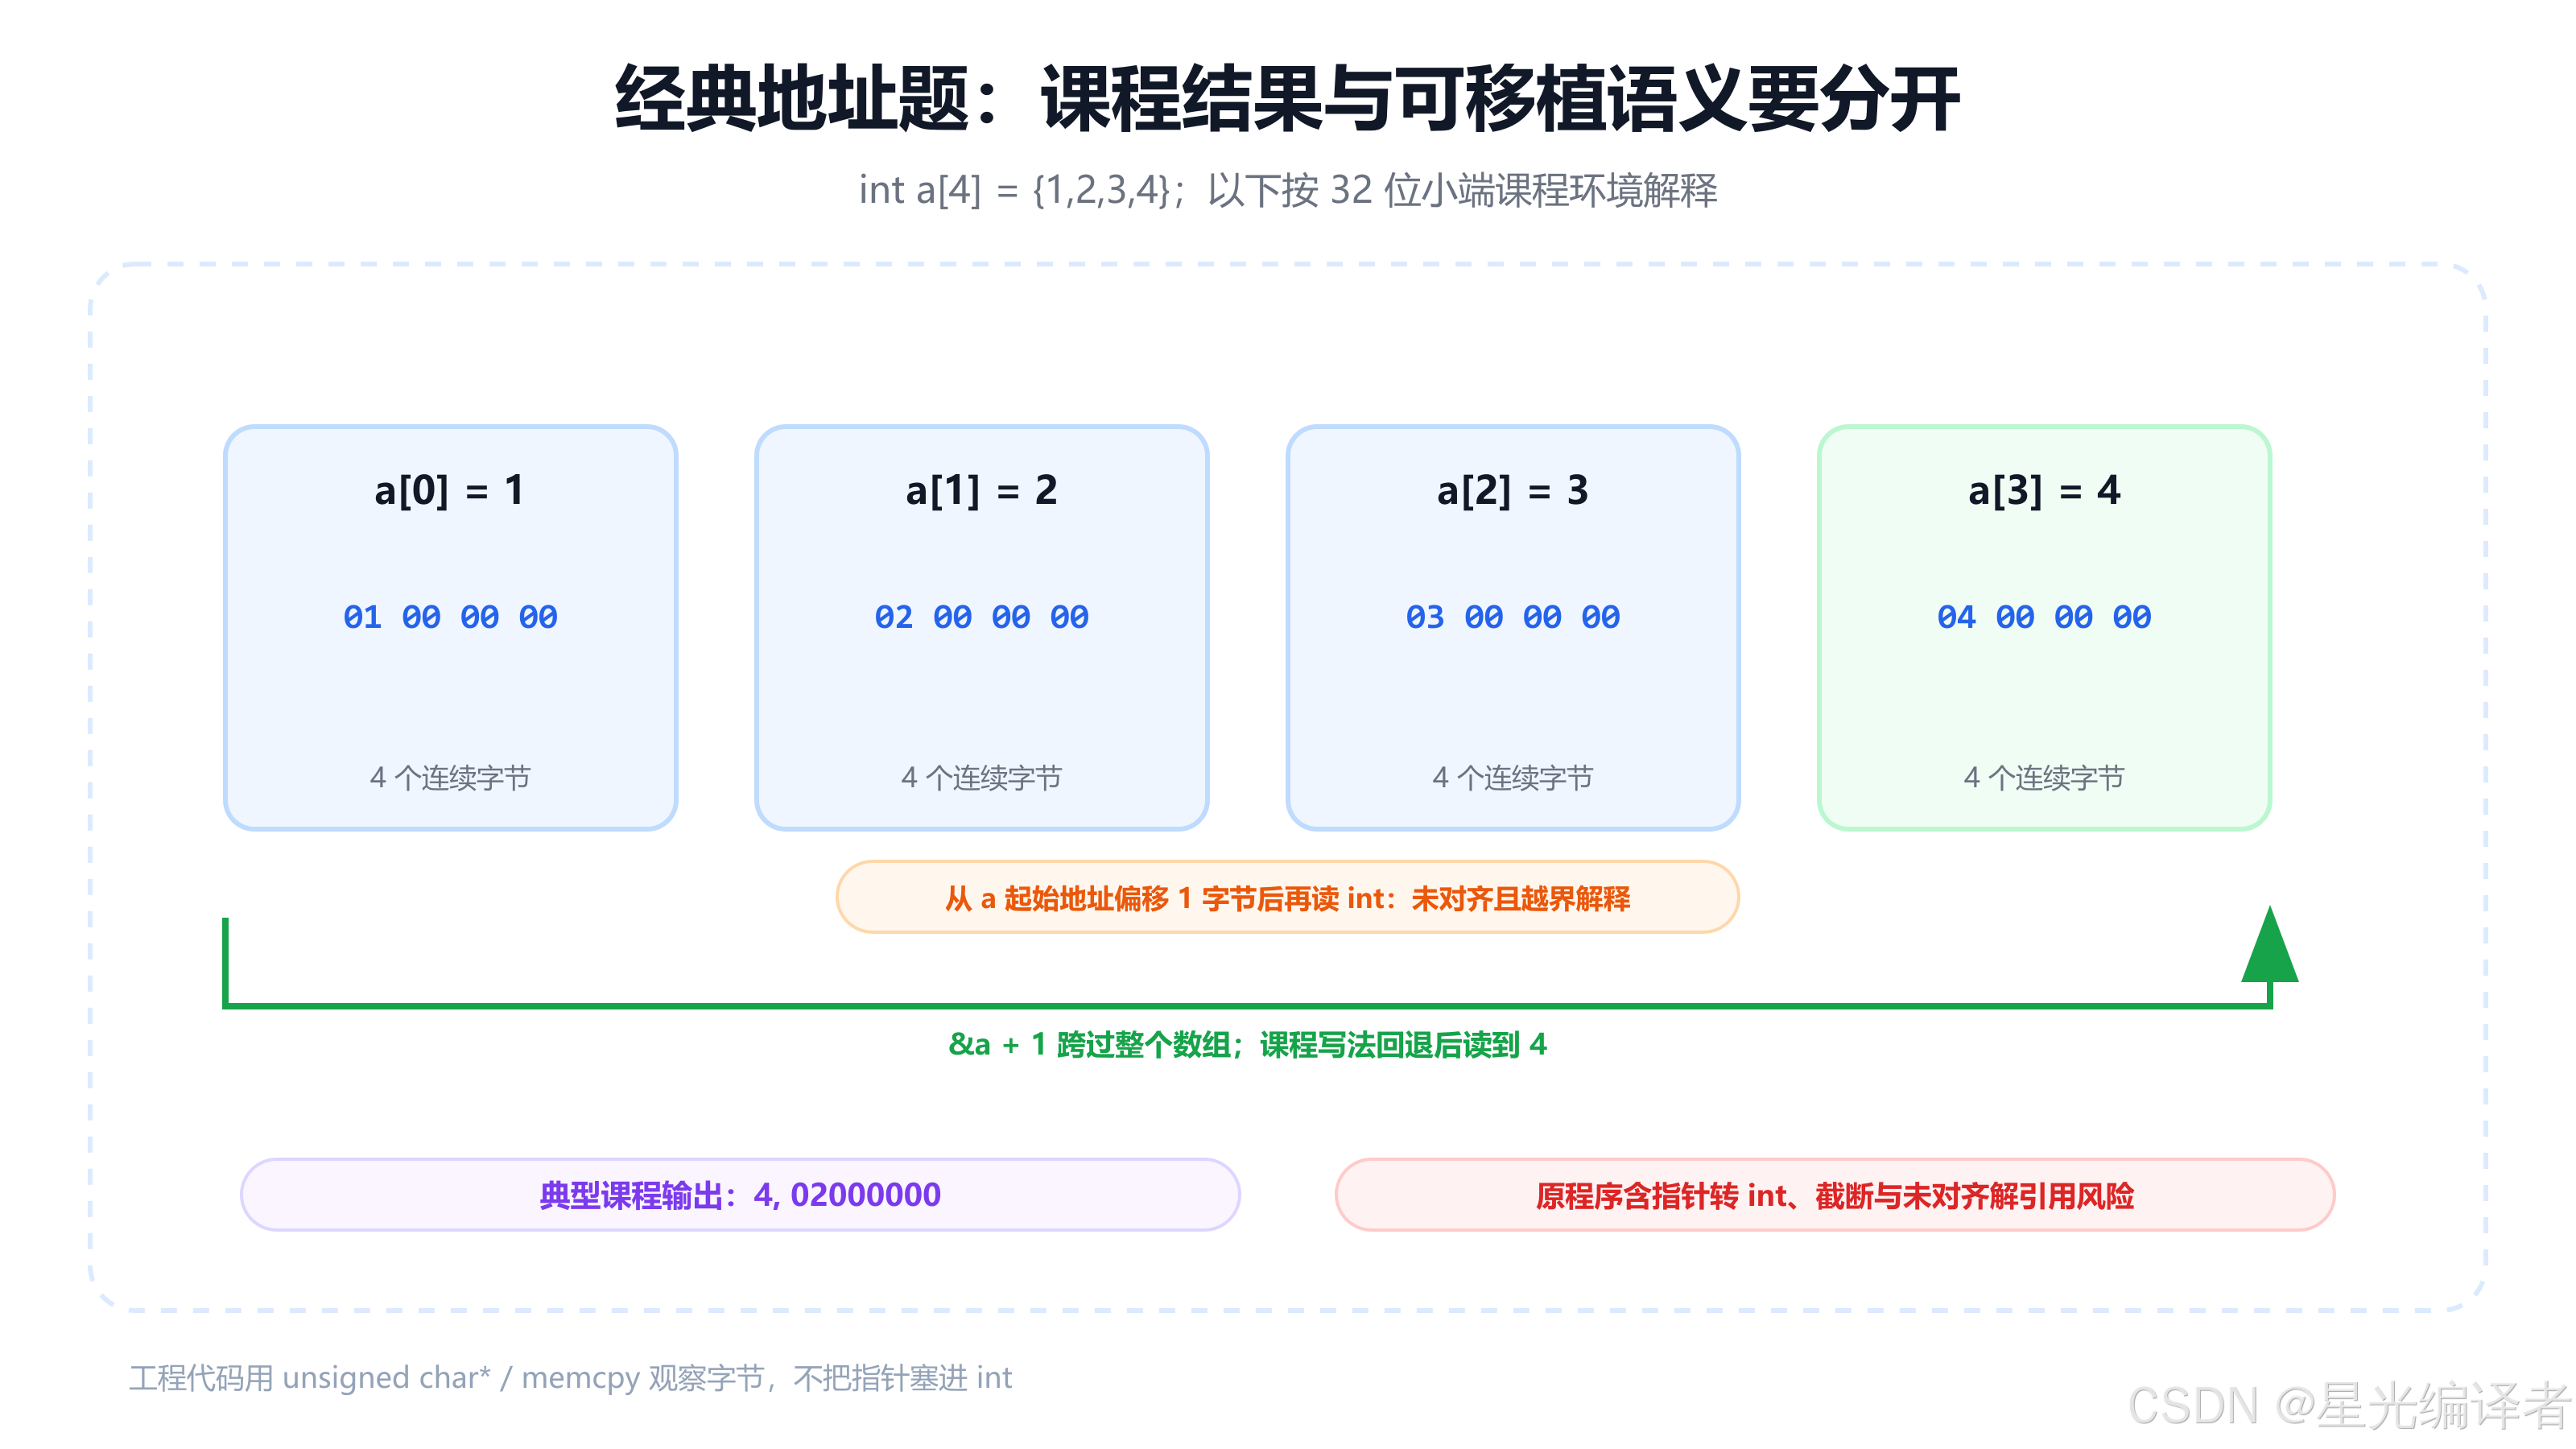
5.5 为什么不能把这个答案直接搬进工程代码
原程序存在多重风险:
- 把指针转换成
int的结果由实现定义,64 位平台还可能截断地址; - 加 1 后得到的地址通常不满足
int对齐要求; - 用
int *解引用拼接出来的四个字节,不是一个合法建立的int对象; - 强制转换只压制部分诊断,不会让无效访问变得合法。
如果只是观察数组的字节,应使用字符类型指针:
c
const unsigned char *bytes = (const unsigned char *)a;

for (size_t i = 0; i < sizeof a; ++i)
{
    printf("%02x ", (unsigned int)bytes[i]);
}
若要从字节缓冲区恢复一个 int,先确认协议字节序与长度,再用 memcpy 拷入对齐正确的 int 对象;不要直接制造未对齐的 int *。
六、浮点数不是"带小数点的整数"
整数通常按定点位权解释:某一位代表 2^k。浮点数则把有限位数分成符号、阶码与尾数,以近似科学计数法的方式覆盖非常大和非常小的数。
对常见 IEEE 754 二进制浮点数,正规数可写成:
text
V = (-1)^S × (1.F) × 2^(E - bias)其中:
S是符号位;E是存储后的阶码字段;F是小数部分,又称 fraction;bias是偏置值。
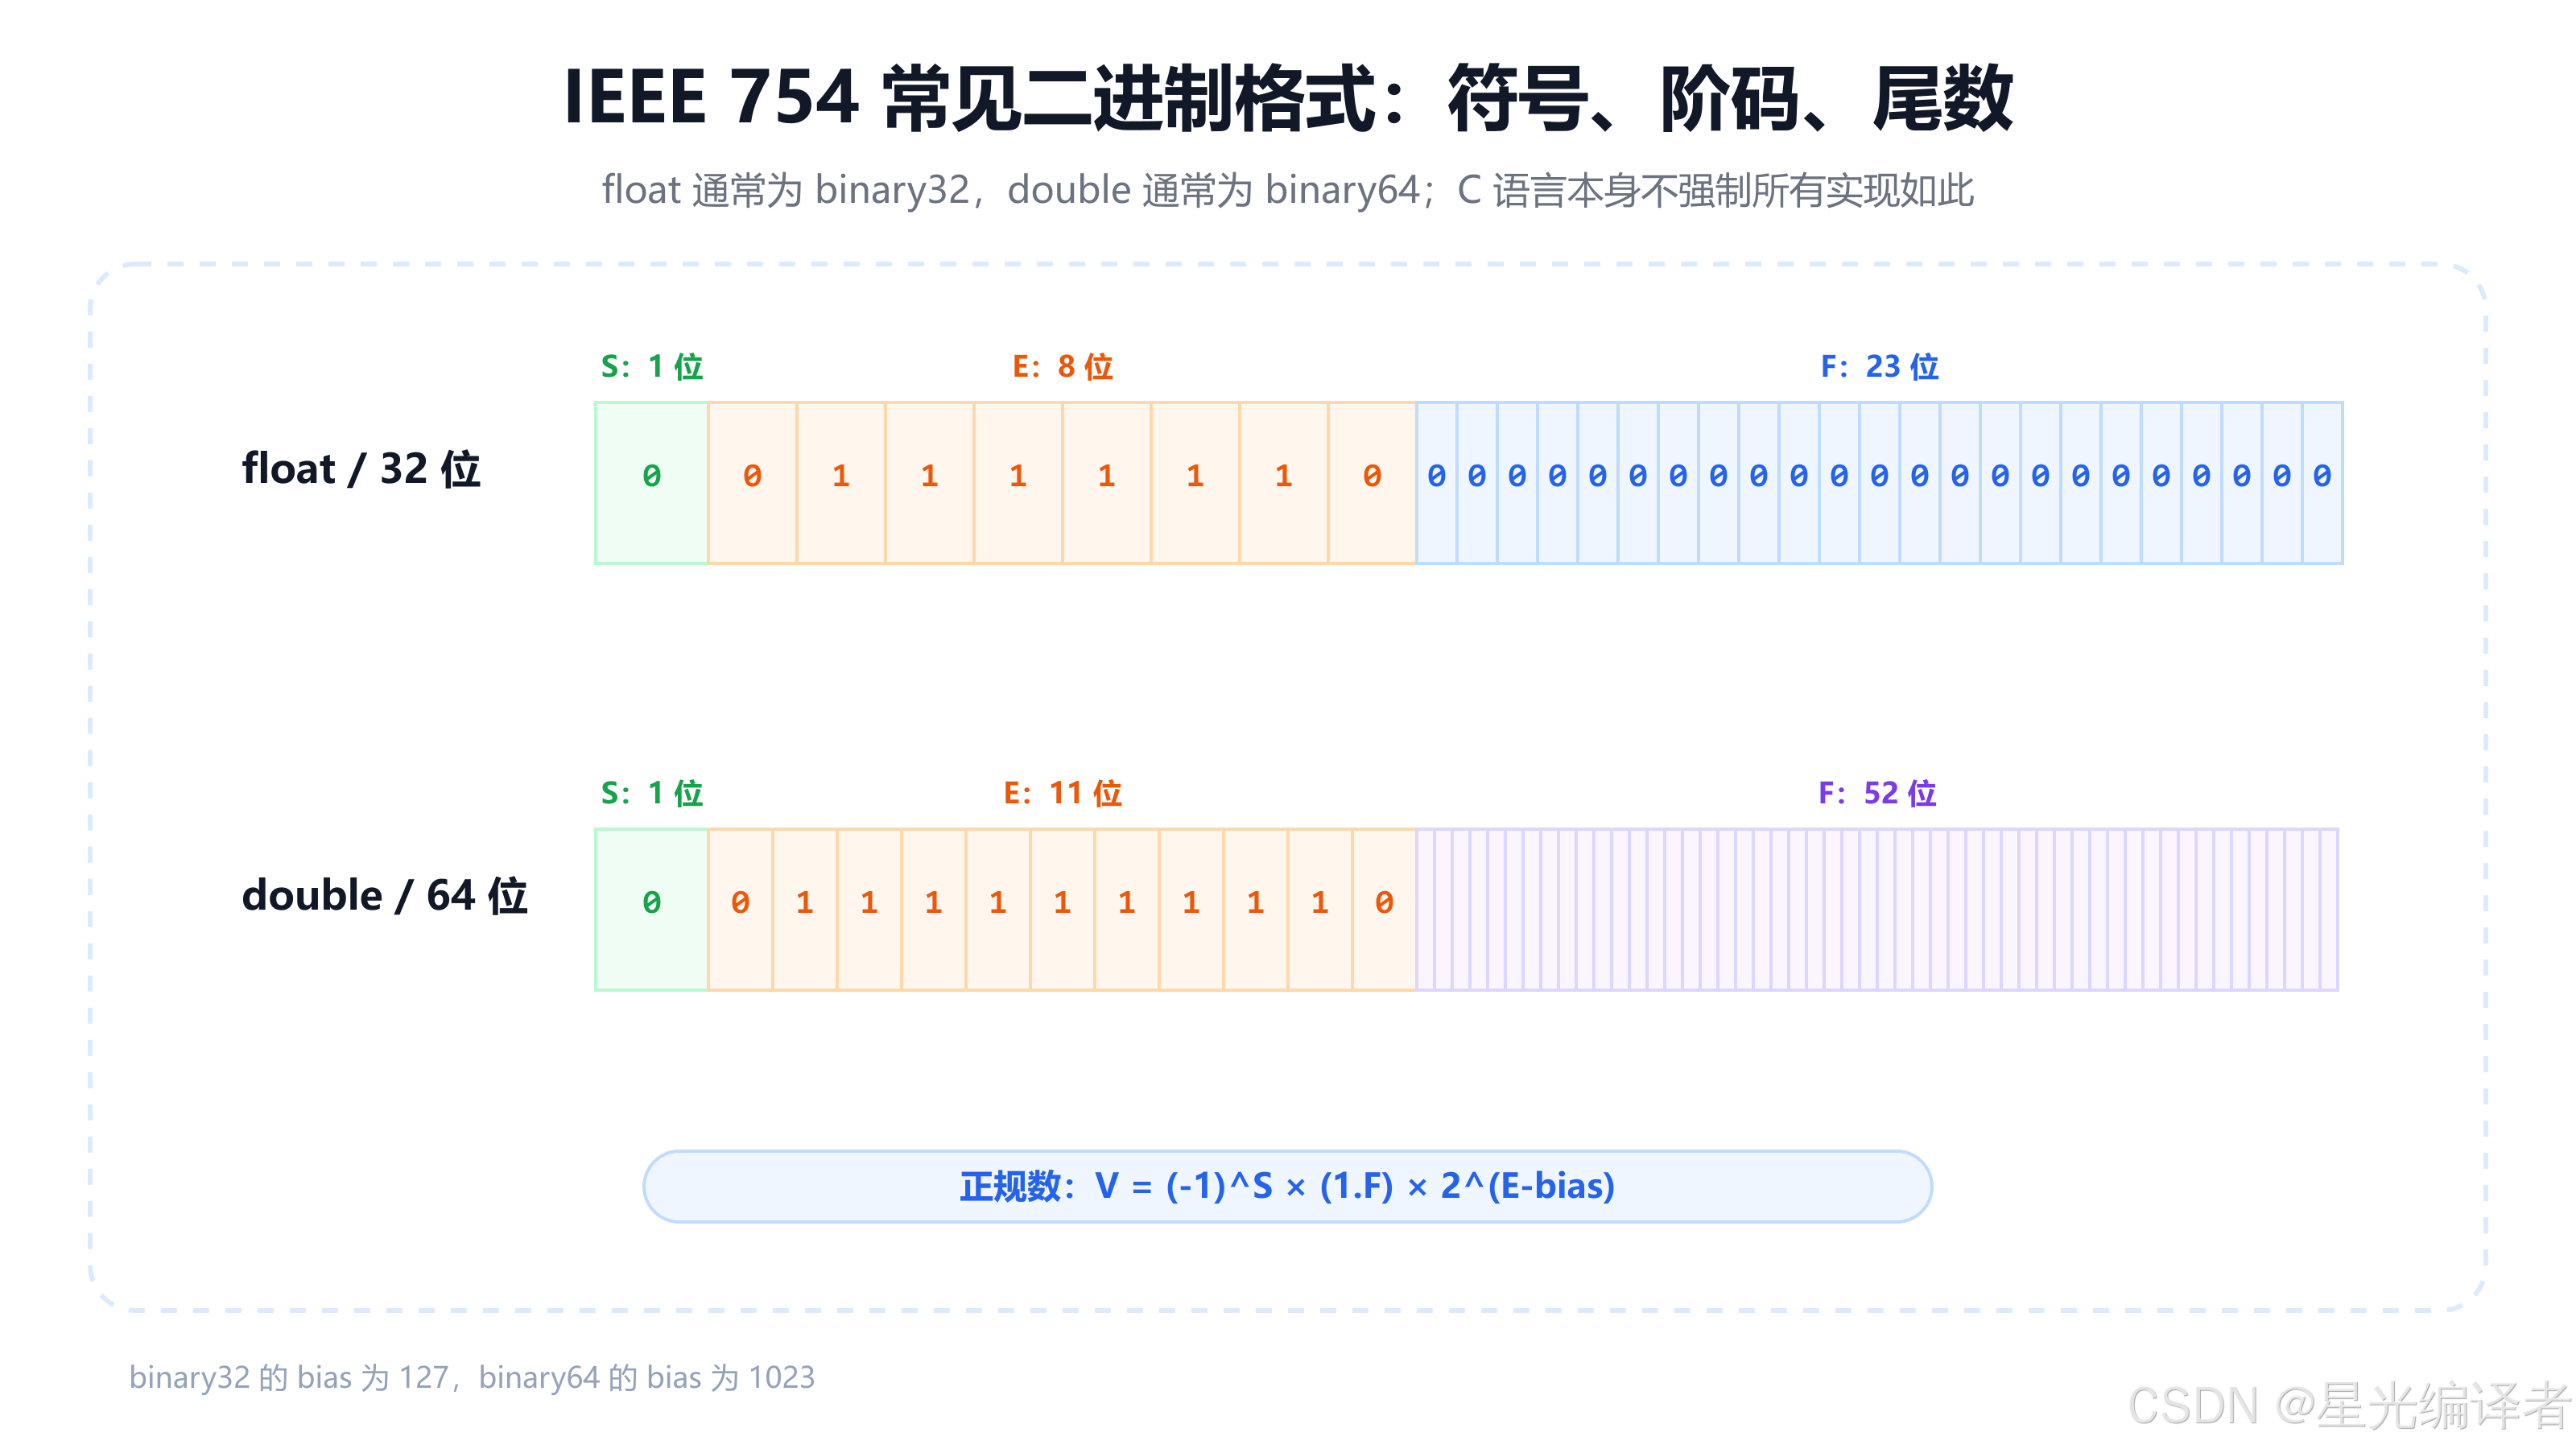
常见字段布局如下:
| 格式 | 总位数 | 符号 S |
阶码 E |
尾数字段 F |
bias |
|---|---|---|---|---|---|
binary32(常见 float) |
32 | 1 | 8 | 23 | 127 |
binary64(常见 double) |
64 | 1 | 11 | 52 | 1023 |
这里要保留一个重要边界:C 语言定义 float、double 的语义和最小范围,但并不要求所有实现都必须采用上述 IEEE 754 格式。本文的逐位推导建立在课程与主流桌面环境使用 binary32/binary64 的前提上。
6.1 为什么尾数能"多存一位"
二进制正规数总能规格化为:
text
1.xxxxx₂ × 2^e最高位固定为 1,因此不必真的存进尾数字段。binary32 虽然只有 23 个 F 位,对正规数却能提供 24 位有效精度:1 个隐含的最高位加 23 个显式尾数位。
6.2 为什么阶码要加偏置
真实指数既可能为正,也可能为负。为了把阶码字段作为无符号比特序列存储,binary32 在正规指数上加 127,binary64 加 1023。
例如真实指数为 3:
text
E = 3 + 127 = 130 = 10000010₂读取时再减去偏置即可恢复真实指数。
七、IEEE 754 的存入过程
7.1 把 9.0f 写成 binary32
第一步,把十进制 9 转成二进制:
text
9.0 = 1001.0₂第二步,规格化:
text
1001.0₂ = 1.001₂ × 2^3因此:
text
S = 0
真实指数 = 3
E = 3 + 127 = 130 = 10000010₂
F = 00100000000000000000000
拼接得到:
text
0 | 10000010 | 00100000000000000000000对应十六进制位模式:
text
0x41100000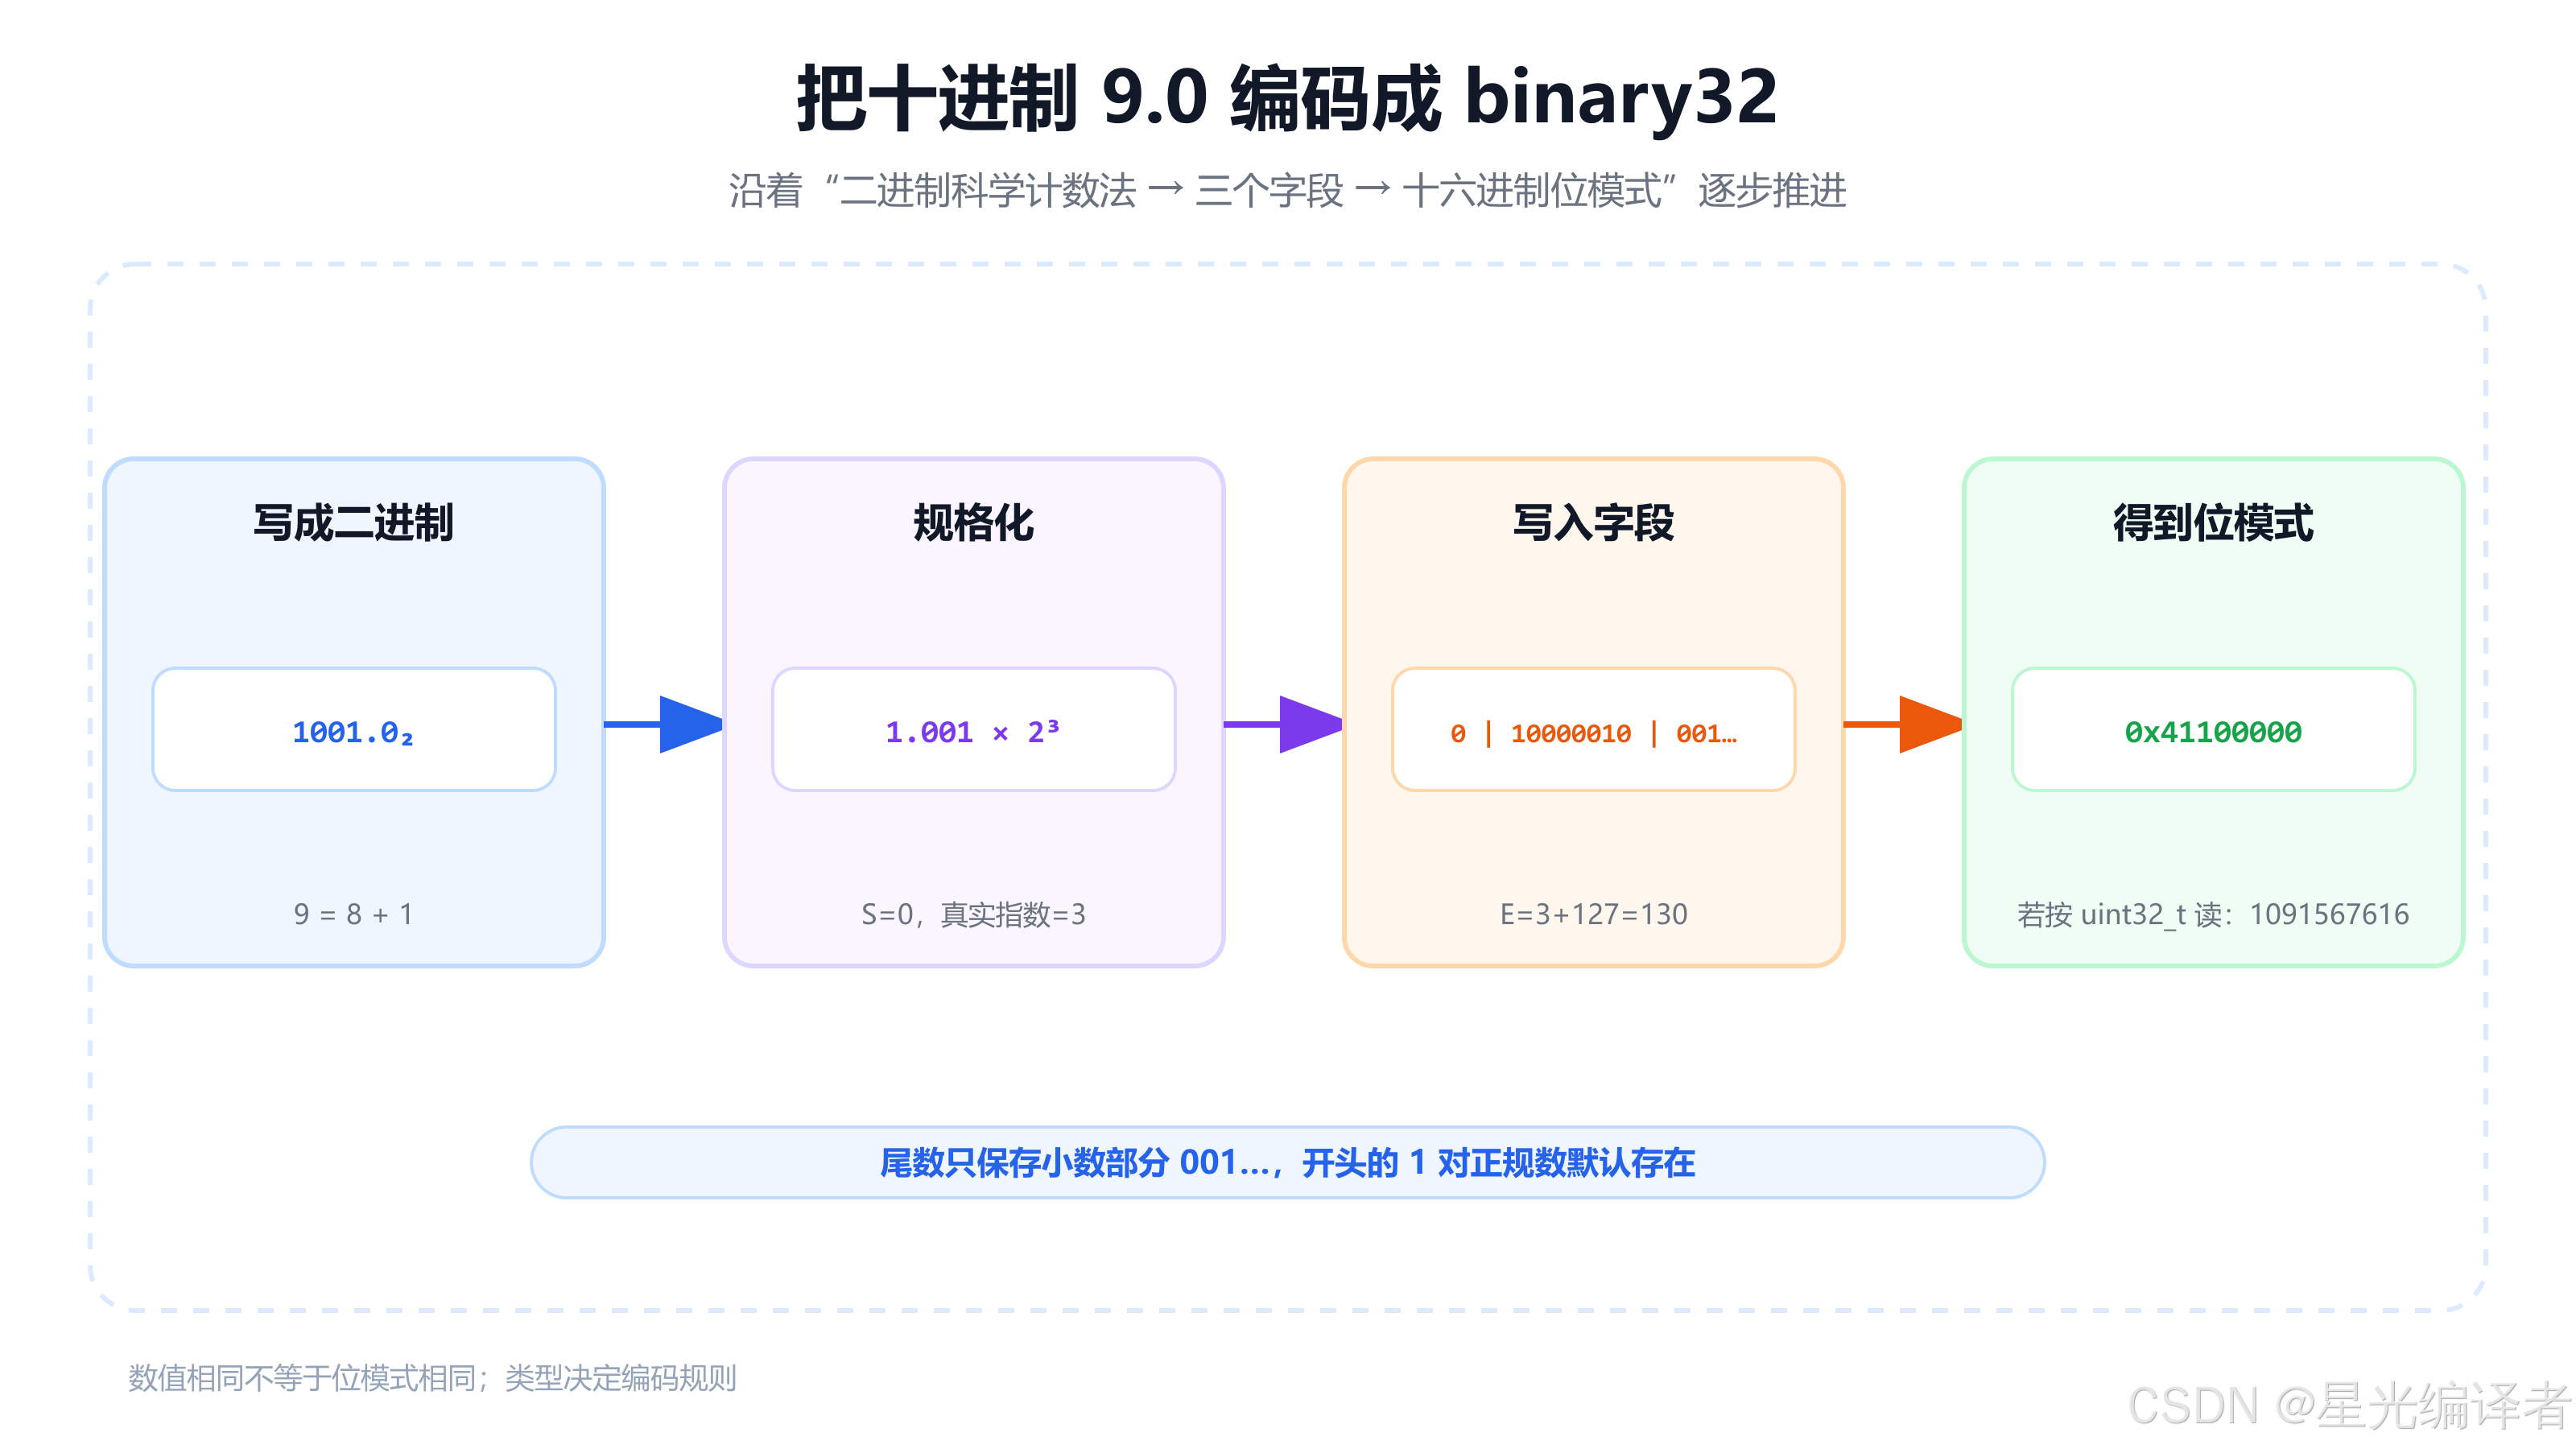
若把这 32 位当作无符号整数解释,数值为:
text
1091567616这不表示浮点转换 9.0f → unsigned int 会得到 1091567616。正常的数值转换仍得到 9;1091567616 是同一位模式被整数规则重解释后的结果。
7.2 0.5f 为什么能精确表示
text
0.5₁₀ = 0.1₂ = 1.0₂ × 2^-1所以:
text
S = 0
E = -1 + 127 = 126 = 01111110₂
F = 00000000000000000000000
完整位模式为:
text
0 | 01111110 | 000000000000000000000000.5、0.25、0.125 等以 2 的负整数次幂构成的数可以有限表示。0.1 的二进制小数却会无限循环,所以通常只能保存邻近值,这也是很多浮点误差的来源。
八、IEEE 754 的取出过程与特殊值
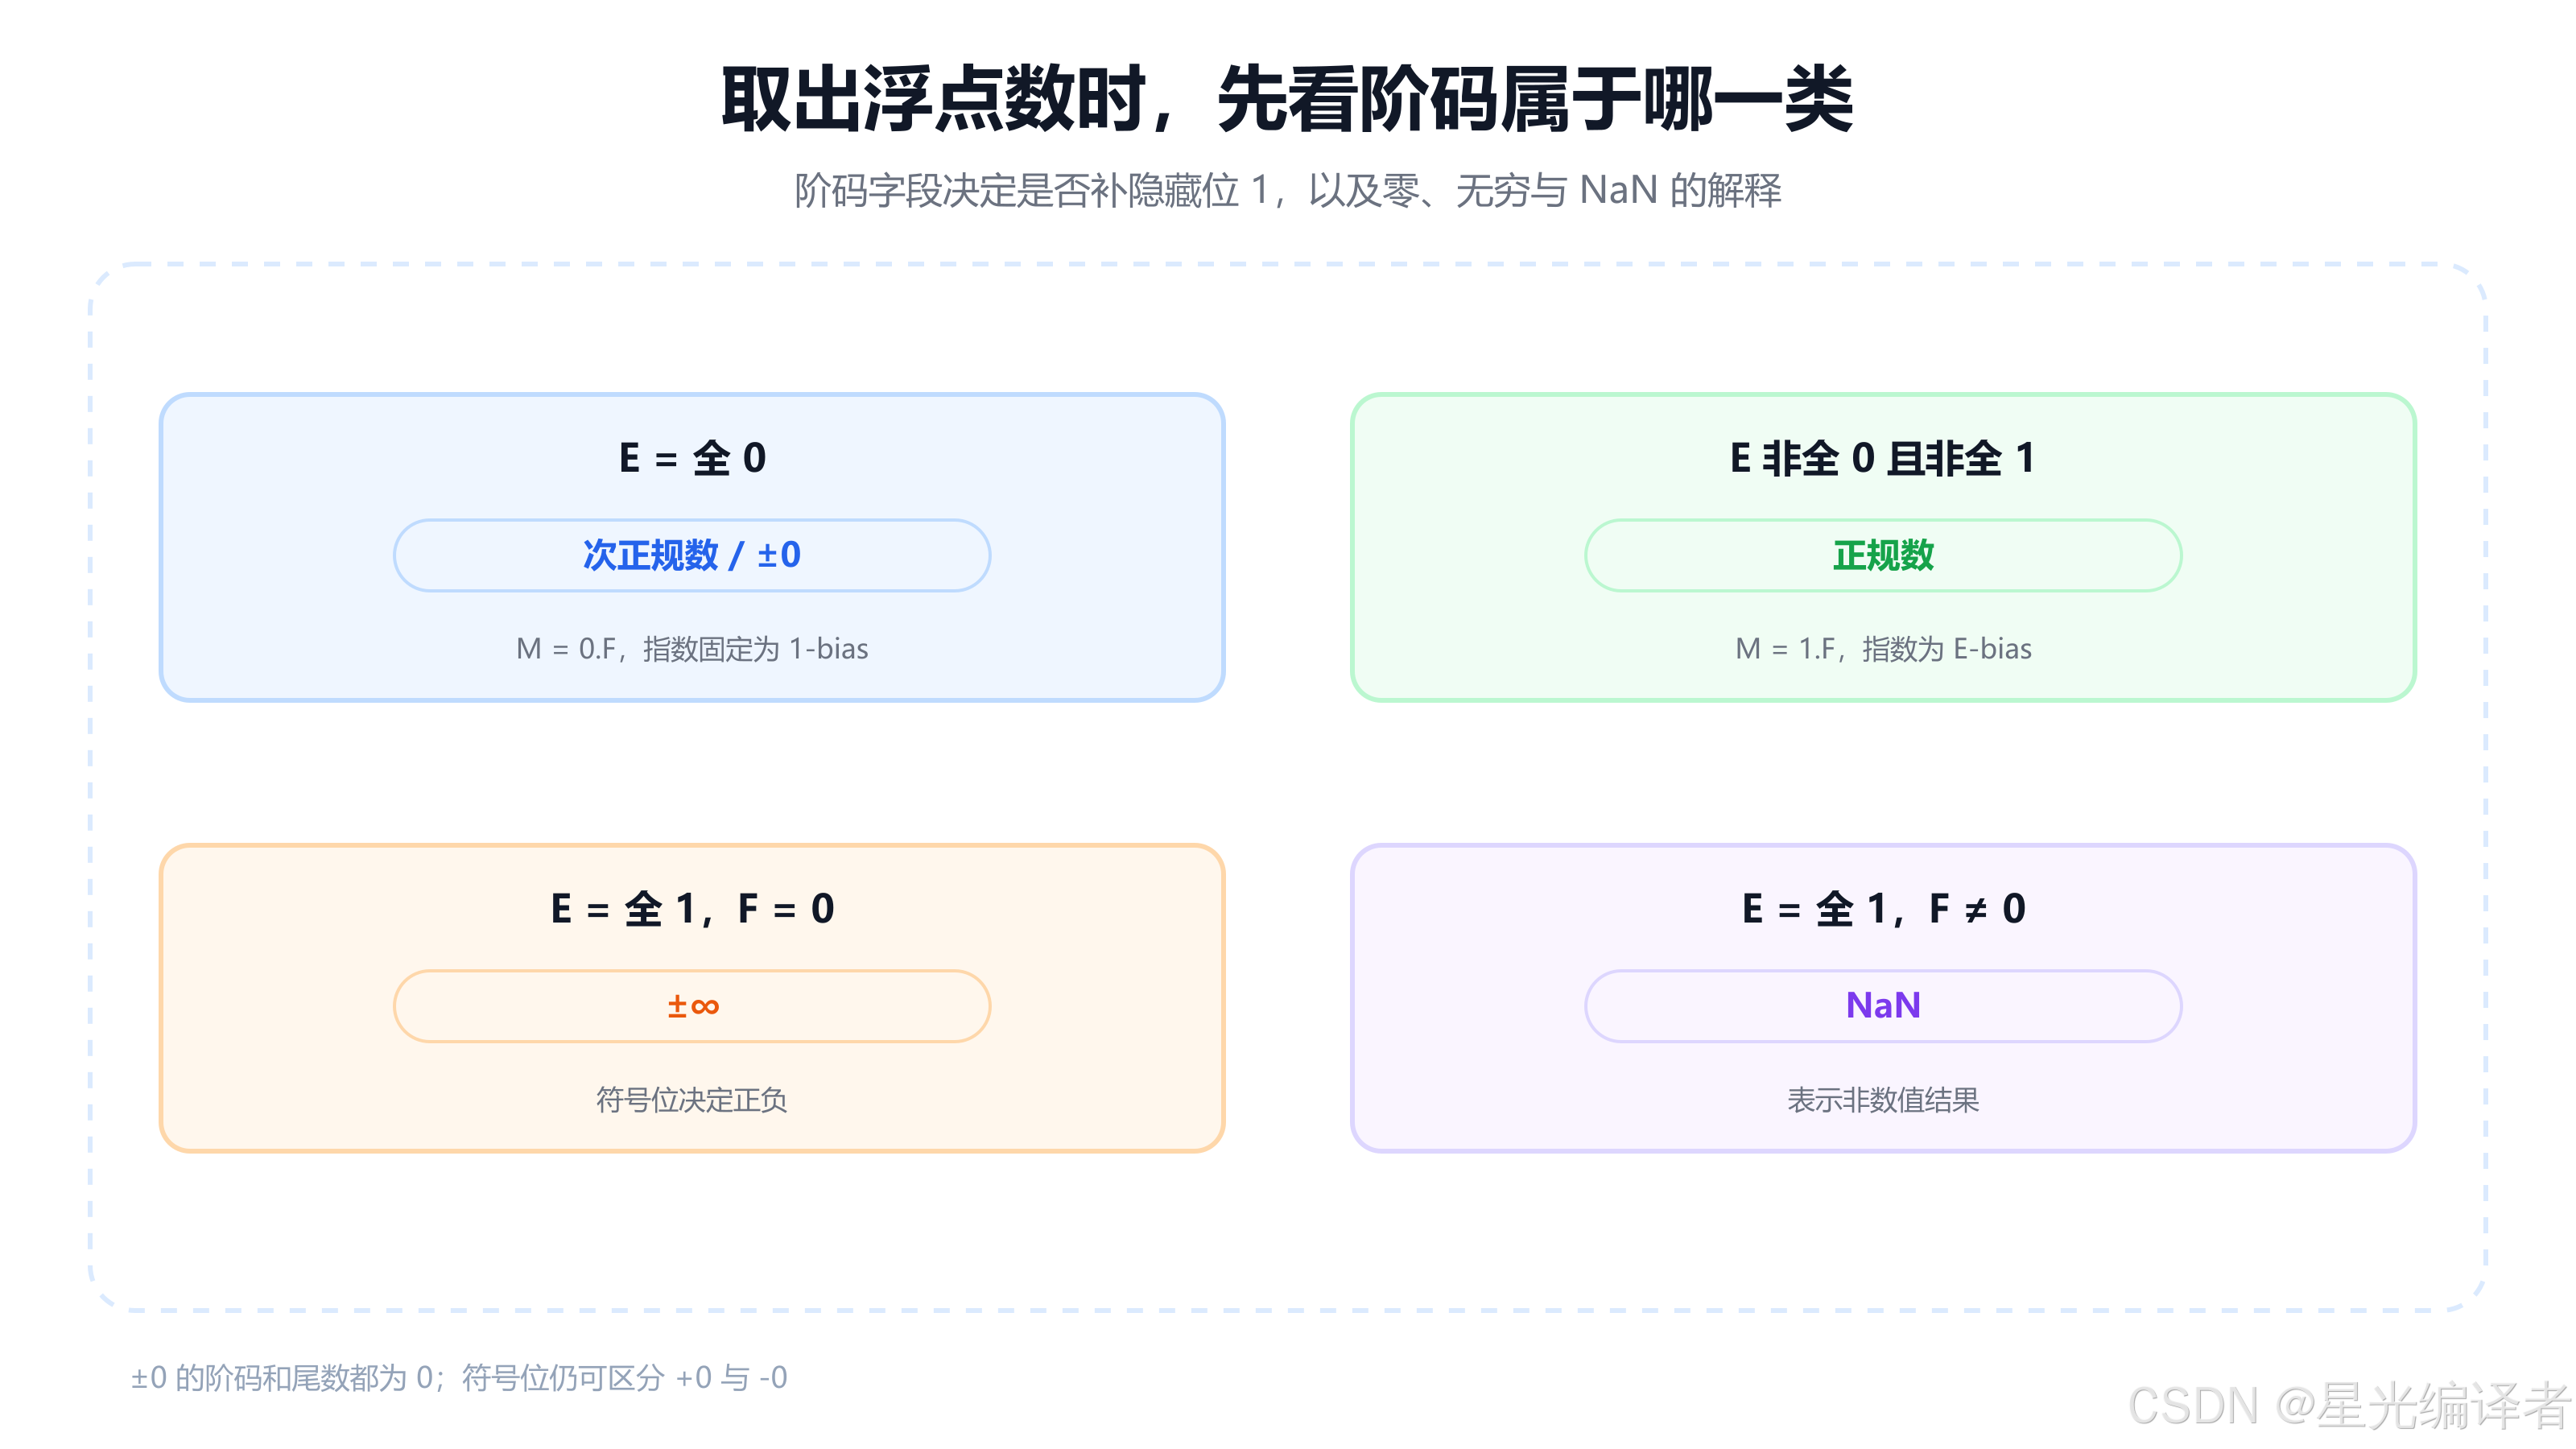
读取 binary32 时,不能对所有阶码都机械套用 1.F × 2^(E-127)。要先把阶码分为三类。
8.1 E 既不全为 0,也不全为 1
这是正规数:
text
V = (-1)^S × (1.F) × 2^(E-127)此时恢复隐含的最高位 1。
8.2 E 全为 0
当尾数也全为 0 时,表示 +0 或 -0。符号位仍然保留,因此浮点零存在两种符号。
当尾数不为 0 时,表示次正规数:
text
V = (-1)^S × (0.F) × 2^(1-127)这里不补隐含位 1,真实指数固定为 -126。次正规数让数值可以从最小正规数继续逐渐靠近 0,而不是突然出现巨大空档。
8.3 E 全为 1
F == 0:表示正无穷或负无穷;F != 0:表示 NaN,也就是"不是一个数"。
NaN 常来自 0.0 / 0.0、无穷减无穷等无效浮点运算。比较 NaN 时要格外小心:它与包括自身在内的任何值做普通相等比较通常都为假,应使用 <math.h> 中的 isnan。
九、同一串比特为什么会得到两个答案
课程代码通过 float * 指向 int 对象:
c
int n = 9;
float *p = (float *)&n;

printf("n = %d\n", n);
printf("*p = %f\n", *p);

*p = 9.0f;
printf("n = %d\n", n);
printf("*p = %f\n", *p);
在常见调试环境中,它试图展示:
text
int 9 的位模式 0x00000009
按 binary32 解读约为 1.2611686 × 10^-44
用默认 %f 的六位小数显示为 0.000000

float 9.0f 的位模式 0x41100000
按 32 位整数解读为 1091567616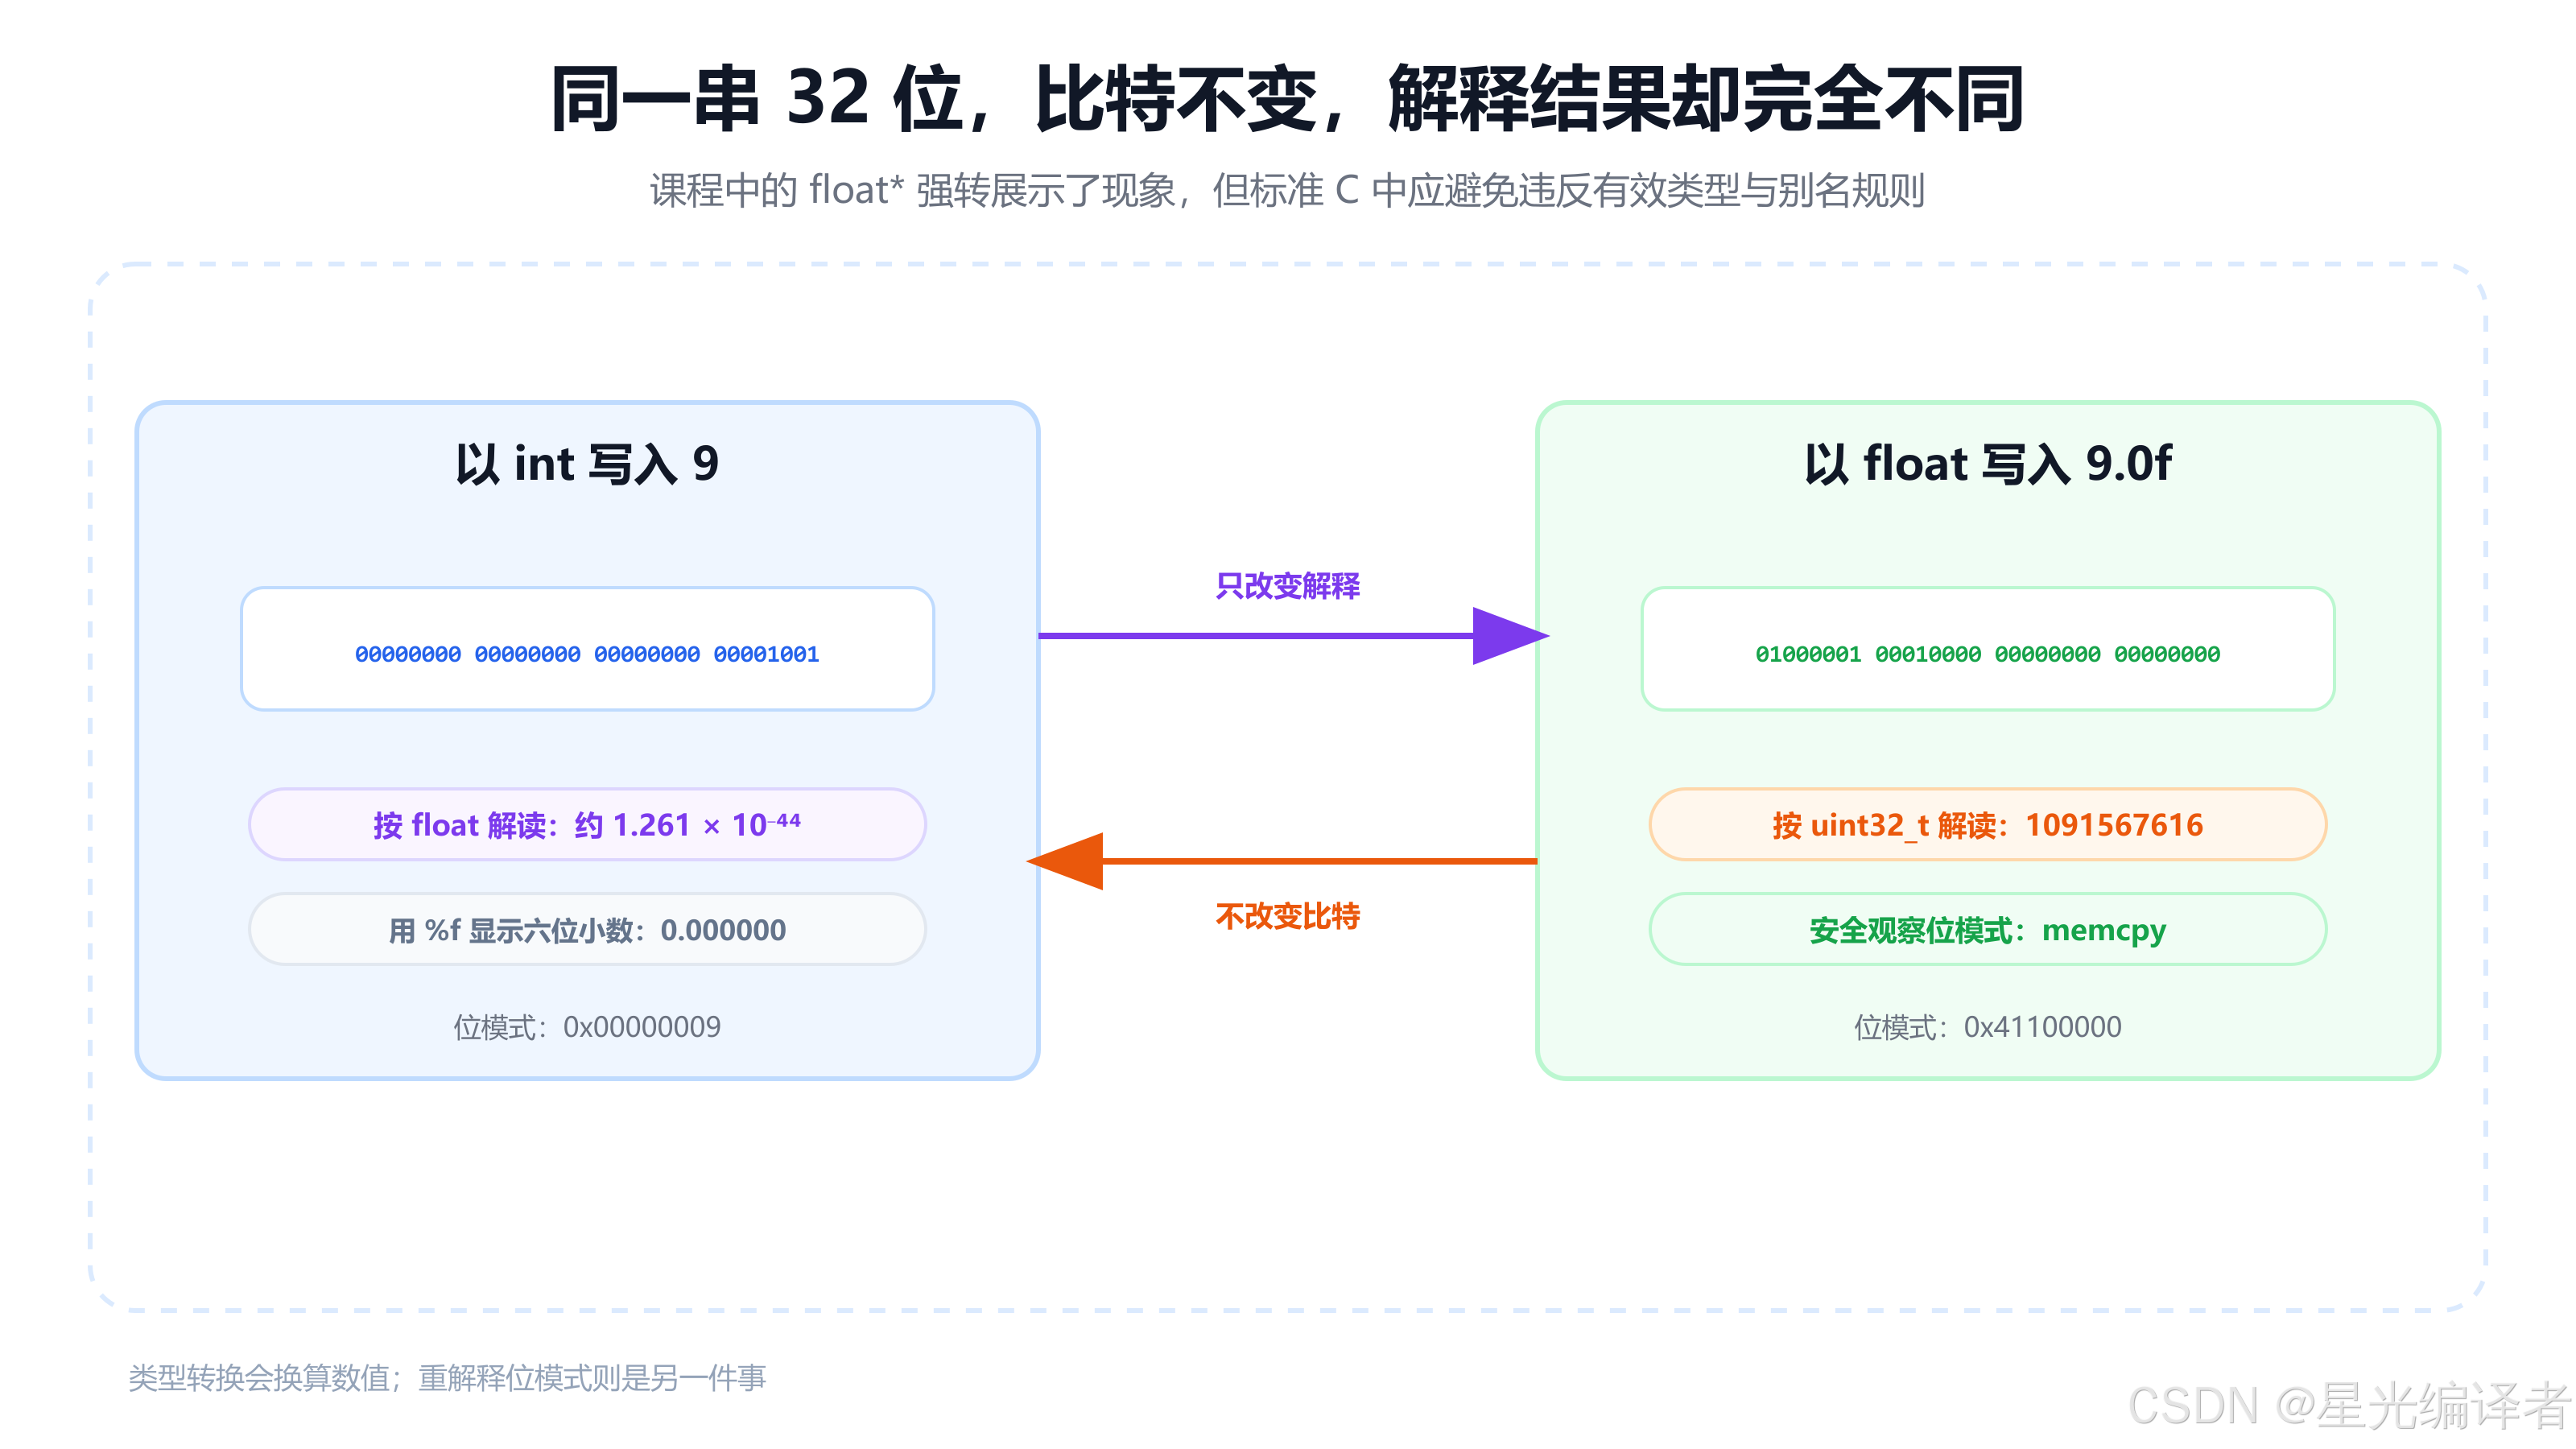
9.1 为什么整数 9 会变成极小浮点数
32 位整数 9 的常见位模式为:
text
00000000 00000000 00000000 00001001按 binary32 分段:
text
S = 0
E = 00000000
F = 00000000000000000001001
阶码全为 0,所以这是次正规数。尾数字段的整数值为 9,binary32 最低尾数位权为 2^-149:
text
V = 9 × 2^-149 ≈ 1.2611686 × 10^-44printf("%f", value) 默认只显示小数点后六位,因此输出看起来是 0.000000。它不是数学上的零,只是显示精度不足。
9.2 为什么原代码不适合作为标准 C 写法
通过 float * 解引用一个实际类型为 int 的对象,会触及 C 的有效类型和严格别名规则;写回还会让优化器基于"int * 与 float * 不别名"的假设产生意外结果。它适合帮助理解位模式,不适合作为可移植程序。
观察位模式时应使用 memcpy:
c
#include <inttypes.h>
#include <stdint.h>
#include <stdio.h>
#include <string.h>

int main(void)
{
    float value = 9.0f;
    uint32_t bits = 0;

    if (sizeof value != sizeof bits)
    {
        puts("this example requires a 32-bit float");
        return 0;
    }

    memcpy(&bits, &value, sizeof bits);
    printf("0x%08" PRIx32 "\n", bits);
    return 0;
}
在 IEEE 754 binary32 环境中,输出为:
text
0x41100000memcpy 拷贝对象表示,不制造一个指向错误类型的左值;编译器通常也会把这种固定大小拷贝优化成普通寄存器操作。
十、稳定解题流程、高频问答与练习
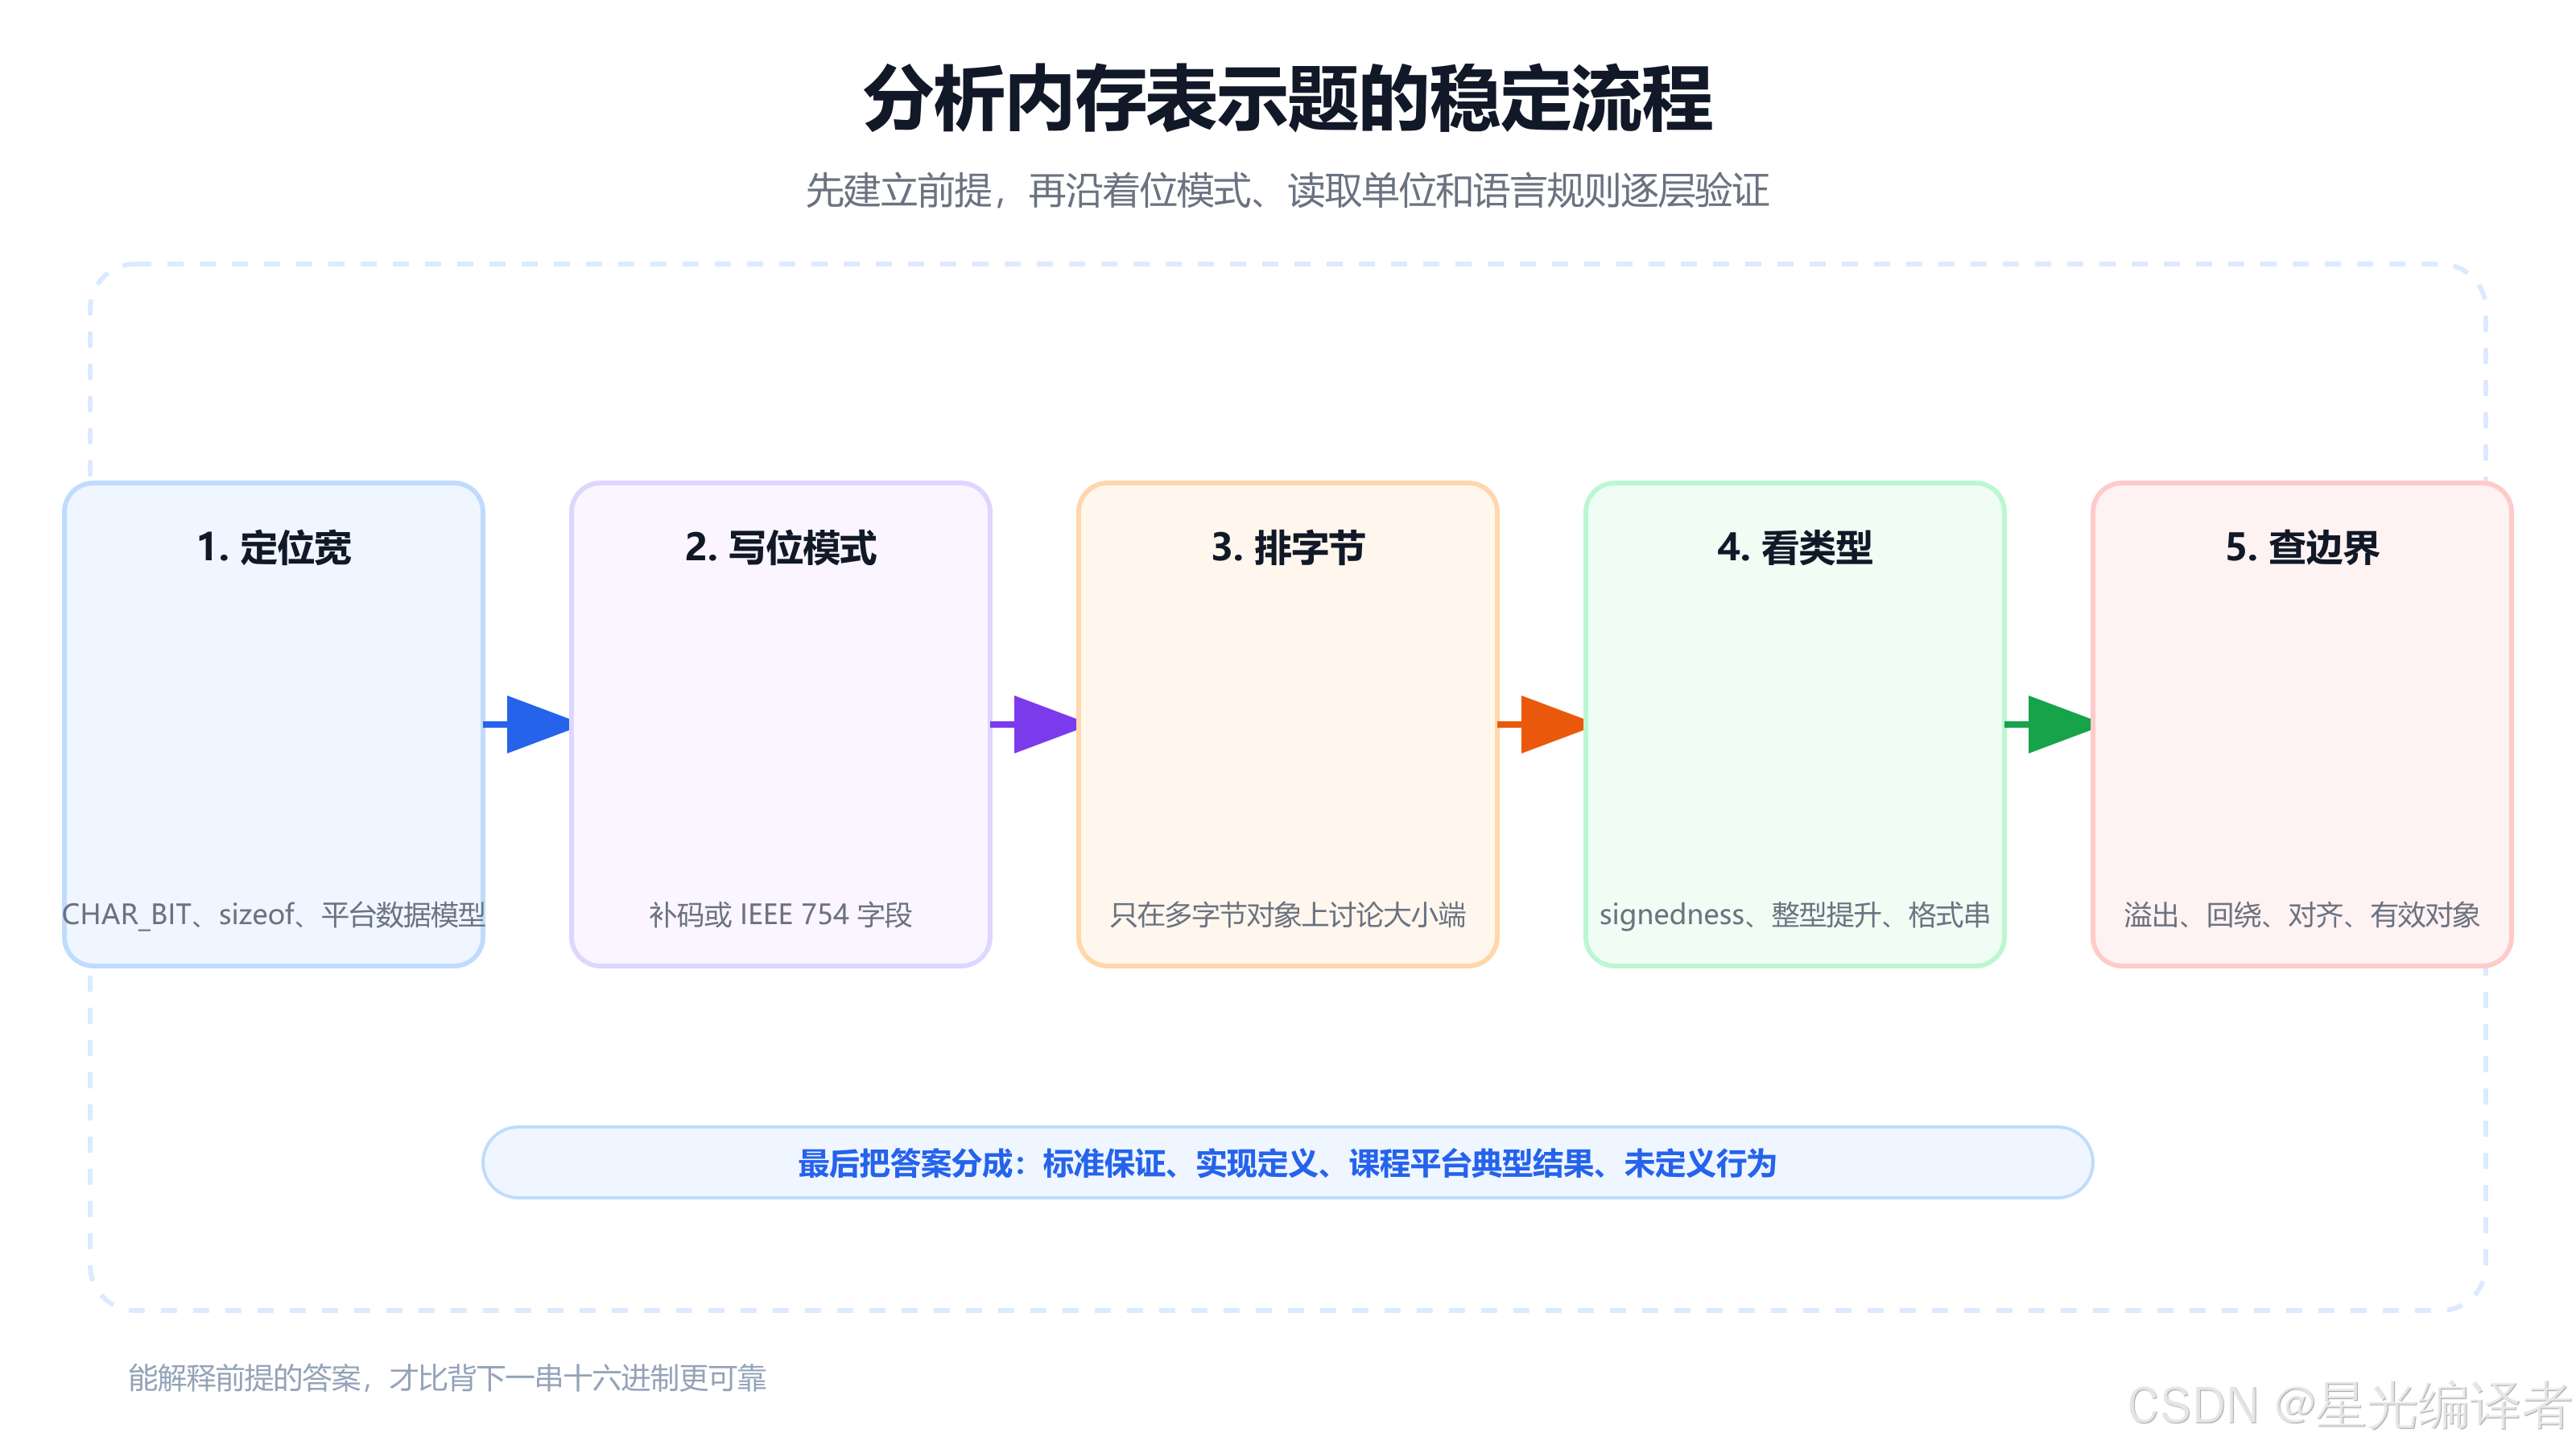
10.1 五步分析法
第一步:确定平台前提。
先问清楚 CHAR_BIT、sizeof、有符号表示、浮点格式与端序。题目若没有说明,只能给出带前提的典型结果。
第二步:写出完整位模式。
整数按固定位宽写补码;浮点按 S/E/F 字段编码。不要只写"它是负数"或"它是 9.0",而要落到每一位。
第三步:按地址排列字节。
对象超过一个字节时,再根据大端或小端安排字节。单字节对象没有多字节端序问题。
第四步:检查类型与提升。
确认是 char、signed char 还是 unsigned char;传入 printf 后提升成什么;格式说明符是否与实参类型匹配。
第五步:检查语言边界。
关注有符号溢出、无符号回绕、越界、对齐、指针到整数转换、有效类型、严格别名和对象生命周期。
最后把答案归类:
- 标准保证的结论;
- 实现定义或未指定的结果;
- 特定课程平台上的典型现象;
- 程序已有未定义行为,不能给出可移植答案。
10.2 高频问答
Q1:补码与小端是一回事吗?
不是。补码描述有符号整数的位模式;小端描述多字节对象各字节的地址顺序。先得到补码,再讨论它的字节怎样排列。
Q2:为什么 unsigned char 特别适合查看内存?
它没有填充位,能够表示一个字节的所有可能位模式,而且 C 允许通过字符类型左值检查任意对象的表示。
Q3:char 一定是 8 位吗?
不一定。C 规定一个字节就是 sizeof(char) 的单位,但每字节的位数由 CHAR_BIT 给出,最少为 8。主流通用平台通常为 8。
Q4:无符号溢出是未定义行为吗?
不是。无符号运算按模 2^N 进行。真正危险的是把它忘记后写出永不终止的条件。有符号整数溢出则属于未定义行为。
Q5:大小端会改变 0x11223344 的数值吗?
不会。在同一类型内正常读取时,处理器会按本机规则还原相同数值。端序差异在逐字节检查、文件、网络和跨平台序列化时显现。
Q6:把 float 强转成 int 能得到其位模式吗?
不能。数值转换 (int)f 会舍弃小数并换算数值。若要复制位模式,使用 memcpy;若实现与语言版本提供明确的位转换工具,也应按其文档使用。
Q7:为什么 0.1 + 0.2 常常不精确等于 0.3?
因为这些十进制小数在二进制中通常是无限循环小数,有限尾数只能保存邻近值。比较浮点结果时应根据问题尺度选择误差容限,而不是机械使用 ==。
Q8:NaN 为什么不等于自己?
NaN 代表无效或未定义的数值结果。IEEE 754 的普通比较把它视为无序,x == x 对 NaN 也为假。检测应使用 isnan(x)。
10.3 动手练习
- 在 8 位宽度下分别写出
25、-25、127、-128的补码。 - 画出
uint32_t x = 0xA1B2C3D4u;在大端与小端机器上的四个地址单元。 - 预测
unsigned char c = 255; printf("%d\n", c);在INT_MAX >= 255时的结果,并说明默认参数提升。 - 解释
for (size_t i = n - 1; i >= 0; --i)的问题,并给出至少一种正确写法。 - 手算
-5.0f的 binary32 符号位、阶码与尾数。 - 写一个函数,用
memcpy返回float的uint32_t位模式,并在编译期或运行期检查二者大小相同。 - 分别说明
0x00000000、0x80000000、0x7F800000、0x7FC00000在 binary32 下的类别。
参考答案要点:
25为00011001,-25为11100111,127为01111111,-128为10000000。- 小端从低地址到高地址为
D4 C3 B2 A1,大端为A1 B2 C3 D4。 c提升为int 255,%d与提升后的类型匹配,输出255。size_t是无符号类型,i >= 0恒真;可写for (size_t i = n; i-- > 0; )。-5.0 = -1.01₂ × 2^2,所以S=1、E=129=10000001₂、F=010000...。- 用
uint32_t bits; memcpy(&bits, &value, sizeof bits);,前提是sizeof value == sizeof bits。 - 依次为
+0、-0、+∞、NaN。
总结
数据在内存中并不自带"这是整数""这是浮点数"的标签。补码规定有符号整数如何编码;大小端决定多字节对象如何映射到递增地址;signed、unsigned 与整数提升决定同一个字节进入表达式后得到什么值;IEEE 754 则用符号、阶码和尾数在有限位宽中表示极大、极小以及特殊浮点值。
课程里的 char、无符号循环、地址偏移和 float * 题之所以容易出错,是因为它们同时混合了多个层次。稳定方法不是背下 255、4,2000000 或 1091567616,而是坚持这条链路:
确定位宽 → 写出位模式 → 排列字节 → 按类型解释 → 检查提升与格式 → 验证对象边界和语言规则。
当你能明确区分"标准保证""实现定义""课程平台典型结果"和"未定义行为"时,内存题就不再是靠机器碰运气的谜题,而会变成一套能够逐步验证的推理过程。