策略学习
概述
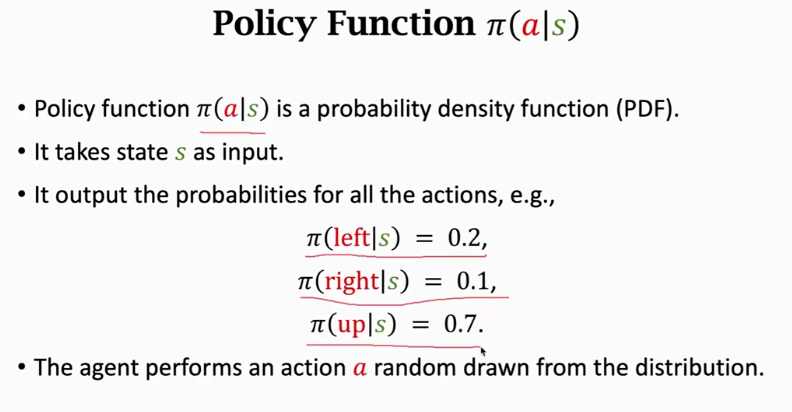
这节课我们学习 Policy-Based Reinforcement Learning 策略学习,我们要用一个神经网络来近似策略函数,这个神经网络叫做 Policy Network 策略网络,它可以用来控制 Agent 运动。想要训练这个神经网络,就要用到 Policy Gradient 算法,Policy Gradient 算法是这节课的重点。我们回顾一下 Policy Function 策略函数,然后看看怎么用神经网络来近似策略函数。前面我们学过策略函数了,策略函数叫做 π(a∣s)\pi(a|s)π(a∣s),它是个概率密度函数,我们可以用它来自动控制 Agent 运动。策略函数的输入是当前状态 SSS,它的输出是一个概率分布,给每一个动作 AAA 一个概率值。举个超级玛丽的例子,把当前状态 SSS 作为输入,π\piπ 函数会输出三个概率值,每个动作对应一个概率值,比如向左动作的概率值是 0.20.20.2,向右是 0.10.10.1,向上的概率是 0.70.70.7。这个例子里面 π\piπ 函数的输入是状态 SSS,输出是个三维向量,每一个元素是一个动作的概率。有了这三个概率值,Agent 就会做一次随机抽样,得到了动作 AAA,左、右、上这三个动作都有可能被抽到,但是向上被抽到的概率最大是 0.70.70.7,随机抽样得到了动作 AAA,Agent 就做 AAA 这个动作。
策略网络
只要有了一个好的策略函数 π\piπ,我们就可以用 π\piπ 来自动控制 Agent 运动,但问题是我们怎么样才能得到这样一个策略函数呢?假如一个游戏只有五个状态、十个动作,那很好办,我们画一张 5×10⁵ \times 105×10 的表,表里面每一格对应一个概率,我们通过玩游戏把这 505050 个概率值算出来就好了。
但是超级玛丽这样的游戏有无数个状态,根本不可能把每一个状态和每一个动作对应的概率记在一张表里。想要 Agent 自动玩超级玛丽这样的游戏,我没有办法直接算策略函数,所以我们得做函数近似,学出来一个函数来近似策略函数。函数近似的方法有多种多样,可以用线性函数,可以用 Kernel 函数,也可以用神经网络.
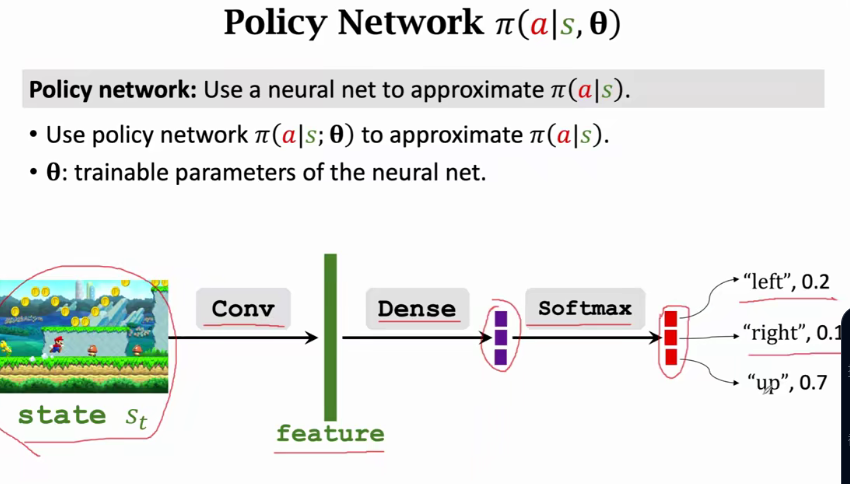
如果用神经网络的话,我们就把这个神经网络称为 Policy Network 策略网络,把它记为 π(a∣s;θ)\pi(a|s;\theta)π(a∣s;θ),这里的 θ\thetaθ 是神经网络的参数。一开始 θ\thetaθ 是随机初始化的,然后我们通过学习来改进 θ\thetaθ。如果是超级玛丽这个问题,我们可以把策略网络设计成这个样子:输入是状态 SSS,也就是当前屏幕上显示的画面(也可以是最近几帧的画面),然后是一个或者几个卷积层,把画面变成特征向量,然后全连接层把特征向量映射到一个三维向量,由于有三个动作,所以这里的维度是三。随后要用 Softmax 激活函数,这样的输出才是一个概率分布。输出的是一个三维向量,每一个元素对应一个动作,里面的值都是动作的概率,比如第一个值等于 0.20.20.2,意思是向左的概率是 0.20.20.2;第二个值是 0.10.10.1,对应向右的动作;第三个值是 0.70.70.7,对应向上的动作。由于策略函数 π\piπ 是一个概率密度函数,所以 π\piπ 必须满足这个性质:对于所有可能的动作 AAA(比如左、右、上),把 π\piπ 函数的输出全都加起来,必须要等于 111。这个例子里面 0.2+0.1+0.7=10.2 + 0.1 + 0.7 = 10.2+0.1+0.7=1,这个是概率密度函数的性质,这就是为啥一定要在这里放一个 Softmax 激活函数,Softmax 可以让输出的都是正数,而且加和等于 111。
回顾
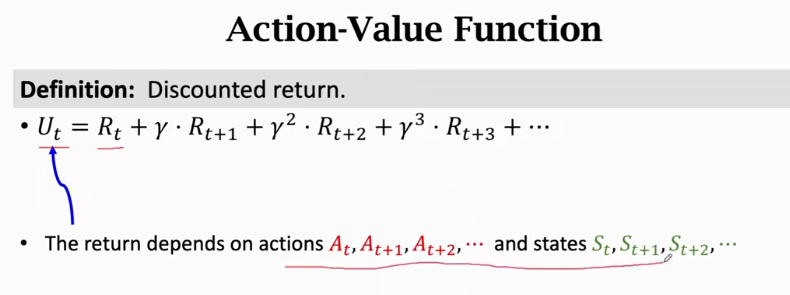
首先回顾一下 Discount Return 折扣回报 UtU_tUt,它的定义是从 ttt 时刻开始,未来所有奖励 RRR 的加权求和。在 ttt 时刻,未来的奖励 RRR 还没有观测到,它们都是随机变量,所以用大写字母表示。每个奖励 RRR 的随机性都来自于前一时刻的动作 AAA 和状态 SSS,动作的随机性来自于策略函数 π\piπ ,状态的随机性来自于状态转移函数 ppp 。由于 UtU_tUt 是所有奖励的加和,UtU_tUt 的随机性来自于未来所有的动作和状态。
动作价值函数
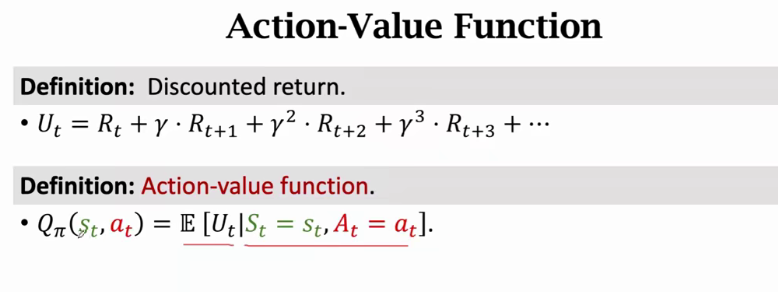
Action-Value Function 动作价值函数 QπQ_\piQπ 是 UtU_tUt 的条件期望,这个期望把 t+1t+1t+1 时刻以后的动作 AAA 和状态 SSS 都消掉了,QπQ_\piQπ 只依赖于当前时刻的状态 StS_tSt 和动作 AtA_tAt。QπQ_\piQπ 还依赖于策略函数 π\piπ,用不同的 π\piπ 得到的 QπQ_\piQπ 就不一样,QπQ_\piQπ 可以评价在状态 StS_tSt 的情况下做出动作 AtA_tAt 的好坏程度。
状态价值函数
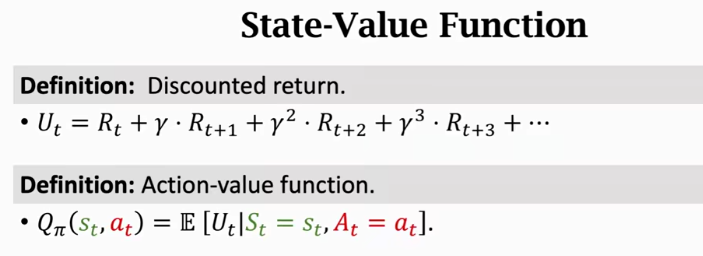
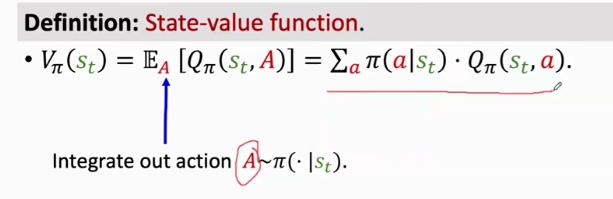
下一个概念 State-Value Function 状态价值函数 VπV_\piVπ,VπV_\piVπ 是 QπQ_\piQπ 的期望,把 QπQ_\piQπ 中的动作 AAA 给积掉,这里的动作 AAA 被当成随机变量,概率密度函数是 π\piπ。把动作 AAA 给消掉了,这样一来 VπV_\piVπ 只跟策略函数 π\piπ 和当前状态 SSS 有关了。给定策略函数 π\piπ,VπV_\piVπ 可以评价当前状态的好坏,VπV_\piVπ 越大说明当前的胜算越大。给定状态 SSS,VπV_\piVπ 可以评价策略 π\piπ 的好坏,如果 π\piπ 很好,VπV_\piVπ 就会比较大,说明胜算大;反之,如果 π\piπ 不好,VπV_\piVπ 就会比较小,说明胜算小。如果 AAA 是离散变量,比如像左、向右、向上这样的动作,QπQ_\piQπ 的期望就可以这样展开:对于所有动作 AAA,把 QπQ_\piQπ 与概率密度函数 π\piπ 的内积做连加,这样 AAA 就被消掉了。假如 AAA 是个连续变量,比如从 000 到 111 之间所有的实数,这样的话就要用积分来代替连加。
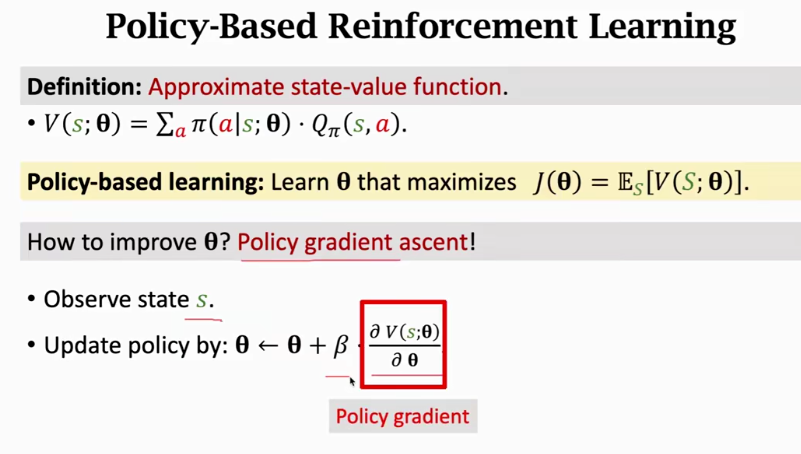
下面讲 Policy-Based Reinforcement Learning,可以翻译成策略学习。刚才我们得到了 State-Value Function 状态价值函数 VπV_\piVπ,现在我们来用神经网络近似 VπV_\piVπ。刚才我们已经用了神经网络来近似策略函数 π\piπ,我们把 VπV_\piVπ 中的策略函数 π\piπ 替换成了神经网络,VπV_\piVπ 就变成了 V(s;θ)V(s;\theta)V(s;θ),这里的 θ\thetaθ 是神经网络中的参数。现在我要讲策略学习的主要思想:我们刚才用了策略网络来近似策略函数,这样一来,状态价值函数就可以近似写成 V(s;θ)V(s;\theta)V(s;θ)。VVV 可以评价状态 SSS 和策略网络的好坏,给定状态 SSS,策略网络越好,那么 VVV 的值就越大。那么,怎么样让策略网络变得越来越好呢?我们可以改进模型参数 θ\thetaθ,让 V(s;θ)V(s;\theta)V(s;θ) 变大。基于这个想法,我们就可以把目标函数定义为 V(s;θ)V(s;\theta)V(s;θ) 的期望,记作 J(θ)J(\theta)J(θ)。这个期望是关于状态 SSS 求的,这里把状态 SSS 作为一个随机变量,用期望给去掉,这样一来,变量就只剩下 θ\thetaθ 了。目标函数 J(θ)J(\theta)J(θ) 就是对策略网络的评价,策略网络越好,J(θ)J(\theta)J(θ) 就越大。所以呢,策略学习 Policy-Based Learning 的目标就是改进 θ\thetaθ,使得 J(θ)J(\theta)J(θ) 越大越好。怎么样改进 θ\thetaθ 呢?我们要用到 Policy Gradient 算法,翻译成策略梯度算法。让 Agent 玩游戏,每一步都会观测到一个不同的状态 SSS,这个 SSS 就相当于是从状态的概率分布中随机抽样出来的。观测到状态 SSS,把 V(s;θ)V(s;\theta)V(s;θ) 关于 θ\thetaθ 求导得到一个梯度,然后用梯度上升来更新 θ\thetaθ,这里的 β\betaβ 是学习率。其实这就像是随机梯度上升,我们算的不是真正的梯度------真正的梯度是目标函数 J(θ)J(\theta)J(θ) 关于 θ\thetaθ 的导数,这里我们算的是 VVV 关于 θ\thetaθ 的导数,其实就是个随机梯度,随机性来源于 SSS。为什么要用梯度上升呢?因为我们想让目标函数 J(θ)J(\theta)J(θ) 变得越来越大。这里 VVV 关于 θ\thetaθ 的导数就被叫做 Policy Gradient 策略梯度,我接下来要讲具体怎么算 Policy Gradient。
想要学习策略网络,需要用到策略梯度算法。策略梯度是 VVV 函数对神经网络参数 θ\thetaθ 的导数。接下来我要讲怎么样求导、怎么样近似计算策略梯度。刚才我们定义了 V(s;θ)V(s;\theta)V(s;θ),它是对 State-Value Function 的近似,这里的 π(a∣s;θ)\pi(a|s;\theta)π(a∣s;θ) 是策略网络,θ\thetaθ 是神经网络的参数。策略梯度就是 VVV 对 θ\thetaθ 的导数。
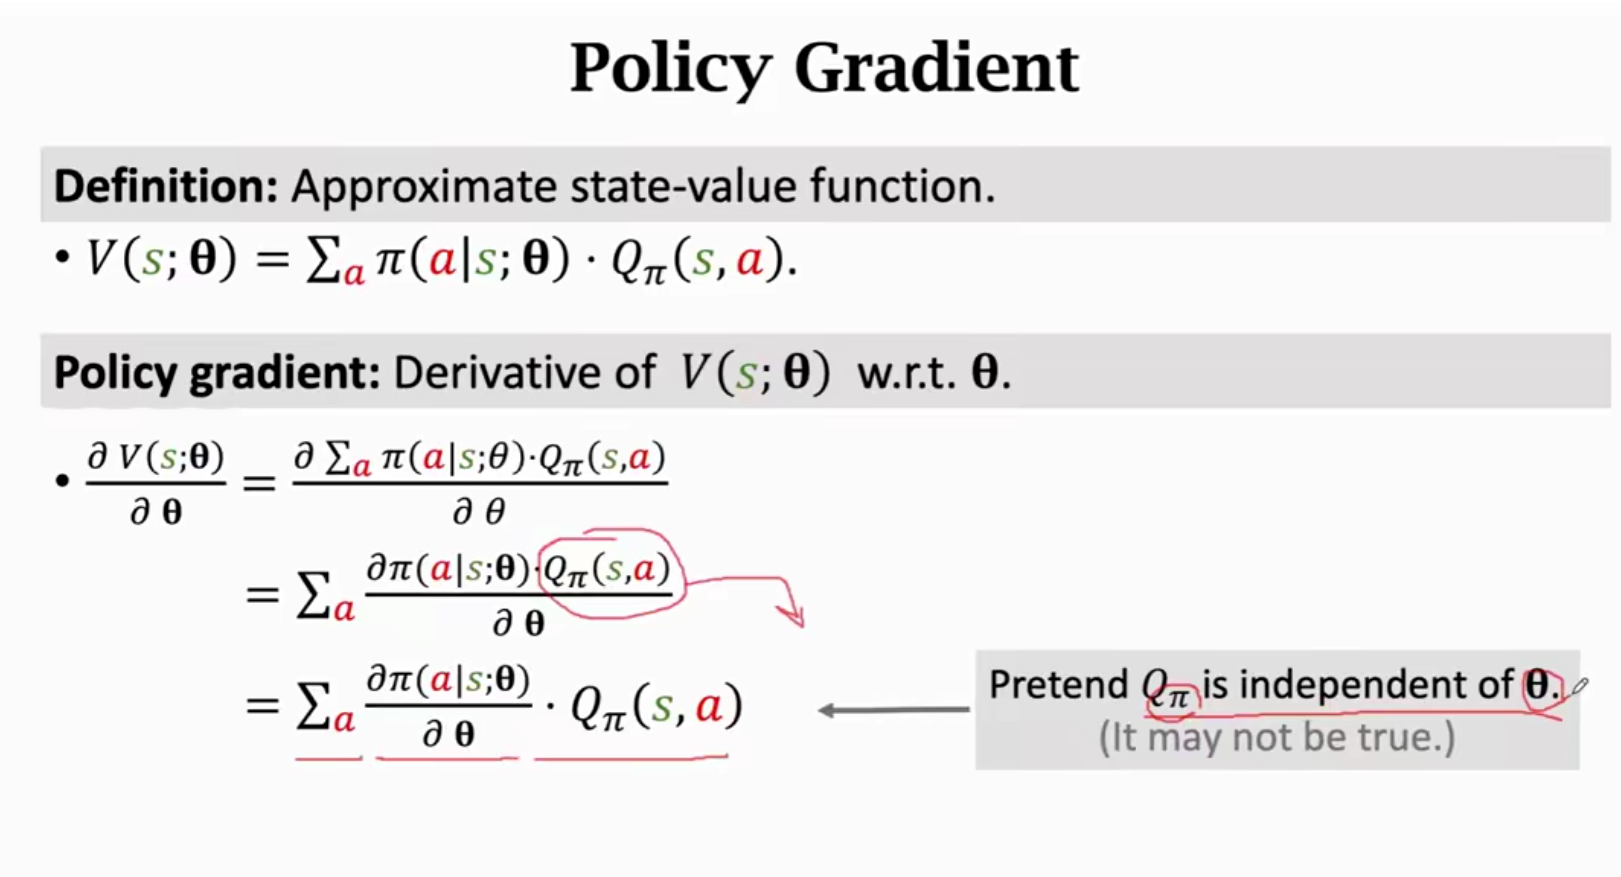
下面我要做数学推导,把导数算出来。根据定义,VVV 就是这个连加:V=∑aπ(a∣s;θ)⋅QπV = \sum_a \pi(a|s;\theta) \cdot Q_\piV=∑aπ(a∣s;θ)⋅Qπ。VVV 对 θ\thetaθ 求导就是这个连加对 θ\thetaθ 求导,可以把求导运算推到连加里面去,这样一来,连加的导数就成了导数的连加。为了简化推导,我假设 QπQ_\piQπ 不依赖于 θ\thetaθ,这样就可以把 QπQ_\piQπ 当做一个常数,从求导运算里面给提取出来,放到导数的外面。于是我们就得到了等式右边:把 π\piπ 关于 θ\thetaθ 求导再乘以 QπQ_\piQπ,然后做连加。这里我做了个假设 QπQ_\piQπ 不依赖于 θ\thetaθ,这个假设其实不太对,因为 QπQ_\piQπ 跟 π\piπ 有关,而 θ\thetaθ 是 π\piπ 的参数,所以 QπQ_\piQπ 跟 θ\thetaθ 还是有关的。这个推导并不严谨,我做这个简化只是为了让你们容易理解。这样我就得到了这个策略梯度的公式:策略梯度等于函数 π\piπ 关于 θ\thetaθ 求导乘以 QπQ_\piQπ,然后关于 AAA 做连加。如果动作 AAA 是离散的,直接用这个公式就能把策略梯度给算出来。
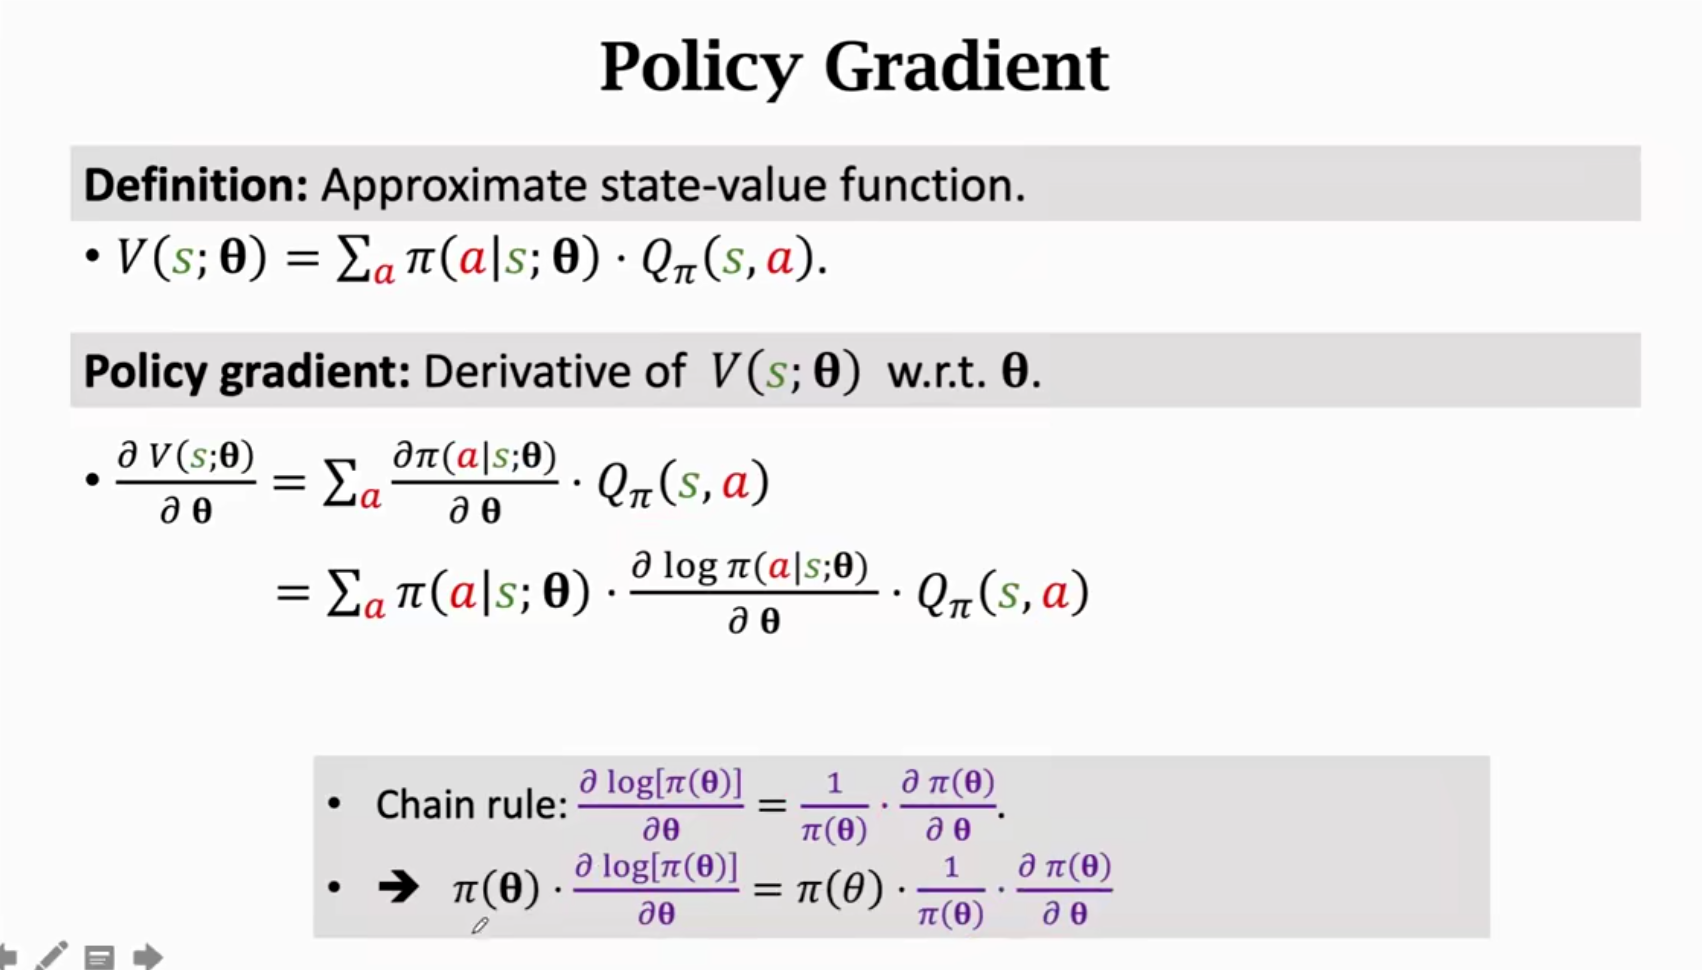
然而实际应用的时候通常不会用这个公式来算策略梯度,实际用的通常都是这个策略梯度的蒙特卡洛近似。我接下来推导就是为了做近似。π\piπ 关于 θ\thetaθ 的导数可以写成 π×logπ\pi \times \log \piπ×logπ 关于 θ\thetaθ 的导数。这一步是怎么来的呢?从上往下不太好推,但是从下往上的验证会很容易。我们来验证一下,用一下链式法则和 Log 函数的性质:logπ\log \pilogπ 关于 θ\thetaθ 求导可以写成 π\piπ 分之一,再乘以 π\piπ 关于 θ\thetaθ 的导数。
(推导如果你会的话可以不看 )这个 π\piπ 分之一是怎么来的呢?这是 Log 函数的性质,你拿 logx\log xlogx 关于 xxx 求导就会得到 xxx 分之一。拿 π\piπ 乘以这个导数,把导数展开,就得到了 π×π\pi \times \piπ×π 分之一再乘以 π\piπ 关于 θ\thetaθ 的导数。π\piπ 和 π\piπ 分之一可以抵消,只剩下 π\piπ 关于 θ\thetaθ 的导数。这样我就证明了 π×logπ\pi \times \log \piπ×logπ 关于 θ\thetaθ 的导数等于 π\piπ 关于 θ\thetaθ 的导数。我已经完成了从下往上的推导,我证明了圈出来的这两项相等,所以等式成立。最后这个等式比较容易理解:π\piπ 是个概率密度函数,π\piπ 乘以圈出来的这一项,再关于动作 AAA 做连加,就等于对圈出来的这一项求期望,求期望的时候把 AAA 当成随机变量,π\piπ 是动作 AAA 的概率密度函数。前面我说了,我这种推导过于简化了,其实是不严谨的,这个推导只是为了帮助大家理解策略梯度是怎么来的。实际上呢,还有一项要把 QπQ_\piQπ 也关于 θ\thetaθ 求导,不过你不用太在意这个细节,即使把 QπQ_\piQπ 对于 θ\thetaθ 的导数也考虑进去,得到的最终结果也是一样的。如果你只是实际用一下 Policy Gradient 算法,你就这么理解算法推导就可以了。
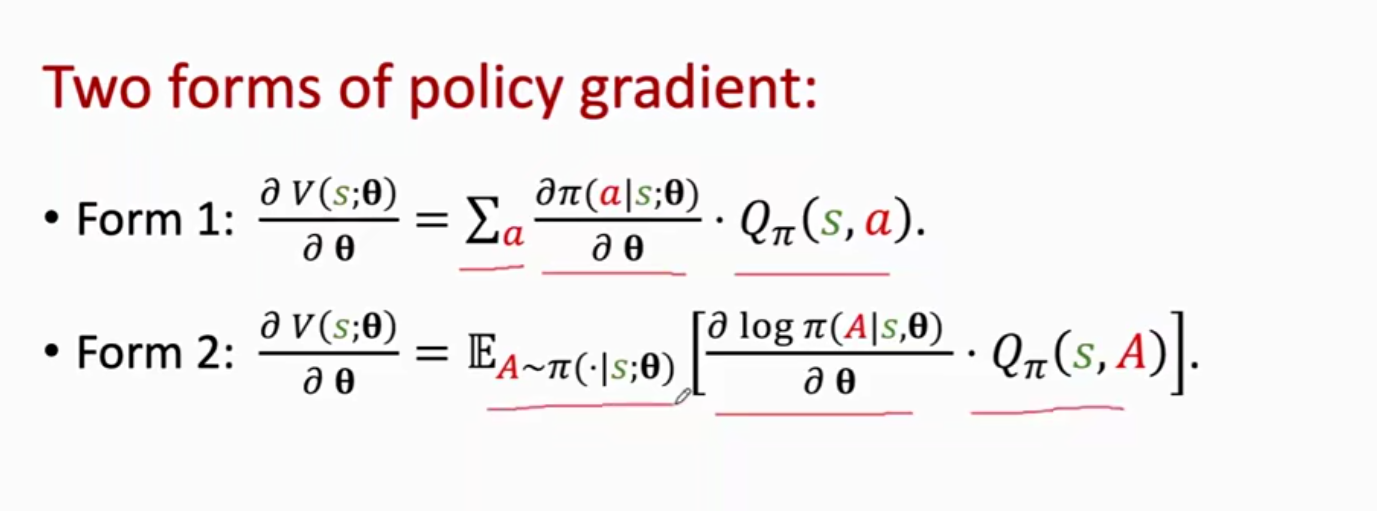
我们已经推导出了策略梯度的两种等价形式。第一种是 π\piπ 关于 θ\thetaθ 的导数乘以 QπQ_\piQπ 再做连加;第二种是 logπ\log \pilogπ 关于 θ\thetaθ 的导数乘以 QπQ_\piQπ 再关于随机变量 AAA 求期望。这两种形式是等价的。
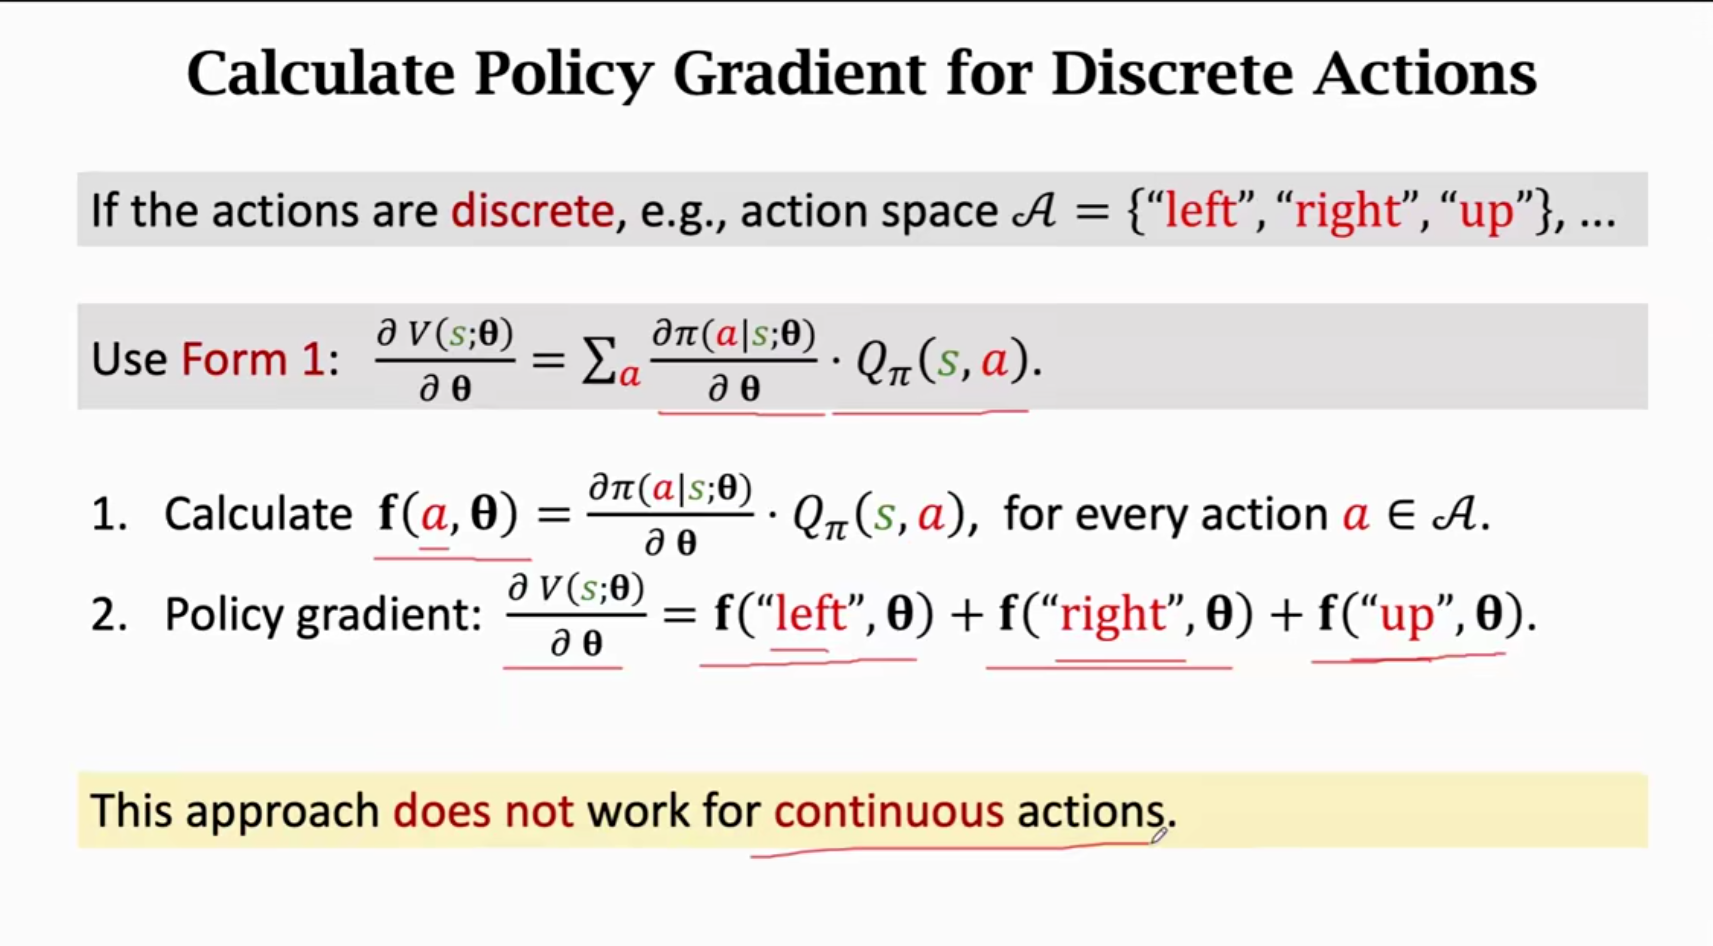
有了前面两个公式,我们就可以实际计算策略梯度了。如果动作是离散的,比如动作是向左、向右、向上,我们就可以用第一种公式:π\piπ 关于 θ\thetaθ 的导数乘以 QπQ_\piQπ 再做连加。具体怎么计算策略梯度呢?把连加里面的东西 π\piπ 关于 θ\thetaθ 的导数乘以 QπQ_\piQπ 记作函数 fa(θ)f_a(\theta)fa(θ),对于每一个动作 AAA,比如向左、向右、向上,都把 fa(θ)f_a(\theta)fa(θ) 的值计算出来就好了。根据上面的公式,策略梯度就是把这些 fa(θ)f_a(\theta)fa(θ) 全都加起来:策略梯度等于 fleft(θ)+fright(θ)+fup(θ)f_{\text{left}}(\theta) + f_{\text{right}}(\theta) + f_{\text{up}}(\theta)fleft(θ)+fright(θ)+fup(θ)。
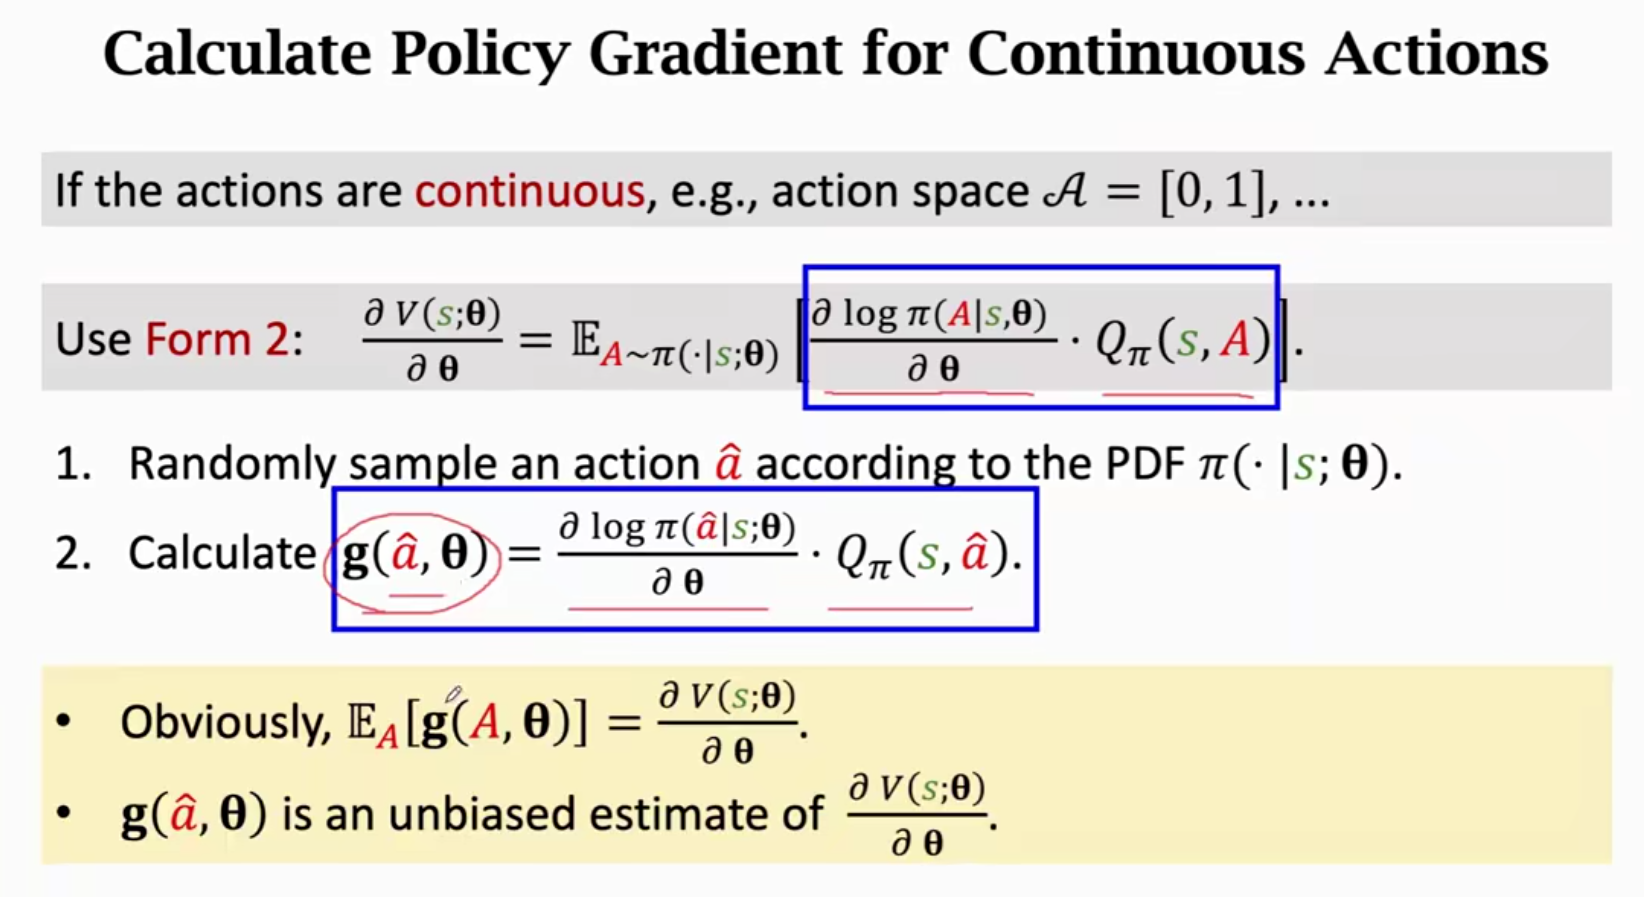
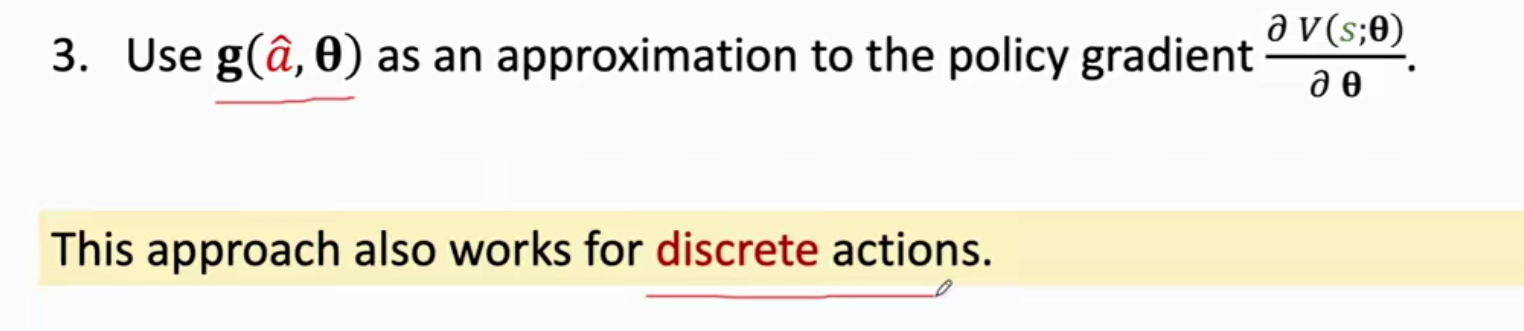
对于离散的动作,用这个公式没有问题,我们可以把所有的动作 AAA 都枚举出来,比如向左、向右、向上,然后计算 fa(θ)f_a(\theta)fa(θ) 的函数值,再把它们都加起来就可以了。可是这个方法不适用于连续的动作------假如动作是 000 到 111 之间所有的实数,那么就有无穷多个动作,我们不可能枚举出每一个这样的动作。对于连续的动作,比如动作空间 AAA 是 000 到 111 之间所有的实数,我们可以用策略梯度的第二种公式:logπ\log \pilogπ 关于 θ\thetaθ 的导数乘以 QπQ_\piQπ 再关于随机变量 AAA 求期望。AAA 是连续变量,所以呢,想要直接求这个期望,就需要做定积分。但是积分是做不到的,因为 π\piπ 函数是个神经网络,非常复杂,我们没有办法直接用数学公式把这个复杂的积分给算出来。所以我们只好做蒙特卡洛近似,把这个期望给近似算出来。蒙特卡洛近似是这么做的:随机抽样得到一个动作 A^\hat{A}A^,抽样是根据概率密度函数 π\piπ 来抽的,比如从 000 到 111 这个集合里抽样,我碰巧得到 0.20.20.2,就用 0.20.20.2 作为动作 A^\hat{A}A^。我们看一下这个公式,期望括号里面的是 logπ\log \pilogπ 关于 θ\thetaθ 的导数乘以 QπQ_\piQπ,我们把期望括号里面的 logπ\log \pilogπ 关于 θ\thetaθ 的导数乘以 QπQ_\piQπ 记为 g(A^,θ)g(\hat{A}, \theta)g(A^,θ)。这里的 A^\hat{A}A^ 是一个确定的动作,比如 A^=0.2\hat{A} = 0.2A^=0.2,有了 A^\hat{A}A^,直接算一下 g(A^,θ)g(\hat{A}, \theta)g(A^,θ) 的值就好了。根据函数 ggg 的定义,很显然 g(A,θ)g(A, \theta)g(A,θ) 关于 AAA 求期望就等于策略梯度。由于 A^\hat{A}A^ 是根据概率密度函数 π\piπ 随机抽出来的,所以呢,g(A^,θ)g(\hat{A}, \theta)g(A^,θ) 是策略梯度的一个无偏估计。由于 g(A^,θ)g(\hat{A}, \theta)g(A^,θ) 是策略梯度的无偏估计,所以可以用 g(A^,θ)g(\hat{A}, \theta)g(A^,θ) 来近似策略梯度,这叫做蒙特卡洛近似。蒙特卡洛就是抽一个或者很多个随机样本,用随机样本来近似期望。更新模型参数 θ\thetaθ 的时候,用 g(A^,θ)g(\hat{A}, \theta)g(A^,θ) 来作为近似的梯度就可以了,不用计算出精确的策略梯度,即使你想算精确的梯度,你也算不出来。其实这种方法对于离散的动作也是适用的,比如从向左、向右、向上这三个动作中做随机抽样,要是碰巧抽到了向左这个动作,那就让 A^\hat{A}A^ 等于向左,然后算 g(A^,θ)g(\hat{A}, \theta)g(A^,θ) 的函数值,用它来近似策略梯度。
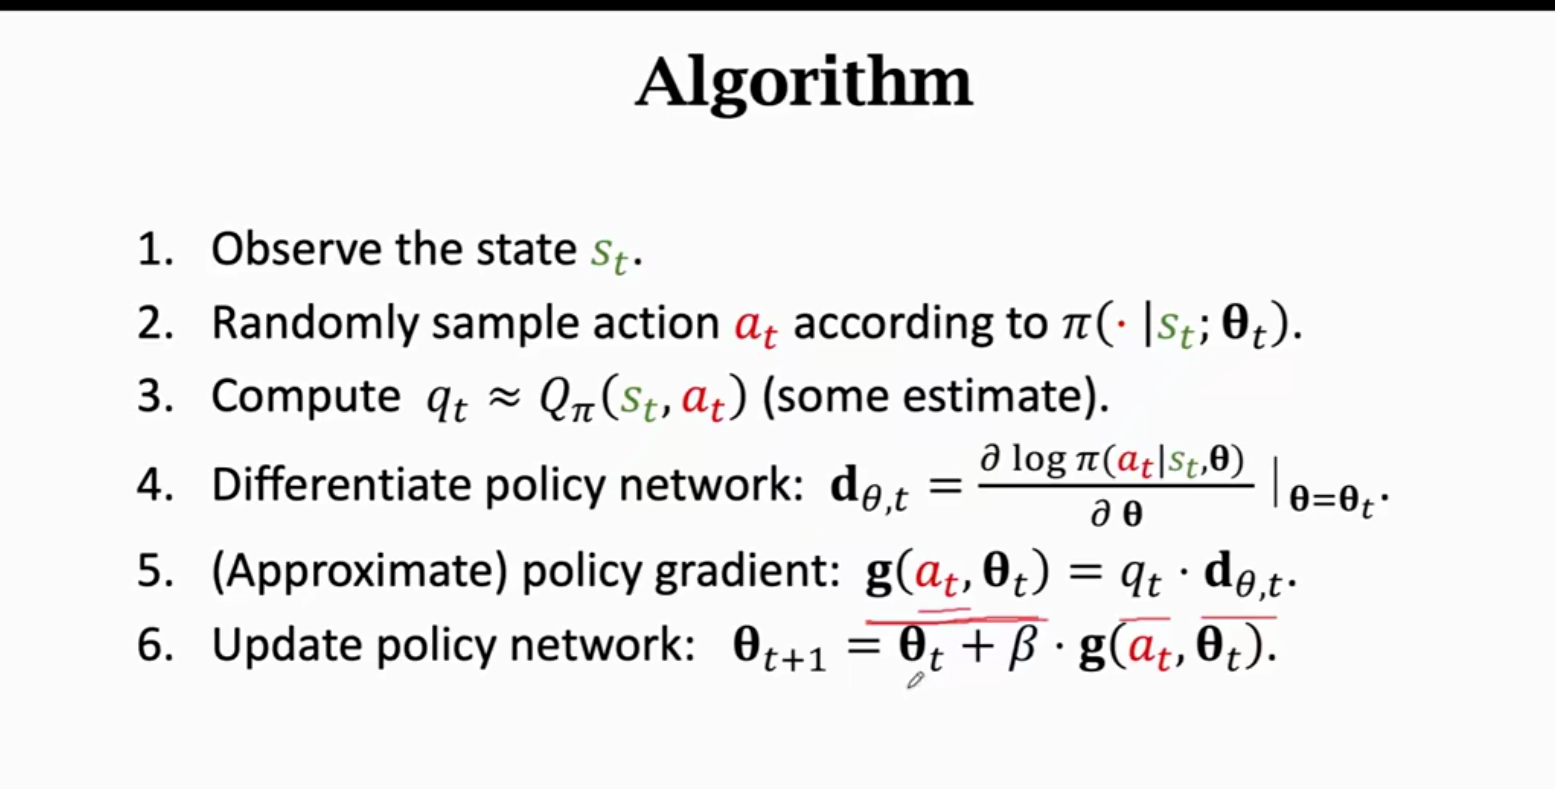
我们已经推导出了 Policy Gradient 策略梯度,并且知道怎么样用策略梯度来学习 Policy Network 策略网络。下面我来总结一下策略梯度算法。在第 ttt 个时间点观测到了状态 StS_tSt。接下来,我们用蒙特卡洛近似来计算策略梯度:把策略网络 π\piπ 作为概率密度函数,用它随机抽样得到一个动作 AtA_tAt,比如说 AtA_tAt 是向左的动作。第三步是计算价值函数 QπQ_\piQπ 的值,把结果记作小 qtq_tqt。第四步是对策略网络 π\piπ 求导,算出 logπ\log \pilogπ 关于参数 θ\thetaθ 的导数,得到的结果 dθ,td_{\theta,t}dθ,t 是向量、矩阵或者是张量,dθ,td_{\theta,t}dθ,t 的大小跟 θ\thetaθ 是一样的,如果 θ\thetaθ 是 1000×10001000 \times 10001000×1000 的矩阵,那么 dθ,td_{\theta,t}dθ,t 也是 1000×10001000 \times 10001000×1000 的矩阵。TensorFlow 和 PyTorch 这些系统都支持自动求梯度,你告诉系统 AtA_tAt、StS_tSt 还有当前参数 θt\theta_tθt,系统可以自动求出来梯度 dθ,td_{\theta,t}dθ,t。第五步是近似的算策略梯度。之前我们已经推导过怎么样用一个随机样本 AAA 来算策略梯度的蒙特卡洛近似。定义 g(At,θt)=qt×dθ,tg(A_t, \theta_t) = q_t \times d_{\theta,t}g(At,θt)=qt×dθ,t。由于 AtA_tAt 是根据 π\piπ 随机抽样得到的样本,g(At,θt)g(A_t, \theta_t)g(At,θt) 就是策略梯度的蒙特卡洛近似。最后一步,有了近似的策略梯度,就可以用它来更新策略网络的参数 θ\thetaθ 了:旧的参数 θt\theta_tθt 加上学习率 β\betaβ 乘以梯度 ggg 就得到了新的参数 θt+1\theta_{t+1}θt+1。这是一步梯度上升,目的是让价值函数 VVV 变大。这就是策略梯度算法,每一轮迭代都做这六步。算法里还有个没解决的问题:Action-Value Function 动作价值函数 QπQ_\piQπ 是什么呢?我们并不知道 QπQ_\piQπ,所以没有办法算这个函数值小 qtq_tqt。我们该怎样近似计算这个函数值小 qtq_tqt 呢?有两个办法近似小 qtq_tqt。第一个办法叫做 Reinforce 算法,算法是这样的:用策略网络 π\piπ 来控制 Agent 运动,从一开始一直玩到游戏结束,把整个游戏的轨迹都记录下来:s1,a1,r1,s2,a2,r2,...s_1, a_1, r_1, s_2, a_2, r_2, \ldotss1,a1,r1,s2,a2,r2,... 一直到最后 sT,aT,rTs_T, a_T, r_TsT,aT,rT。观测到了所有的奖励 RRR,我们就可以算出来 Return UtU_tUt,用这个公式 UtU_tUt 是所有奖励 RRR 的加权求和。由于价值函数 Qπ(st,at)Q_\pi(s_t, a_t)Qπ(st,at) 是 UtU_tUt 的期望,我们可以用 UtU_tUt 的观测值 utu_tut 来近似 QπQ_\piQπ。所以呢,Reinforce 算法就是用观测到的小 utu_tut 来代替 QπQ_\piQπ 函数。Reinforce 算法需要玩完一局游戏,观测到所有的奖励,然后才能更新策略网络。计算价值函数 QπQ_\piQπ 的另一种办法就是用一个神经网络来做函数近似,原本已经用神经网络近似了策略函数 π\piπ,现在拿另一个神经网络来近似价值函数 QπQ_\piQπ。这样就有了两个神经网络,一个被称为 Actor,一个被称为 Critic,这样就有了 Actor-Critic 方法。我下节课来讲 Actor-Critic 方法。
总结一下这节课的内容。这节课讲了 Policy-Based Method 策略学习,我们希望得到一个策略函数 π\piπ,然后用 π\piπ 自动控制 Agent 运动。每当 Agent 观测到状态 StS_tSt,Agent 就用 π\piπ 函数算出来一个概率分布,然后随机抽样得到动作 AtA_tAt。直接求策略函数比较困难,所以我们要用神经网络来近似策略函数,这个神经网络被称为 Policy Network 策略网络,记作 π(a∣s;θ)\pi(a|s;\theta)π(a∣s;θ)。θ\thetaθ 是神经网络的参数,一开始随机初始化,然后通过 Policy Gradient 策略梯度算法来学习参数 θ\thetaθ。这节课的主要内容就是推导策略梯度和计算策略梯度。策略梯度是价值函数 VVV 关于 θ\thetaθ 的导数。算出了策略梯度,就做梯度上升来更新参数 θ\thetaθ。为什么要做梯度上升呢?因为我们希望价值函数 VVV 越大越好。目标函数是 VVV 关于状态 SSS 的期望,这个目标函数可以理解为使用策略函数 π\piπ 时 Agent 的平均胜算有多大。策略函数越好,这个目标函数就会越大,Agent 的平均胜算也就越大。这节课就到这里,谢谢大家观看。上节课我们讲了价值学习,这节课讲了策略学习,要是把价值学习和策略学习结合起来,就有了 Actor-Critic 方法,我们下节课讲 Actor-Critic 方法。