1.LLM必须支持视觉
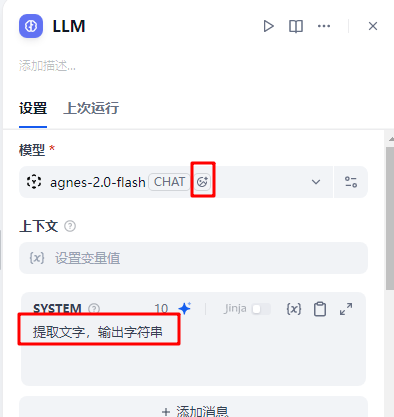
LLM必须要本身支持视觉,然后是dify中的设置。
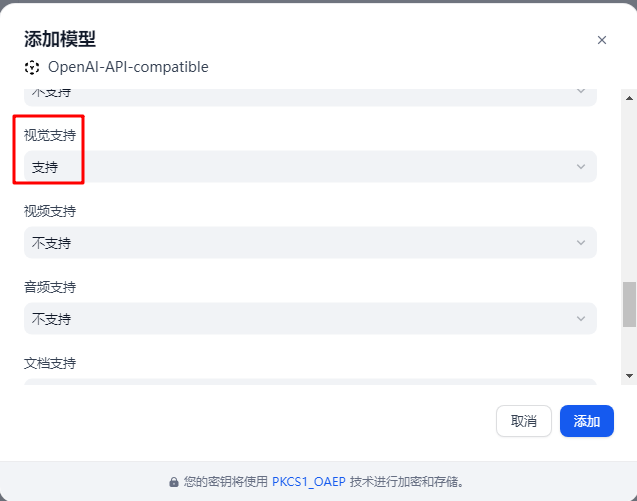
添加LLM的时候必须开启
如果是已经添加的模型,可以修改设置
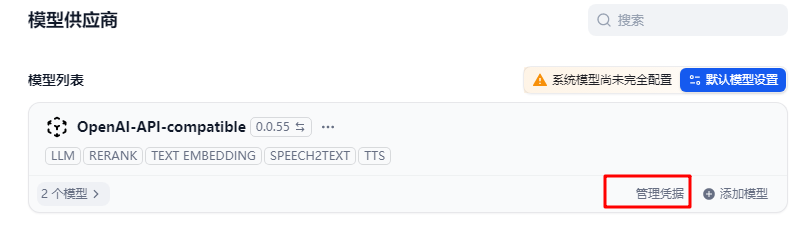
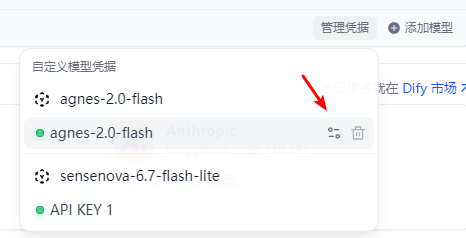
点击后就可以改了。
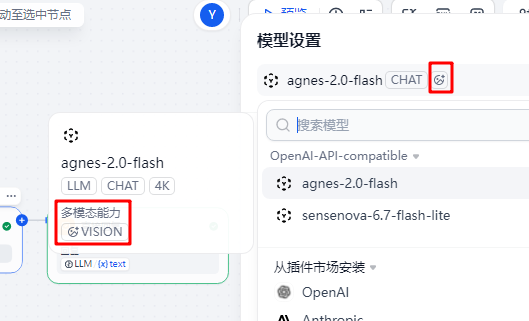
工作流编排的时候可以查看
2.编排节点
比较简单。一个LLM节点就行了
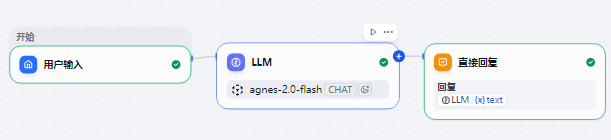
LLM节点设置,必须使用支持视觉的LLM
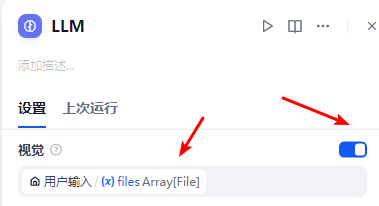
开启LLM节点的视觉功能
可以是多张图片,但是测试的时候不要使用同一张图片,实测发现使用同一张图片的话没有作用,像这样
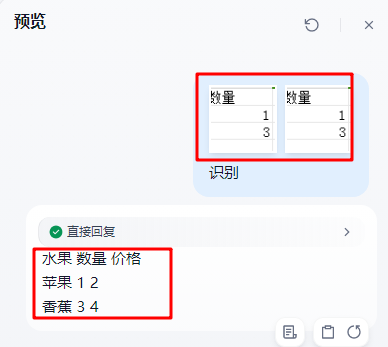
使用不同的图片就没问题
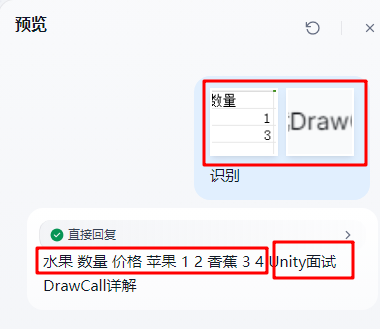
或者改成迭代的方式。
1.LLM必须支持视觉
LLM必须要本身支持视觉,然后是dify中的设置。
添加LLM的时候必须开启
如果是已经添加的模型,可以修改设置
点击后就可以改了。
工作流编排的时候可以查看
2.编排节点
比较简单。一个LLM节点就行了
LLM节点设置,必须使用支持视觉的LLM
开启LLM节点的视觉功能
可以是多张图片,但是测试的时候不要使用同一张图片,实测发现使用同一张图片的话没有作用,像这样
使用不同的图片就没问题
或者改成迭代的方式。