Django 6.0 自带 Tasks 到底能不能替代 Celery?跑完 3 组后台任务后我有答案了
Django 6.0 第一次把 Tasks 框架放进了核心。看到 @task、enqueue()、队列名、优先级和任务结果这些 API,很多人的第一反应都是:以后 Django 项目是不是可以删掉 Celery 了?
我没有只看发布说明,而是在隔离环境中安装 Django 6.0.7、Celery 5.6.3,并连接本机 Redis,真实运行了三组 1.5 秒任务:
- 普通同步函数;
- Django 自带的
ImmediateBackend和DummyBackend; - Redis + 独立 Celery Worker。
先给结论:Django Tasks 不能单独替代 Celery。它统一了"如何声明和提交任务",但不提供生产可用的消息队列与 Worker。Celery 解决的是任务如何被可靠地搬运、执行、重试和监控。
这两者不是简单的新旧替代关系,而是位于不同层次。
Django 6.0 到底内置了什么
Django 官方对 Tasks 框架的定义非常克制:它提供后台工作的"contract and plumbing",也就是任务契约和连接管道,而真正执行任务的引擎留给外部基础设施。
最小任务可以这样定义:
python
from django.tasks import task


@task
def generate_report(report_id):
    # 生成报表
    return {"report_id": report_id, "status": "done"}
调用时不是 Celery 的 delay(),而是 Django 自己的 enqueue():
python
result = generate_report.enqueue(42)Tasks API 还定义了这些通用概念:
priority:任务优先级;queue_name:目标队列;backend:使用哪个任务后端;run_after:最早执行时间;TaskResult:任务状态、尝试次数、错误与返回值;enqueue()/aenqueue():同步与异步提交接口。
这很重要。过去每个任务库都有自己的装饰器、调用方法和结果对象;Django 6.0 开始提供框架级统一接口,让业务代码有机会减少对具体队列实现的直接依赖。
但统一接口不等于任务已经在后台执行。
两个自带 Backend 都不是生产 Worker
Django 6.0 自带两个后端。
ImmediateBackend:名字叫 Task,实际仍在当前进程执行
默认配置就是 ImmediateBackend:
python
TASKS = {
    "default": {
        "BACKEND": "django.tasks.backends.immediate.ImmediateBackend",
    }
}
它会在调用 enqueue() 时立刻执行任务。如果任务耗时 1.5 秒,请求仍然要等待 1.5 秒。
它适合:
- 本地开发;
- 单元测试;
- 在真正的队列基础设施上线前,先改造业务调用接口。
它不具备把耗时工作移出 Web 请求进程的能力。
DummyBackend:返回得很快,因为它根本不执行
DummyBackend 会记录入队任务,方便测试检查,但不会执行任务函数:
python
TASKS = {
    "default": {
        "BACKEND": "django.tasks.backends.dummy.DummyBackend",
    }
}
所以看到它在 1 ms 内返回,不能解释为"Django 后台任务性能惊人"。它只是把任务保存为测试记录,状态停留在 READY。
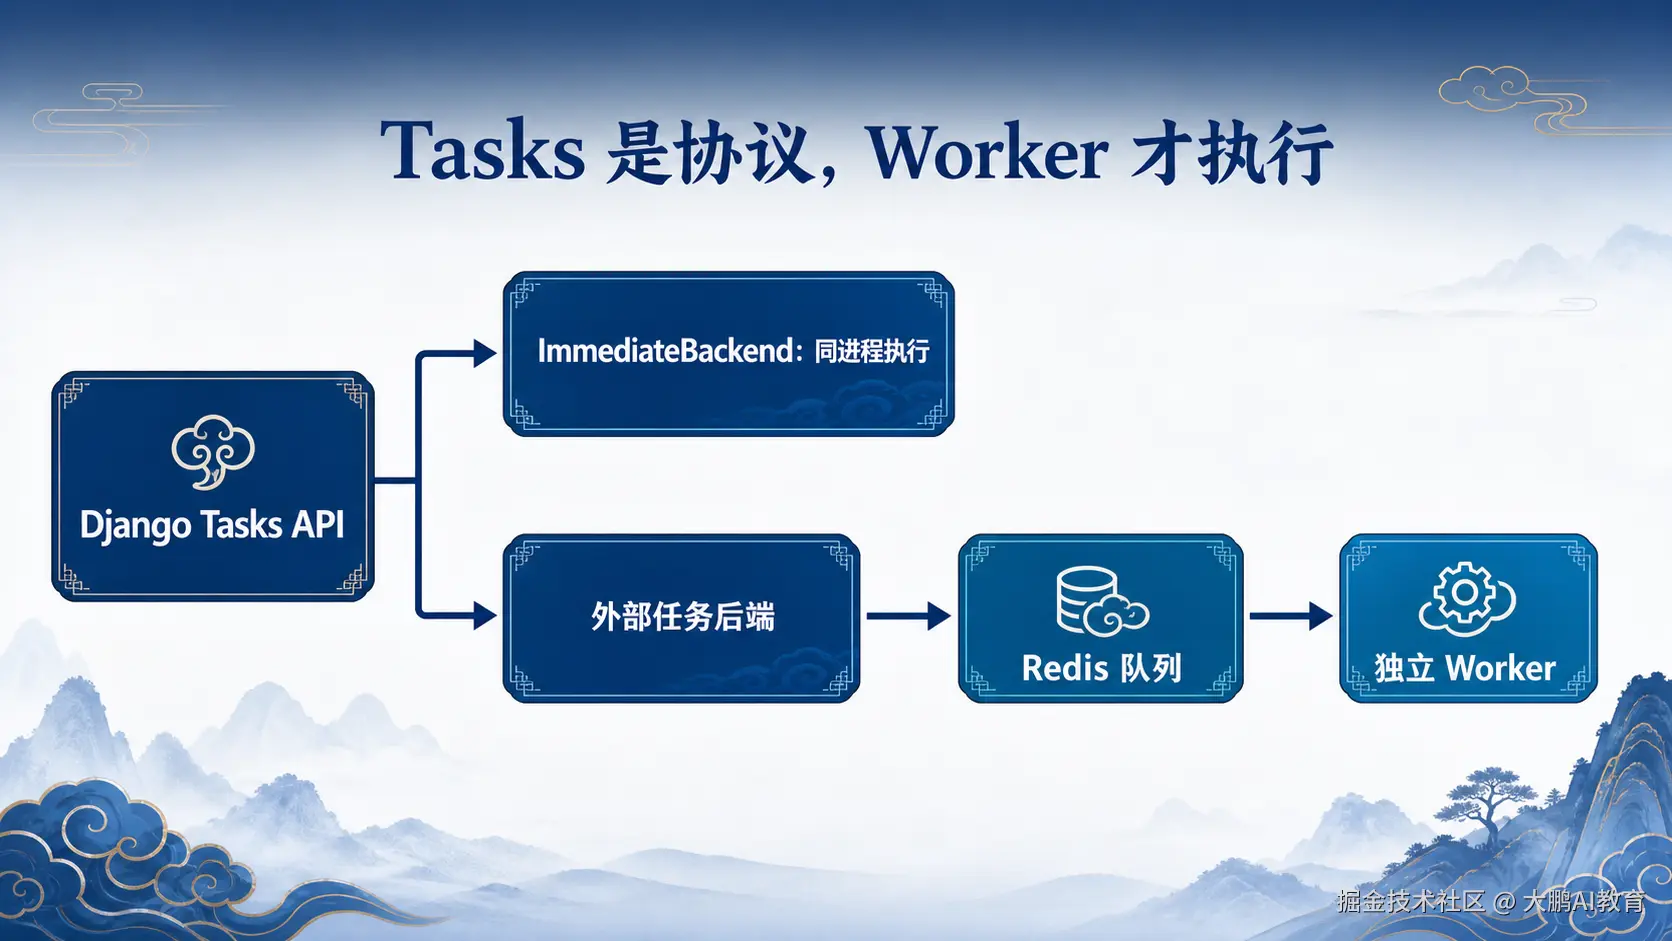
官方文档也明确说明:Django 内置的只有开发和测试后端,生产可用后端需要额外配置。
实战步骤与验证结果
测试环境如下:
| 项目 | 配置 |
|---|---|
| Python | 3.12 |
| Django | 6.0.7 |
| Celery | 5.6.3 |
| Broker | Redis,本地独立数据库编号 |
| Worker | 单独进程,--pool=solo |
| 任务内容 | sleep(1.5) 模拟邮件、报表或文件处理 |
| 轮数 | 5 轮 |
测试任务故意返回执行进程 PID,用来判断它到底在 Web/请求进程里运行,还是被独立 Worker 接走。
第一组:普通同步函数
python
def slow_job(delay_seconds):
    time.sleep(delay_seconds)
    return {"worker_pid": os.getpid()}
直接调用时,请求进程必须等待任务结束。
第二组:Django ImmediateBackend 与 DummyBackend
python
from django.tasks import task


@task
def django_slow_job(delay_seconds):
    return slow_job(delay_seconds)


immediate_result = django_slow_job.enqueue(1.5)
dummy_result = django_slow_job.using(backend="dummy").enqueue(1.5)
ImmediateBackend 会真正执行;DummyBackend 只记录任务。
第三组:Redis + 独立 Celery Worker
Celery 任务如下:
python
from celery import Celery

app = Celery(
    "django_tasks_demo",
    broker="redis://127.0.0.1:6379/13",
    backend="redis://127.0.0.1:6379/14",
)


@app.task
def celery_slow_job(delay_seconds):
    time.sleep(delay_seconds)
    return {"worker_pid": os.getpid()}
启动独立 Worker:
powershell
python -m celery -A celery_app:app worker `
  --pool=solo `
  --queues=ruyi_django_tasks_demo
提交任务并记录入队返回时间:
python
started = time.perf_counter()
result = celery_slow_job.delay(1.5)
enqueue_ms = (time.perf_counter() - started) * 1000
实验里调用 result.get() 只是为了确认 Worker 最终执行完成并记录总耗时。真实 Web 请求里通常不应在提交任务后立刻 get(),否则又会把异步流程等成同步流程。
五轮真实结果
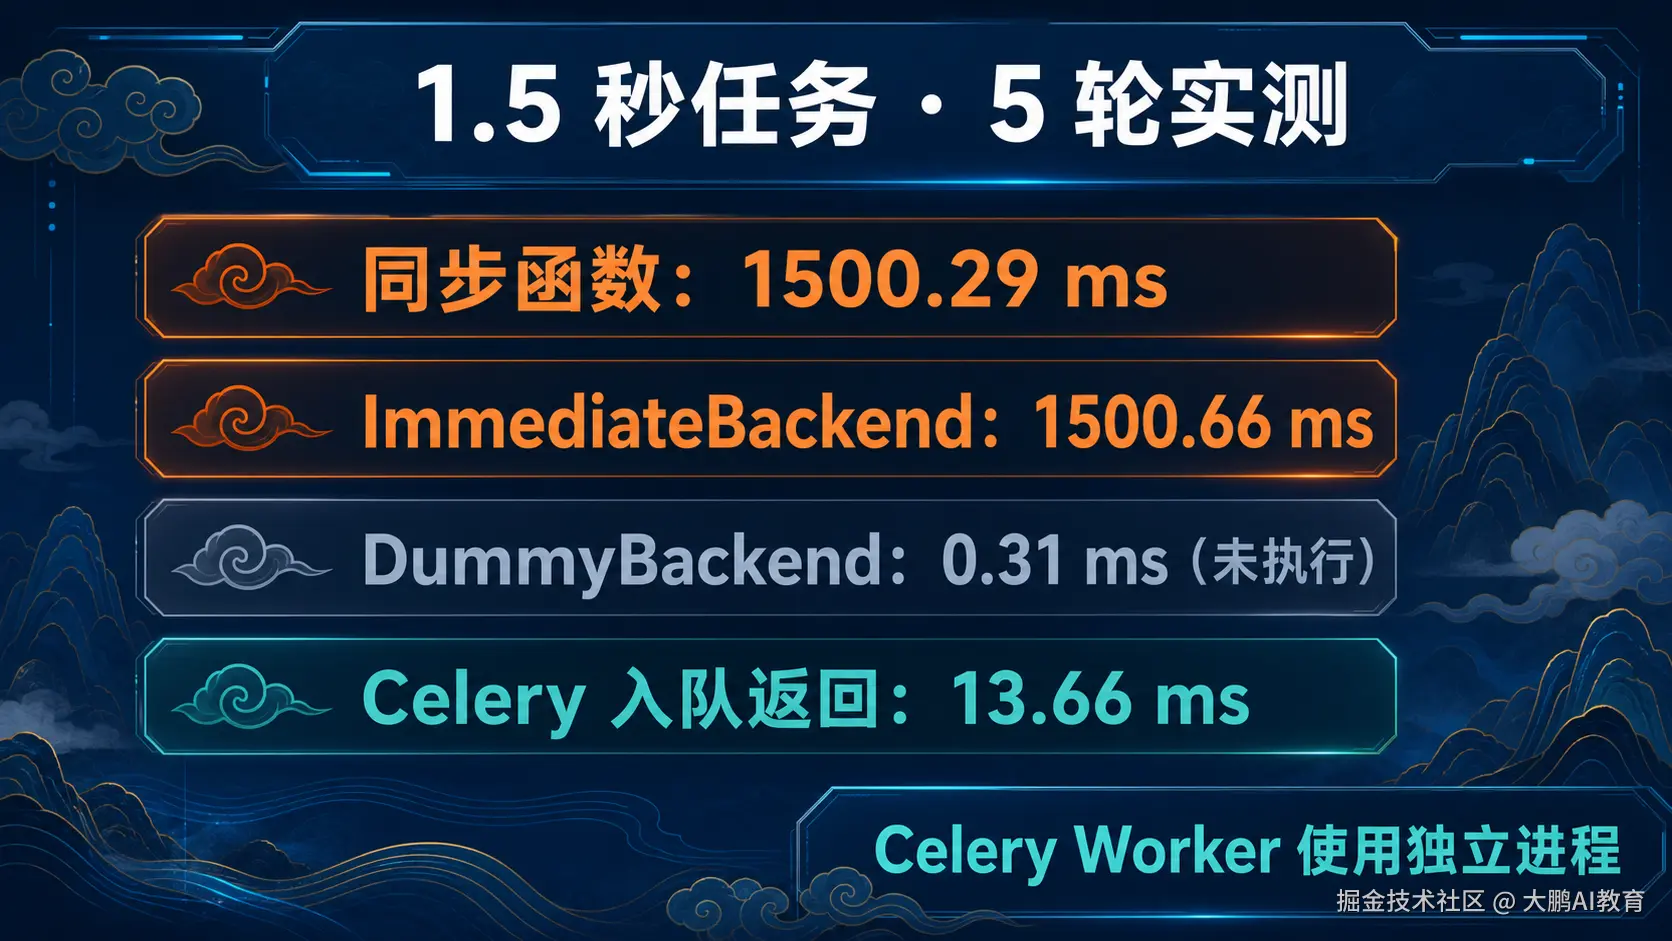
| 方案 | 平均返回时间 | 最小值 | 最大值 | 是否执行 | 执行进程 |
|---|---|---|---|---|---|
| 同步函数 | 1500.29 ms | 1500.18 ms | 1500.54 ms | 是 | 请求进程 PID 42268 |
Django ImmediateBackend |
1500.66 ms | 1500.39 ms | 1501.24 ms | 是 | 请求进程 PID 42268 |
Django DummyBackend |
0.31 ms | 0.16 ms | 0.84 ms | 否 | 无 |
| Celery 入队返回 | 13.66 ms | 0.68 ms | 65.18 ms | 是 | Worker PID 37412 |
Celery 任务的平均完整完成时间是 1515.71 ms。任务本身并没有被"加速":它仍然需要约 1.5 秒。真正改变的是 Web 请求只负责把消息送进队列,耗时工作由另一个进程完成。
这也是后台任务最关键的价值:不是让工作凭空变快,而是让请求线程不用陪它一起等。
首轮 Celery 入队时间较高,主要包含首次建立 Broker 连接的成本;后续轮次最低降到 0.68 ms。因此不能拿一次冷启动结果代表长期吞吐,也不能把这组本地数据直接当成生产性能承诺。
Django Tasks 和 Celery 的能力边界
| 能力 | Django 6.0 Tasks 核心 | Celery |
|---|---|---|
| 统一任务声明与入队接口 | 是 | 有自己的 API |
| 自带生产 Worker | 否 | 是 |
| 自带生产消息传输 | 否 | 支持 Redis、RabbitMQ 等 Broker |
| 重试、路由、并发控制 | 取决于外部 Backend | 成熟支持 |
| 定时与复杂工作流 | 取决于外部 Backend | Celery Beat、Canvas 等生态 |
| 测试时立即执行或只记录 | 内置支持 | 可用 eager 等配置 |
| 结果监控与运维工具 | 取决于 Backend | 有成熟生态 |
所以"Django Tasks 能不能替代 Celery"需要拆成两个问题:
- 能不能替代 Celery 的业务调用接口? 有可能。使用兼容的生产 Backend 后,业务可以围绕 Django 的
@task与enqueue()编写。 - 能不能替代 Celery 的队列、Worker 和运维能力? Django 核心本身不能。
新项目到底应该怎么选
选择 Django Tasks + 生产 Backend
适合这些情况:
- 新建 Django 6.0 项目,希望先统一任务接口;
- 任务模型简单,以发邮件、生成缩略图、轻量数据处理为主;
- 已经验证某个外部 Backend 支持所需的延迟、优先级、结果查询和异步任务能力;
- 希望未来更换任务实现时,尽量少改业务层。
不要只看 Backend 能否安装。Django Tasks 为后端定义了 supports_defer、supports_priority、supports_get_result、supports_async_task 等能力标志,选型时应逐项核对。
继续使用 Celery
适合这些情况:
- 现有系统已经稳定使用 Celery;
- 需要任务重试、限流、路由、多队列、定时任务或复杂工作流;
- 需要多台机器或多类 Worker;
- 已有 Redis/RabbitMQ、监控和部署体系;
- 团队已经积累 Celery 故障处理经验。
仅仅因为 Django 6.0 新增 Tasks,就把成熟 Celery 系统整体重写,通常没有收益。
三个最容易踩的坑
坑一:把 enqueue 当成一定异步
enqueue() 的真实行为由 Backend 决定。默认 ImmediateBackend 仍会阻塞当前调用者。
坑二:测试很快,就以为生产可用
DummyBackend 不执行任务;ImmediateBackend 不离开当前进程。两者都不能证明生产队列正常。
坑三:数据库事务还没提交,Worker 已经开跑
创建订单后立刻提交邮件任务时,Worker 可能早于数据库事务提交读取订单。通用做法是提交成功后再入队:
python
from django.db import transaction

transaction.on_commit(lambda: generate_report.enqueue(report_id))
Celery 的 Django 集成也提供 delay_on_commit() 来处理这一常见场景。任务参数最好传主键等稳定标识,让 Worker 执行时重新读取最新数据,而不是直接序列化整个模型对象。
Windows 实验需要特别说明
本文为了在本机完成可重复验证,Celery Worker 使用了 --pool=solo。Celery 官方目前不承诺 Windows 支持,这个配置适合演示独立进程与消息队列链路,不代表生产部署建议。
生产环境通常应在 Linux 上根据任务类型评估 Worker 并发模型,并使用正式维护的 Redis 或 RabbitMQ 服务。
结论:Django Tasks 不能单独替代 Celery
Django 6.0 Tasks 最重要的意义,不是"Django 把 Celery 做进核心了",而是 Django 终于提供了一套框架级任务语言:
- 用
@task声明任务; - 用
enqueue()提交任务; - 用 Backend 隔离具体执行设施;
- 用统一的结果和能力模型描述任务状态。
但协议不会自己执行任务。没有生产 Backend、Broker 和 Worker,耗时工作仍然不会离开请求进程。
因此我的答案是:Django Tasks 可以降低业务代码对具体任务库的耦合,但它不能单独替代 Celery。对于已有复杂异步体系的项目继续用 Celery;对于 Django 6.0 新项目,可以优先采用 Tasks API,再认真选择生产 Backend。