在医疗记录、法律合同、客户反馈这些堆满文字的场景里,最头疼的问题往往不是缺数据,而是数据太乱,没法直接用。Google在2025年7月底推出的LangExtract,正是冲着这个痛点去的。它是一个基于大语言模型的Python库,核心本领是把没有格式、随手写就的文本,转换成干净、可验证、能追溯来源的结构化信息 。
🧭 它到底解决了什么问题
传统做信息抽取,要么靠人工一条条标注,慢且容易出错;要么直接把文本扔给大模型让它"随便提取一下",结果往往是模型编造内容,也就是常说的幻觉,抽出来的东西压根找不到出处,没法核实真假 。
LangExtract的思路是给模型套上"规矩"。开发者只需要写一段清晰的提示词,再给几个高质量的示例,模型就会照着这个模式去抽取信息,而且每一条抽取结果都会被精确映射回原文的字符位置。这意味着你能在原文里高亮看到每一个抽取项是从哪句话、哪几个字里蹦出来的,想核实真假直接一眼看穿,不用再靠猜 。
Google的两位机器学习工程师Akshay Goel和Atilla Kiraly在项目介绍里特别强调了这一点,他们把它称为精确的源头溯源,是整个工具设计里最看重的能力之一 。
🔍 核心功能拆解
LangExtract这套系统大致可以理解成一个"提示词加示例驱动抽取,再自动校验溯源"的流水线。整体逻辑可以简化成这样:
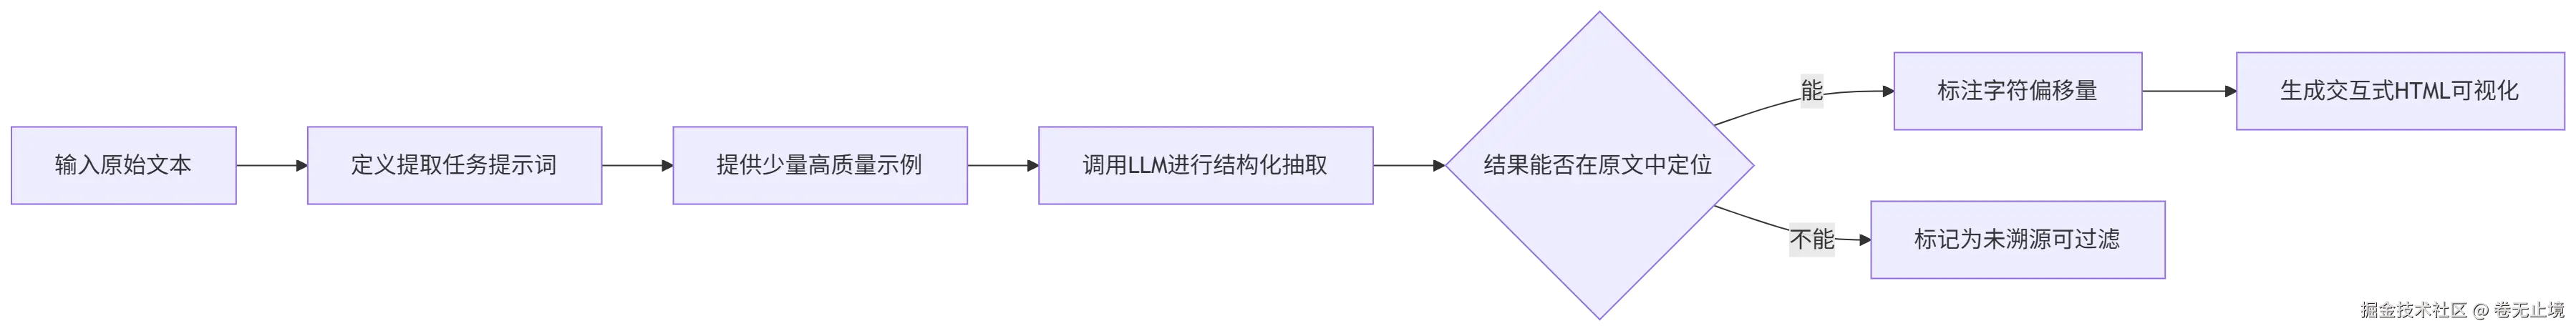
具体来说,它有这么几个比较突出的特性:
- 精确溯源,每个抽取结果都带字符级别的定位信息,方便可视化核对,也能自动识别模型"编造"出来、原文里根本找不到的内容并过滤掉
- 结构化输出有保障,通过少样本示例和受控生成(Controlled Generation)技术,在Gemini等支持的模型上强制输出遵循固定的模式,不会今天输出这样明天输出那样
- 长文档处理能力,针对大模型在超长上下文里"大海捞针"式检索容易漏掉信息的问题,LangExtract用分块处理、并行运算加多轮抽取的策略来提升召回率,官方拿《罗密欧与朱丽叶》全本做过实测
- 交互式可视化,几分钟内就能把原始文本变成一个自包含的HTML文件,里面可以浏览成千上万条标注结果,不需要额外搭建界面
- 模型后端灵活,除了Gemini系列,也支持OpenAI的模型,还能通过内置的Ollama接口跑本地开源模型,不完全绑定某一家
- 跨领域适配,只要给几个示例,不用微调模型就能把抽取任务迁移到医学、法律、金融等完全不同的领域
值得一提的是,它还能调用大模型自身的世界知识来补充抽取结果,也就是说除了原文里明确写出来的信息,模型还能根据自己的知识储备做一些合理推断。不过官方也提醒了,这种推断出来的信息准不准、靠不靠谱,很大程度上取决于所选模型的能力和提示词写得够不够精确 。
💡 实际用起来是什么样
上手门槛不算高,装好库以后,基本流程就是三步走,写提示词、给示例、跑抽取。官方文档用的示范案例是从莎士比亚台词里抽取人物、情绪和人物关系,一段简单的代码就能让模型学会这个抽取模式,再套用到新的文本上 。
真实场景的应用案例也不少。Google官方博客里提到了医疗药物信息抽取的例子,能从临床记录里把药名、剂量、用法这些信息结构化地提取出来 。有第三方作者专门写文章测试了它在处理杂乱临床笔记方面的表现,认为它在医疗文本结构化这类对准确性要求极高的场景里确实有实用价值 。
另外还有开发者演示过用LangExtract把PDF、HTML、Word文档这类杂乱格式的内容,转换成干净的知识图谱,为后续做检索增强生成(也就是常说的RAG)打基础 。项目本身也提供了一个放射科报告结构化的示范项目,叫RadExtract,专门针对医学影像报告这种半结构化文本做处理 。
从GitHub上的数据也能看出这个项目受关注的程度,短短一年不到的时间已经积累了近三万八千颗星标,两千六百多次分支,社区活跃度相当可观 。
📌 写在最后
LangExtract不是要取代人工审核,而是把"从一堆文字里挑出关键信息"这件重复又费神的工作,交给一套有据可查、能自动溯源的流程去完成。它最讨巧的地方在于,既借助了大模型强大的语言理解能力,又通过示例驱动和字符级溯源,把幻觉问题压到了可控范围,这在信息抽取这个对准确性极其敏感的领域里,算是找到了一个不错的平衡点。
如果你手头正好有大批未结构化的文本数据,无论是客服记录、合同条款还是研究论文,这类工具值得纳入自己的技术工具箱里试一试。毕竟比起从零手写正则表达式或者训练专门的抽取模型,用几个示例教会大模型该怎么做,效率上确实是降维打击。
参考资料:
google/langextract,GitHub仓库,github.com/google/lang...
Introducing LangExtract: A Gemini powered information extraction library,Google Developers Blog,developers.googleblog.com/introducing...
Can LangExtract Turn Messy Clinical Notes into Structured Data?,Medium,pandeyparul.medium.com/can-langext...
LangExtract: Turn Messy Text into Graph-RAG Insights,YouTube,www.youtube.com/watch?v=dPL...