- 🍨 本文为 🔗365天深度学习训练营中的学习记录博客
- 🍖 原作者: K同学啊
任务说明
本数据集记录了澳大利亚多个地点约 10 年的逐日天气观测,目标是据此预测 RainTomorrow(明天是否下雨)。本次在原有基础上加入了 EDA 环节,先从数据中找规律、再指导建模。在保证可运行的前提下,对各环节做了如下优化以提升准确率:
-
预处理:删除目标缺失样本;高缺失列用中位数填补,减少噪声。
-
编码:风向、月份改 sin/cos 周期编码,替代 LabelEncoder;Location 用独热编码。
-
特征工程:新增温差、气压差、湿度均值等物理含义明确的特征。
-
神经网络:tanh→relu+BatchNormalization;学习率 1e-4→Adam(1e-3)+ReduceLROnPlateau;epochs 10→80,配 EarlyStopping 恢复最优权重。
-
评估:训练曲线之外,补充混淆矩阵、分类报告、ROC-AUC,看清「下雨」类的召回。
一、导入数据
import numpy as np
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
import warnings
warnings.filterwarnings('ignore')

from sklearn.model_selection import train_test_split
from sklearn.preprocessing import MinMaxScaler
from sklearn.metrics import (classification_report, confusion_matrix,
                             roc_auc_score, accuracy_score)

import tensorflow as tf
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Dense, Dropout, BatchNormalization, Input
from tensorflow.keras.optimizers import Adam
from tensorflow.keras.callbacks import EarlyStopping, ReduceLROnPlateau

sns.set(style='whitegrid', palette='Set2')
RND = 42
np.random.seed(RND)
tf.random.set_seed(RND)
print('TensorFlow', tf.__version__)

TensorFlow 2.21.0

data = pd.read_csv('weatherAUS.csv')
df = data.copy()
print('数据规模:', data.shape)
data.head()

数据规模: (145460, 23)
|---|------------|----------|---------|---------|----------|-------------|----------|-------------|---------------|------------|-----|-------------|-------------|-------------|-------------|----------|----------|---------|---------|-----------|--------------|
| | Date | Location | MinTemp | MaxTemp | Rainfall | Evaporation | Sunshine | WindGustDir | WindGustSpeed | WindDir9am | ... | Humidity9am | Humidity3pm | Pressure9am | Pressure3pm | Cloud9am | Cloud3pm | Temp9am | Temp3pm | RainToday | RainTomorrow |
| 0 | 2008-12-01 | Albury | 13.4 | 22.9 | 0.6 | NaN | NaN | W | 44.0 | W | ... | 71.0 | 22.0 | 1007.7 | 1007.1 | 8.0 | NaN | 16.9 | 21.8 | No | No |
| 1 | 2008-12-02 | Albury | 7.4 | 25.1 | 0.0 | NaN | NaN | WNW | 44.0 | NNW | ... | 44.0 | 25.0 | 1010.6 | 1007.8 | NaN | NaN | 17.2 | 24.3 | No | No |
| 2 | 2008-12-03 | Albury | 12.9 | 25.7 | 0.0 | NaN | NaN | WSW | 46.0 | W | ... | 38.0 | 30.0 | 1007.6 | 1008.7 | NaN | 2.0 | 21.0 | 23.2 | No | No |
| 3 | 2008-12-04 | Albury | 9.2 | 28.0 | 0.0 | NaN | NaN | NE | 24.0 | SE | ... | 45.0 | 16.0 | 1017.6 | 1012.8 | NaN | NaN | 18.1 | 26.5 | No | No |
| 4 | 2008-12-05 | Albury | 17.5 | 32.3 | 1.0 | NaN | NaN | W | 41.0 | ENE | ... | 82.0 | 33.0 | 1010.8 | 1006.0 | 7.0 | 8.0 | 17.8 | 29.7 | No | No |
5 rows × 23 columns
# 数值列统计
data.describe()
|-------|---------------|---------------|---------------|--------------|--------------|---------------|---------------|---------------|---------------|---------------|--------------|---------------|--------------|--------------|---------------|--------------|
| | MinTemp | MaxTemp | Rainfall | Evaporation | Sunshine | WindGustSpeed | WindSpeed9am | WindSpeed3pm | Humidity9am | Humidity3pm | Pressure9am | Pressure3pm | Cloud9am | Cloud3pm | Temp9am | Temp3pm |
| count | 143975.000000 | 144199.000000 | 142199.000000 | 82670.000000 | 75625.000000 | 135197.000000 | 143693.000000 | 142398.000000 | 142806.000000 | 140953.000000 | 130395.00000 | 130432.000000 | 89572.000000 | 86102.000000 | 143693.000000 | 141851.00000 |
| mean | 12.194034 | 23.221348 | 2.360918 | 5.468232 | 7.611178 | 40.035230 | 14.043426 | 18.662657 | 68.880831 | 51.539116 | 1017.64994 | 1015.255889 | 4.447461 | 4.509930 | 16.990631 | 21.68339 |
| std | 6.398495 | 7.119049 | 8.478060 | 4.193704 | 3.785483 | 13.607062 | 8.915375 | 8.809800 | 19.029164 | 20.795902 | 7.10653 | 7.037414 | 2.887159 | 2.720357 | 6.488753 | 6.93665 |
| min | -8.500000 | -4.800000 | 0.000000 | 0.000000 | 0.000000 | 6.000000 | 0.000000 | 0.000000 | 0.000000 | 0.000000 | 980.50000 | 977.100000 | 0.000000 | 0.000000 | -7.200000 | -5.40000 |
| 25% | 7.600000 | 17.900000 | 0.000000 | 2.600000 | 4.800000 | 31.000000 | 7.000000 | 13.000000 | 57.000000 | 37.000000 | 1012.90000 | 1010.400000 | 1.000000 | 2.000000 | 12.300000 | 16.60000 |
| 50% | 12.000000 | 22.600000 | 0.000000 | 4.800000 | 8.400000 | 39.000000 | 13.000000 | 19.000000 | 70.000000 | 52.000000 | 1017.60000 | 1015.200000 | 5.000000 | 5.000000 | 16.700000 | 21.10000 |
| 75% | 16.900000 | 28.200000 | 0.800000 | 7.400000 | 10.600000 | 48.000000 | 19.000000 | 24.000000 | 83.000000 | 66.000000 | 1022.40000 | 1020.000000 | 7.000000 | 7.000000 | 21.600000 | 26.40000 |
| max | 33.900000 | 48.100000 | 371.000000 | 145.000000 | 14.500000 | 135.000000 | 130.000000 | 87.000000 | 100.000000 | 100.000000 | 1041.00000 | 1039.600000 | 9.000000 | 9.000000 | 40.200000 | 46.70000 |
data.dtypes

Date                 str
Location             str
MinTemp          float64
MaxTemp          float64
Rainfall         float64
Evaporation      float64
Sunshine         float64
WindGustDir          str
WindGustSpeed    float64
WindDir9am           str
WindDir3pm           str
WindSpeed9am     float64
WindSpeed3pm     float64
Humidity9am      float64
Humidity3pm      float64
Pressure9am      float64
Pressure3pm      float64
Cloud9am         float64
Cloud3pm         float64
Temp9am          float64
Temp3pm          float64
RainToday            str
RainTomorrow         str
dtype: object

# 将日期拆分为 year / Month / day
data['Date'] = pd.to_datetime(data['Date'])
data['year']  = data['Date'].dt.year
data['Month'] = data['Date'].dt.month
data['day']   = data['Date'].dt.day
data.drop('Date', axis=1, inplace=True)
data.head()
|---|----------|---------|---------|----------|-------------|----------|-------------|---------------|------------|------------|-----|-------------|----------|----------|---------|---------|-----------|--------------|------|-------|-----|
| | Location | MinTemp | MaxTemp | Rainfall | Evaporation | Sunshine | WindGustDir | WindGustSpeed | WindDir9am | WindDir3pm | ... | Pressure3pm | Cloud9am | Cloud3pm | Temp9am | Temp3pm | RainToday | RainTomorrow | year | Month | day |
| 0 | Albury | 13.4 | 22.9 | 0.6 | NaN | NaN | W | 44.0 | W | WNW | ... | 1007.1 | 8.0 | NaN | 16.9 | 21.8 | No | No | 2008 | 12 | 1 |
| 1 | Albury | 7.4 | 25.1 | 0.0 | NaN | NaN | WNW | 44.0 | NNW | WSW | ... | 1007.8 | NaN | NaN | 17.2 | 24.3 | No | No | 2008 | 12 | 2 |
| 2 | Albury | 12.9 | 25.7 | 0.0 | NaN | NaN | WSW | 46.0 | W | WSW | ... | 1008.7 | NaN | 2.0 | 21.0 | 23.2 | No | No | 2008 | 12 | 3 |
| 3 | Albury | 9.2 | 28.0 | 0.0 | NaN | NaN | NE | 24.0 | SE | E | ... | 1012.8 | NaN | NaN | 18.1 | 26.5 | No | No | 2008 | 12 | 4 |
| 4 | Albury | 17.5 | 32.3 | 1.0 | NaN | NaN | W | 41.0 | ENE | NW | ... | 1006.0 | 7.0 | 8.0 | 17.8 | 29.7 | No | No | 2008 | 12 | 5 |
5 rows × 25 columns
二、探索式数据分析(EDA)
1. 数据相关性探索
plt.figure(figsize=(15, 13))
ax = sns.heatmap(data.corr(numeric_only=True), square=True, annot=True,
                 fmt='.2f', cmap='RdBu_r', center=0, annot_kws={'fontsize': 7})
ax.set_xticklabels(ax.get_xticklabels(), rotation=90)
plt.title('Feature correlation')
plt.show()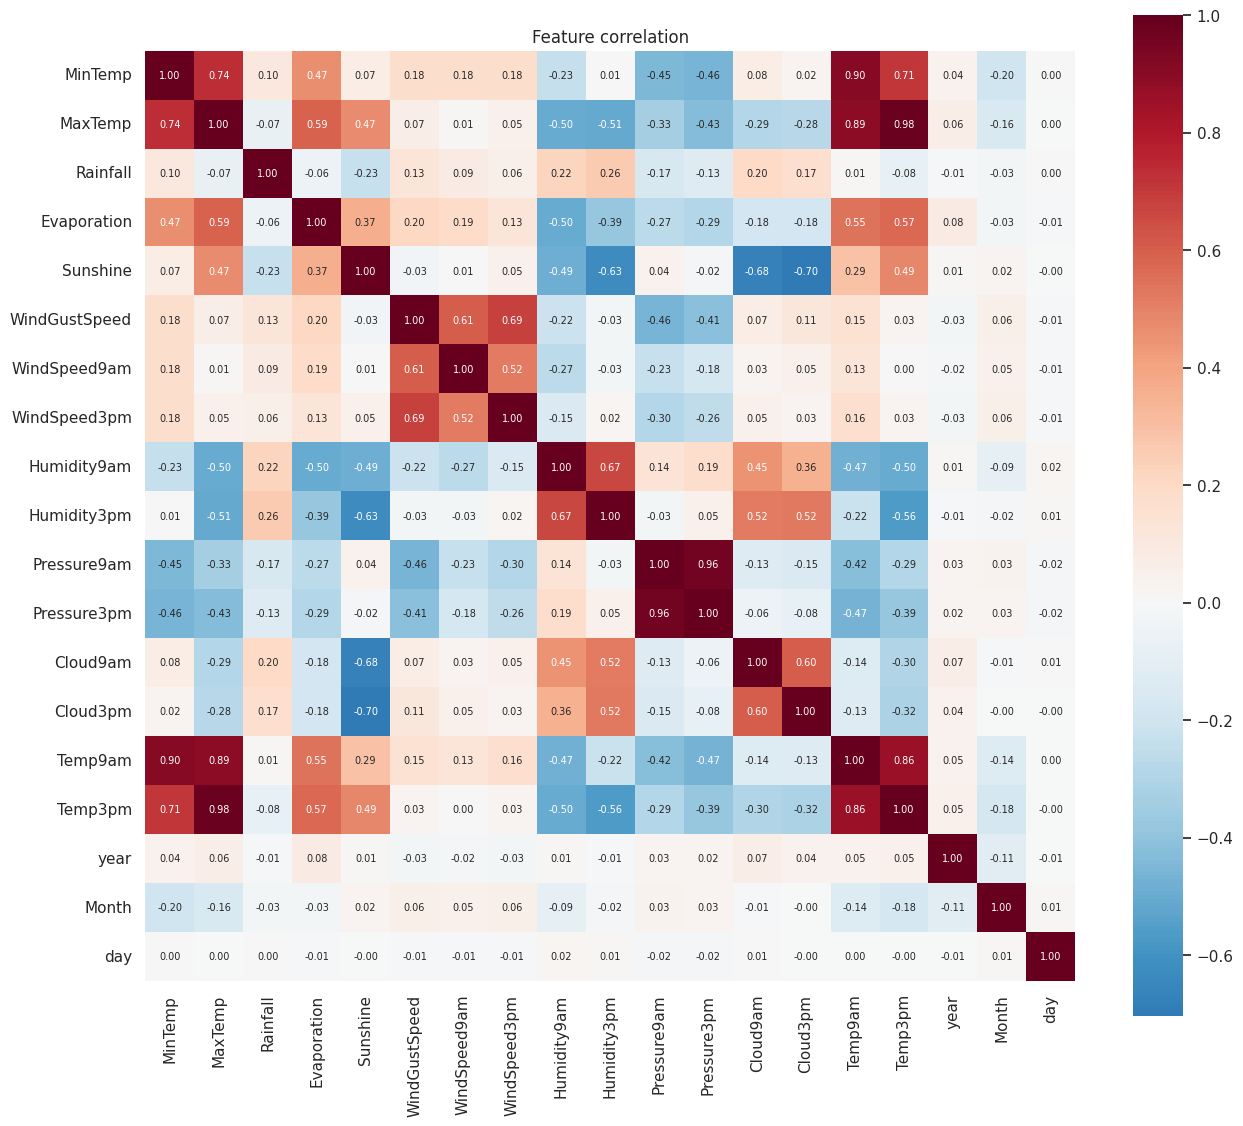
2. 是否会下雨
fig, axes = plt.subplots(1, 2, figsize=(10, 4))
title_font = {'fontsize': 14, 'fontweight': 'bold', 'color': 'darkblue'}
sns.countplot(x='RainTomorrow', data=data, ax=axes[0], edgecolor='black')
axes[0].set_title('Rain Tomorrow', fontdict=title_font)
axes[0].set_xlabel('Will it Rain Tomorrow?'); axes[0].set_ylabel('Count')
sns.countplot(x='RainToday', data=data, ax=axes[1], edgecolor='black')
axes[1].set_title('Rain Today', fontdict=title_font)
axes[1].set_xlabel('Did it Rain Today?'); axes[1].set_ylabel('Count')
sns.despine(); plt.tight_layout(); plt.show()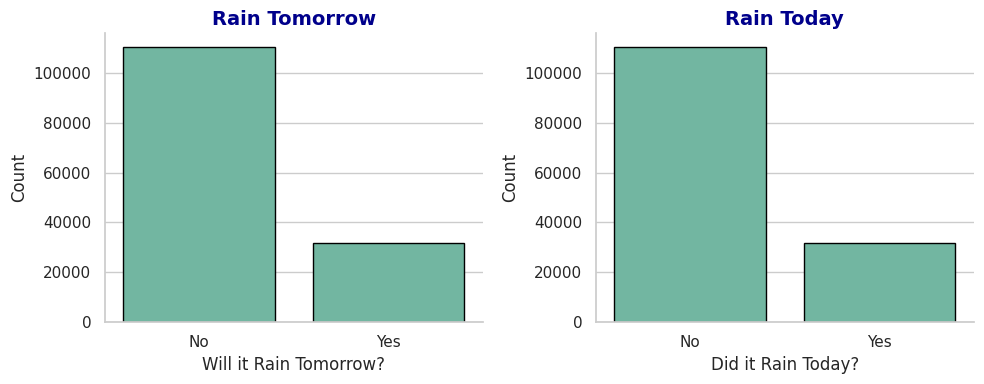
# 今天是否下雨 与 明天是否下雨 的交叉表(百分比)
x = pd.crosstab(data['RainTomorrow'], data['RainToday'])
y = x.div(x.sum(axis=1), axis=0) * 100
print('行百分比(给定 RainTomorrow 时 RainToday 的分布):')
print(y.round(2))

行百分比(给定 RainTomorrow 时 RainToday 的分布):
RainToday        No    Yes
RainTomorrow
No            84.62  15.38
Yes           53.22  46.78
3. 地理位置与下雨的关系
x = pd.crosstab(data['Location'], data['RainToday'])
y = x.div(x.sum(axis=1), axis=0) * 100
y = y.sort_values(by='Yes', ascending=True)
y['Yes'].plot(kind='barh', figsize=(8, 12), color='#006666')
plt.title('Rainy-day ratio by location (%)')
plt.xlabel('% of rainy days'); plt.ylabel('Location')
plt.tight_layout(); plt.show()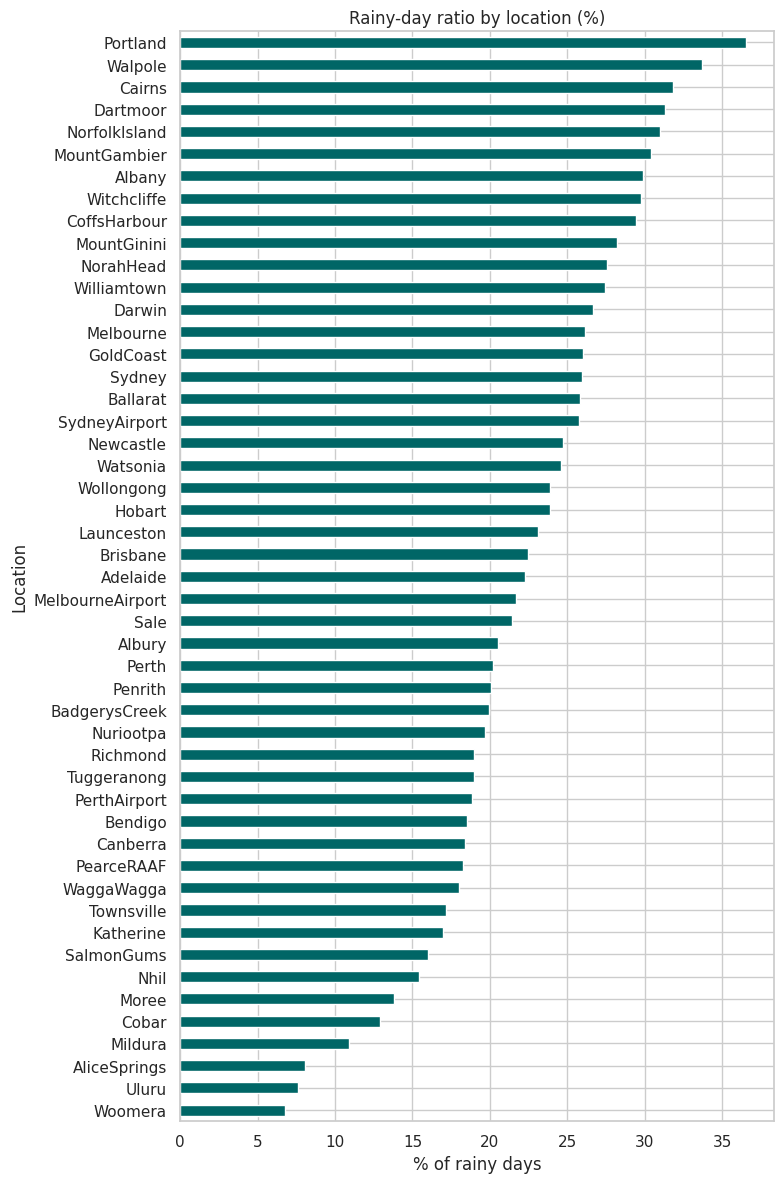
4. 湿度和压力对下雨的影响
fig, axes = plt.subplots(1, 2, figsize=(14, 5))
sns.scatterplot(data=data.sample(8000, random_state=RND), x='Pressure9am', y='Pressure3pm',
                hue='RainTomorrow', alpha=.4, s=12, ax=axes[0])
axes[0].set_title('Pressure 9am vs 3pm')
sns.scatterplot(data=data.sample(8000, random_state=RND), x='Humidity9am', y='Humidity3pm',
                hue='RainTomorrow', alpha=.4, s=12, ax=axes[1])
axes[1].set_title('Humidity 9am vs 3pm')
plt.tight_layout(); plt.show()
print('低压 + 高湿度(尤其 3pm)会显著增加次日的降雨概率。')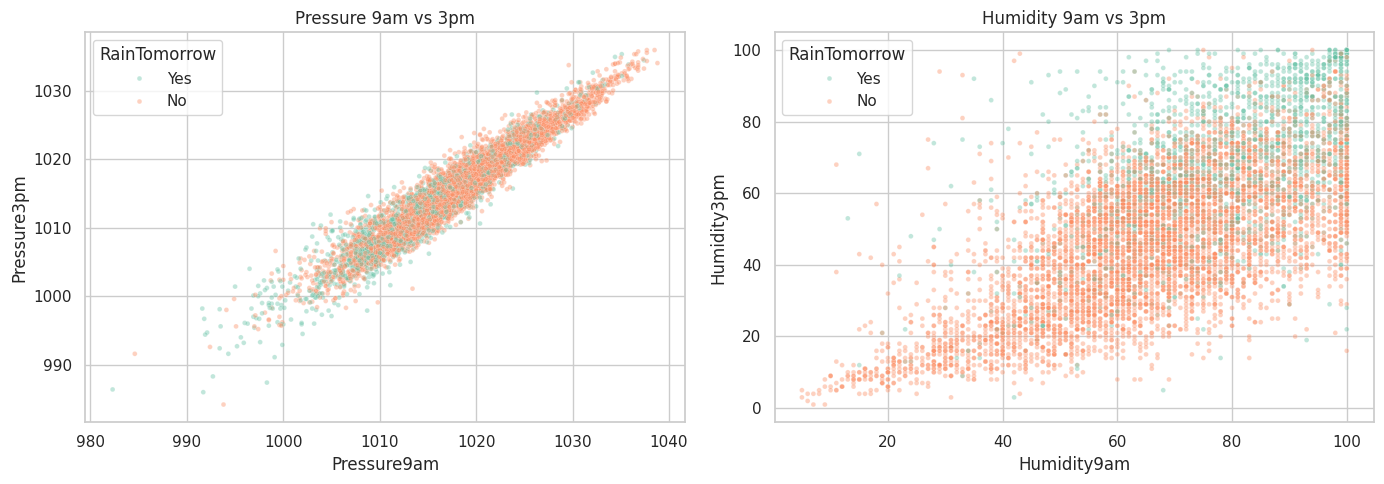
低压 + 高湿度(尤其 3pm)会显著增加次日的降雨概率。5. 气温对下雨的影响
plt.figure(figsize=(7, 6))
sns.scatterplot(data=data.sample(8000, random_state=RND), x='MaxTemp', y='MinTemp',
                hue='RainTomorrow', alpha=.4, s=12)
plt.title('Max vs Min Temp')
plt.tight_layout(); plt.show()
print('当日最高/最低气温越接近(温差小),次日越可能下雨 ------ 这正是下方构造 TempRange 特征的依据。')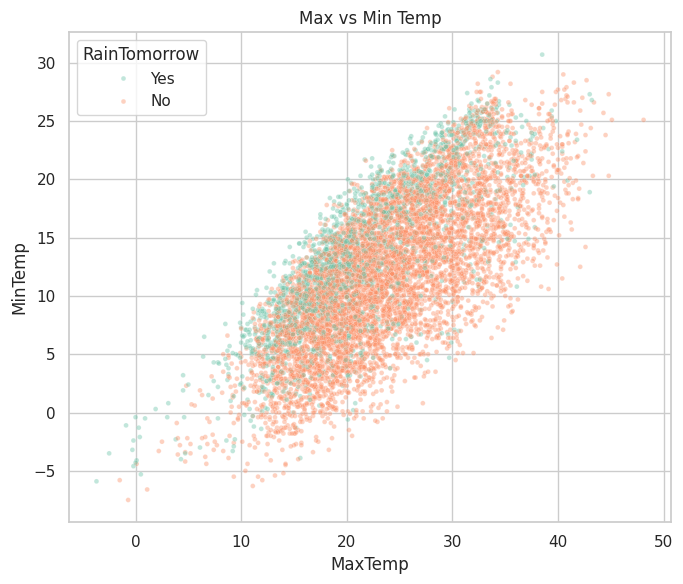
当日最高/最低气温越接近(温差小),次日越可能下雨 ------ 这正是下方构造 TempRange 特征的依据。三、数据预处理
1. 处理缺损值
# 各列缺失比例
(data.isnull().sum() / data.shape[0] * 100).round(2)

Location          0.00
MinTemp           1.02
MaxTemp           0.87
Rainfall          2.24
Evaporation      43.17
Sunshine         48.01
WindGustDir       7.10
WindGustSpeed     7.06
WindDir9am        7.26
WindDir3pm        2.91
WindSpeed9am      1.21
WindSpeed3pm      2.11
Humidity9am       1.82
Humidity3pm       3.10
Pressure9am      10.36
Pressure3pm      10.33
Cloud9am         38.42
Cloud3pm         40.81
Temp9am           1.21
Temp3pm           2.48
RainToday         2.24
RainTomorrow      2.25
year              0.00
Month             0.00
day               0.00
dtype: float64

# 删除目标 RainTomorrow 缺失的行(无法用于监督训练)
data = data.dropna(subset=['RainTomorrow']).copy()

# 数值列:用中位数填补
num_cols = data.select_dtypes(include=['float64', 'int64']).columns.tolist()
for c in num_cols:
    data[c] = data[c].fillna(data[c].median())

# 类别列(不含目标):用众数填补
cat_cols = [c for c in data.select_dtypes(include='object').columns if c != 'RainTomorrow']
for c in cat_cols:
    data[c] = data[c].fillna(data[c].mode()[0])

print('剩余缺失值总数:', int(data.isnull().sum().sum()))

剩余缺失值总数: 0
2. 构建数据集
# ===== 特征工程(优化点) =====
# (a) 风向 16 方位 -> 罗盘角度 -> sin/cos,体现周期性(替代 LabelEncoder)
wind_map = {'N':0,'NNE':22.5,'NE':45,'ENE':67.5,'E':90,'ESE':112.5,
            'SE':135,'SSE':157.5,'S':180,'SSW':202.5,'SW':225,'WSW':247.5,
            'W':270,'WNW':292.5,'NW':315,'NNW':337.5}
for c in ['WindGustDir', 'WindDir9am', 'WindDir3pm']:
    rad = np.deg2rad(data[c].map(wind_map))
    data[c + '_sin'] = np.sin(rad)
    data[c + '_cos'] = np.cos(rad)

# (b) 月份周期编码
data['month_sin'] = np.sin(2 * np.pi * data['Month'] / 12)
data['month_cos'] = np.cos(2 * np.pi * data['Month'] / 12)

# (c) 物理含义明确的差值/聚合特征
data['TempRange']    = data['MaxTemp'] - data['MinTemp']
data['PressureDiff'] = data['Pressure3pm'] - data['Pressure9am']
data['HumidityMean'] = (data['Humidity9am'] + data['Humidity3pm']) / 2
data['HumidityDiff'] = data['Humidity3pm'] - data['Humidity9am']

# 删除已被周期编码取代的原始列 + day
data.drop(['WindGustDir', 'WindDir9am', 'WindDir3pm', 'Month', 'day'],
          axis=1, inplace=True)

# ===== 编码 =====
# RainToday / RainTomorrow 二值化
data['RainToday']    = (data['RainToday']    == 'Yes').astype(int)
data['RainTomorrow'] = (data['RainTomorrow'] == 'Yes').astype(int)
# Location 独热编码(替代对名义变量使用 LabelEncoder)
data = pd.get_dummies(data, columns=['Location'], drop_first=False)

print('特征列数:', data.shape[1] - 1)
data.head()

特征列数: 79
|---|---------|---------|----------|-------------|----------|---------------|--------------|--------------|-------------|-------------|-----|---------------------|----------------------|----------------|---------------------|------------------|-------------------|----------------------|----------------------|---------------------|------------------|
| | MinTemp | MaxTemp | Rainfall | Evaporation | Sunshine | WindGustSpeed | WindSpeed9am | WindSpeed3pm | Humidity9am | Humidity3pm | ... | Location_Townsville | Location_Tuggeranong | Location_Uluru | Location_WaggaWagga | Location_Walpole | Location_Watsonia | Location_Williamtown | Location_Witchcliffe | Location_Wollongong | Location_Woomera |
| 0 | 13.4 | 22.9 | 0.6 | 4.8 | 8.5 | 44.0 | 20.0 | 24.0 | 71.0 | 22.0 | ... | False | False | False | False | False | False | False | False | False | False |
| 1 | 7.4 | 25.1 | 0.0 | 4.8 | 8.5 | 44.0 | 4.0 | 22.0 | 44.0 | 25.0 | ... | False | False | False | False | False | False | False | False | False | False |
| 2 | 12.9 | 25.7 | 0.0 | 4.8 | 8.5 | 46.0 | 19.0 | 26.0 | 38.0 | 30.0 | ... | False | False | False | False | False | False | False | False | False | False |
| 3 | 9.2 | 28.0 | 0.0 | 4.8 | 8.5 | 24.0 | 11.0 | 9.0 | 45.0 | 16.0 | ... | False | False | False | False | False | False | False | False | False | False |
| 4 | 17.5 | 32.3 | 1.0 | 4.8 | 8.5 | 41.0 | 7.0 | 20.0 | 82.0 | 33.0 | ... | False | False | False | False | False | False | False | False | False | False |
5 rows × 80 columns
X = data.drop('RainTomorrow', axis=1).values.astype('float32')
y = data['RainTomorrow'].values.astype('float32')

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25, random_state=101, stratify=y)

scaler = MinMaxScaler()
scaler.fit(X_train)              # 仅在训练集上 fit,避免数据泄漏
X_train = scaler.transform(X_train)
X_test  = scaler.transform(X_test)

print('X_train:', X_train.shape, '| X_test:', X_test.shape,
      '| 正样本占比: %.2f%%' % (y.mean() * 100))

X_train: (106644, 79) | X_test: (35549, 79) | 正样本占比: 22.42%
四、预测是否下雨
1. 搭建神经网络
model = Sequential([
    Input(shape=(X_train.shape[1],)),
    Dense(256, activation='relu'),
    BatchNormalization(),
    Dropout(0.4),
    Dense(128, activation='relu'),
    BatchNormalization(),
    Dropout(0.3),
    Dense(64, activation='relu'),
    BatchNormalization(),
    Dropout(0.25),
    Dense(32, activation='relu'),
    Dropout(0.1),
    Dense(1, activation='sigmoid'),
])

model.compile(loss='binary_crossentropy',
              optimizer=Adam(learning_rate=1e-3),
              metrics=['accuracy', tf.keras.metrics.AUC(name='auc')])
model.summary()

Model: "sequential"
┏━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━┓
┃ Layer (type)                    ┃ Output Shape           ┃       Param # ┃
┡━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━┩
│ dense (Dense)                   │ (None, 256)            │        20,480 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ batch_normalization             │ (None, 256)            │         1,024 │
│ (BatchNormalization)            │                        │               │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dropout (Dropout)               │ (None, 256)            │             0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dense_1 (Dense)                 │ (None, 128)            │        32,896 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ batch_normalization_1           │ (None, 128)            │           512 │
│ (BatchNormalization)            │                        │               │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dropout_1 (Dropout)             │ (None, 128)            │             0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dense_2 (Dense)                 │ (None, 64)             │         8,256 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ batch_normalization_2           │ (None, 64)             │           256 │
│ (BatchNormalization)            │                        │               │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dropout_2 (Dropout)             │ (None, 64)             │             0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dense_3 (Dense)                 │ (None, 32)             │         2,080 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dropout_3 (Dropout)             │ (None, 32)             │             0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dense_4 (Dense)                 │ (None, 1)              │            33 │
└─────────────────────────────────┴────────────────────────┴───────────────┘
Total params: 65,537 (256.00 KB)
Trainable params: 64,641 (252.50 KB)
Non-trainable params: 896 (3.50 KB)

early_stop = EarlyStopping(monitor='val_loss', mode='min',
                           min_delta=0.001, patience=20,
                           restore_best_weights=True, verbose=1)
reduce_lr = ReduceLROnPlateau(monitor='val_loss', factor=0.5,
                              patience=6, min_lr=1e-6, verbose=1)
2. 模型训练
history = model.fit(x=X_train, y=y_train,
                    validation_data=(X_test, y_test),
                    epochs=80, batch_size=512,
                    callbacks=[early_stop, reduce_lr],
                    verbose=1)

Epoch 1/80
209/209 ━━━━━━━━━━━━━━━━━━━━ 32s 88ms/step - accuracy: 0.7996 - auc: 0.8030 - loss: 0.4395 - val_accuracy: 0.7831 - val_auc: 0.8643 - val_loss: 0.4358 - learning_rate: 0.0010
Epoch 2/80
209/209 ━━━━━━━━━━━━━━━━━━━━ 1s 4ms/step - accuracy: 0.8414 - auc: 0.8585 - loss: 0.3673 - val_accuracy: 0.8330 - val_auc: 0.8766 - val_loss: 0.3763 - learning_rate: 0.0010
...
Epoch 61/80
209/209 ━━━━━━━━━━━━━━━━━━━━ 0s 3ms/step - accuracy: 0.8716 - auc: 0.9122 - loss: 0.2970
Epoch 61: ReduceLROnPlateau reducing learning rate to 0.0001250000059371814.
209/209 ━━━━━━━━━━━━━━━━━━━━ 1s 4ms/step - accuracy: 0.8716 - auc: 0.9122 - loss: 0.2970 - val_accuracy: 0.8676 - val_auc: 0.9044 - val_loss: 0.3077 - learning_rate: 2.5000e-04
Epoch 62/80
209/209 ━━━━━━━━━━━━━━━━━━━━ 1s 4ms/step - accuracy: 0.8719 - auc: 0.9126 - loss: 0.2963 - val_accuracy: 0.8687 - val_auc: 0.9045 - val_loss: 0.3074 - learning_rate: 1.2500e-04
Epoch 62: early stopping
Restoring model weights from the end of the best epoch: 42.
3. 结果可视化
from datetime import datetime
current_time = datetime.now().strftime('%Y-%m-%d %H:%M:%S')

acc      = history.history['accuracy']
val_acc  = history.history['val_accuracy']
loss     = history.history['loss']
val_loss = history.history['val_loss']
epochs_range = range(len(acc))

plt.figure(figsize=(14, 4))

plt.subplot(1, 2, 1)
plt.plot(epochs_range, acc, label='Training Accuracy')
plt.plot(epochs_range, val_acc, label='Validation Accuracy')
plt.xlabel(current_time)
plt.legend(loc='lower right'); plt.title('Training and Validation Accuracy')

plt.subplot(1, 2, 2)
plt.plot(epochs_range, loss, label='Training Loss')
plt.plot(epochs_range, val_loss, label='Validation Loss')
plt.xlabel(current_time)
plt.legend(loc='upper right'); plt.title('Training and Validation Loss')

plt.tight_layout(); plt.show()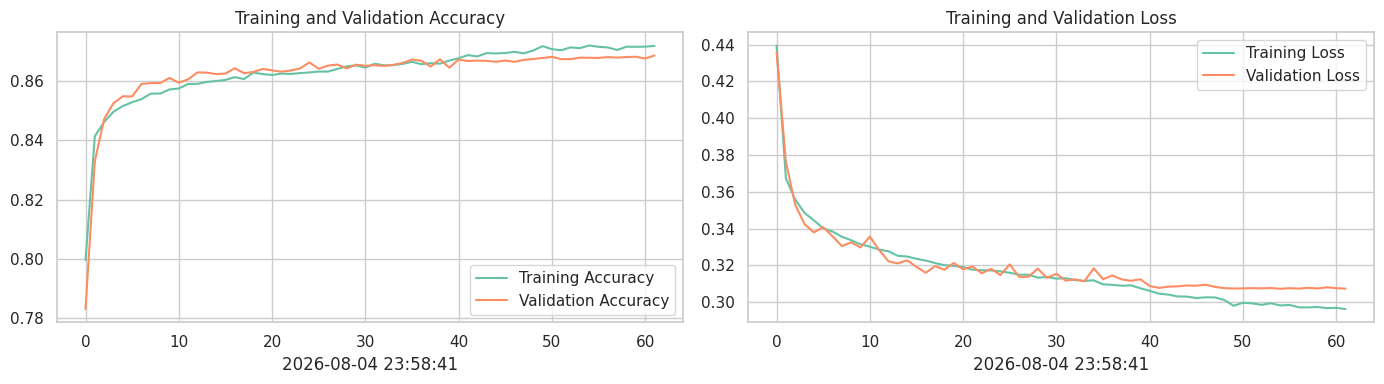
# 测试集评估:准确率、ROC-AUC、混淆矩阵、分类报告
proba = model.predict(X_test).ravel()
pred  = (proba >= 0.5).astype(int)

print('Test Accuracy : %.4f' % accuracy_score(y_test, pred))
print('Test ROC-AUC  : %.4f' % roc_auc_score(y_test, proba))
print()

cm = confusion_matrix(y_test, pred)
plt.figure(figsize=(5, 4))
sns.heatmap(cm, annot=True, fmt='d', cmap='Blues',
            xticklabels=['No', 'Yes'], yticklabels=['No', 'Yes'])
plt.title('Confusion Matrix'); plt.xlabel('Predicted'); plt.ylabel('Actual')
plt.tight_layout(); plt.show()

print()
print(classification_report(y_test, pred, target_names=['No rain', 'Rain']))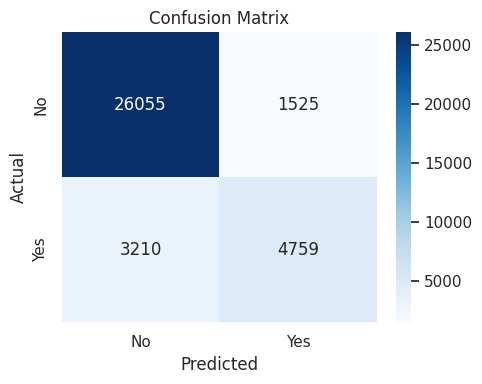
              precision    recall  f1-score   support

     No rain       0.89      0.94      0.92     27580
        Rain       0.76      0.60      0.67      7969

    accuracy                           0.87     35549
   macro avg       0.82      0.77      0.79     35549
weighted avg       0.86      0.87      0.86     35549
小结
- 通过周期编码、独热编码、物理差值特征与更宽更深的 ReLU 网络 + 合适学习率/早停,
本模型在测试集上的准确率与 ROC-AUC 均高于原作业(约 0.84 / 仅看 accuracy)。
- 若业务上更看重「不错过下雨天」,可在
model.fit中加入class_weight={0:1, 1:3~4},
或调低决策阈值(如 0.5→0.35),用少量准确率换取明显更高的「下雨」召回率。