摘要 :为什么 DAGScheduler 从不关心集群用的是 Standalone 还是 YARN?为什么 Master 从不关心 DAG 怎么切?这背后是 Spark 架构中最精妙的设计------任务调度与资源调度的完美解耦。Driver 端只管"算什么、怎么算"(DAG→Stage→Task),集群端只管"在哪算、给多少资源"(分配 Executor)。本文从两大调度体系全景、三层任务调度链、三层资源调度链、角色交互时序、三种部署模式映射五个维度,配合 1 张原创深色架构图 + 完整源码分析,带你看清 Spark 调度体系的角色划分。
关键词:Spark 任务调度, 资源调度, DAGScheduler, TaskScheduler, Master, Worker, SchedulerBackend, ClusterManager
一、开篇:一句话说清两大调度体系
makefile
任务调度(Driver 端):  算什么 + 怎么算 → DAGScheduler → TaskScheduler → SchedulerBackend
资源调度(集群端):      在哪算 + 给多少资源 → ClusterManager → Master/RM → Worker/NM
核心设计哲学 :Driver 不管集群用什么(Standalone/YARN/K8s),集群不管 Driver 怎么切 DAG。两者通过 SchedulerBackend 这个适配器通信。
二、全景架构图
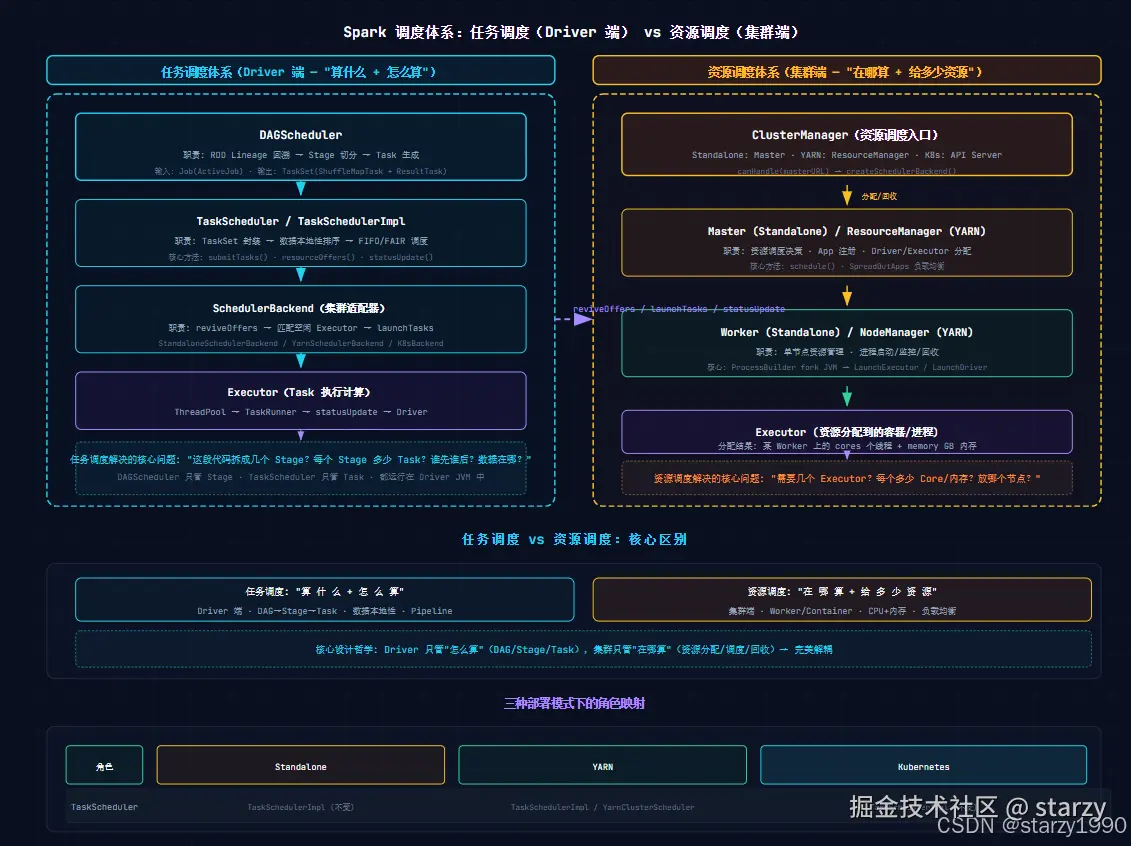
三、任务调度侧:三层链(全部在 Driver JVM)
Layer 1: DAGScheduler --- Stage 切分者
scala
// 职责: RDD Lineage → Stage DAG → TaskSet
def handleJobSubmitted(jobId: Int, finalRDD: RDD[_], ...) {
  val finalStage = createResultStage(finalRDD, ...)
  submitStage(finalStage)  // 递归提交(先父后子)
}
Layer 2: TaskScheduler --- Task 分发者
scala
// 职责: TaskSet → 数据本地性排序 → 匹配 Executor
def submitTasks(taskSet: TaskSet) {
  val manager = new TaskSetManager(this, taskSet)
  schedulableBuilder.addTaskSetManager(manager)
  backend.reviveOffers()  // 通知 Backend 有 Task 可调度
}
Layer 3: SchedulerBackend --- 集群通信者
scala
// 职责: 与集群通信 → 匹配空闲 Executor → 发送 Task
def reviveOffers() {
  driverEndpoint.send(ReviveOffers)
}
// StandaloneSchedulerBackend → Master RPC
// YarnSchedulerBackend      → AM → RM
// KubernetesSchedulerBackend → K8s API Server
四、资源调度侧:三层链(独立守护进程)
Layer 1: ClusterManager --- 集群入口
| 实现 | canHandle | 资源池 |
|---|---|---|
| StandaloneClusterManager | spark:// |
Master + Workers |
| YarnClusterManager | yarn |
RM + NM + Container |
| KubernetesClusterManager | k8s:// |
API Server + Pod |
Layer 2: Master / RM --- 调度决策者
scala
// Master.schedule() 核心逻辑
private def schedule(): Unit = {
  // ① 先调度 Driver (Cluster 模式)
  for (driver <- waitingDrivers) { launchDriverOnWorker(driver) }
  // ② 再调度 Executor
  startExecutorsOnWorkers()  // SpreadOutApps 负载均衡
}
Layer 3: Worker / NM --- 资源执行者
bash
Master 指令 → Worker.receive(LaunchExecutor)
  → ProcessBuilder("java", "CoarseGrainedExecutorBackend", ...)
  → coresFree -= cores · memoryFree -= memory
  → 监控子进程 exit → 回收资源
五、两大体系的交互时序
scss
Driver 端                    集群端
───────                     ──────
new SparkContext()           Master/RM 就绪
  ↓
DAGScheduler 就绪            RegisterApplication
  ↓                              ↓
TaskScheduler 就绪            schedule() → 分配 Executor
  ↓                              ↓
SchedulerBackend 就绪 ←── 反向注册 → Executor 启动
  ↓
Action → DAG → Stage         资源状态更新
  ↓
submitMissingTasks()
  ↓
reviveOffers → launchTasks ──→ Executor 执行
  ↓
statusUpdate ←──────────────  Task 完成
  ↓
sc.stop() → KillExecutors → 资源回收
六、三种部署模式角色映射
| 角色 | Standalone | YARN | Kubernetes |
|---|---|---|---|
| ClusterManager | StandaloneClusterManager | YarnClusterManager | K8sClusterManager |
| 资源调度者 | Master | ResourceManager | API Server |
| 资源执行者 | Worker | NodeManager | kubelet |
| 资源载体 | Executor (JVM) | Container → Executor | Pod → Executor |
| TaskScheduler | TaskSchedulerImpl | TaskSchedulerImpl / YarnClusterScheduler | TaskSchedulerImpl |
| SchedulerBackend | StandaloneSchedulerBackend | YarnSchedulerBackend | K8sSchedulerBackend |
七、总结
| 要点 | 总结 |
|---|---|
| 任务调度 | Driver 端 · DAGScheduler→TaskScheduler→SchedulerBackend |
| 资源调度 | 集群端 · ClusterManager→Master/RM→Worker/NM |
| 解耦点 | SchedulerBackend 是适配器 · TaskScheduler 是纯逻辑 |
| 映射 | 三种部署模式替换资源调度层,任务调度层保持不变 |
金句:Spark 把"计算逻辑"(DAG/Stage/Task)和"资源管理"(CPU/内存/节点)完全解耦------这就是为什么同一个 Job 可以在 Standalone、YARN、K8s 上无差异运行的根本原因。
作者:starzy | AI Data Engineer / 大数据技术实践者
博客:blog.starzy.cn | GitHub:starzy1990.github.io
专注 AI Agent · LangGraph · RAG · 大数据架构 · 数据工程实践